Wymiary strony PDF są ustalone w momencie tworzenia strony, więc nie można po prostu przeskalować zawartości w miejscu, tak jak zmienia się rozmiar obrazu. Modelem biblioteki, który czyni pomniejszanie praktycznym, jest model przechwytywania i ponownego rysowania (capture-and-redraw): przenieś zawartość każdej ze stron z dokumentu do uchwytu, stwórz nową, pustą stronę w oryginalnym rozmiarze obszaru roboczego (media size), a następnie narysuj przechwyconą zawartość z powrotem na mniejszym obszarze ograniczającym (reduced bounding box). Otaczająca to pusta przestrzeń staje się marginesem. Przy skalowaniu na poziomie 70% na stronie formatu A4, na przykład, 15% szerokości przypada na każdą stronę i taka sama część na górze i na dole, co jest dokładnie tym, co produkuje poniższa arytmetyka granic
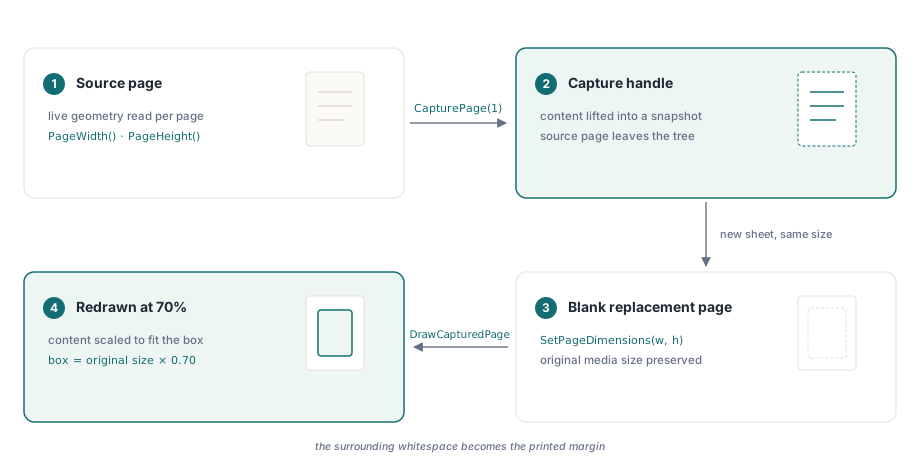
Jak działa CapturePage
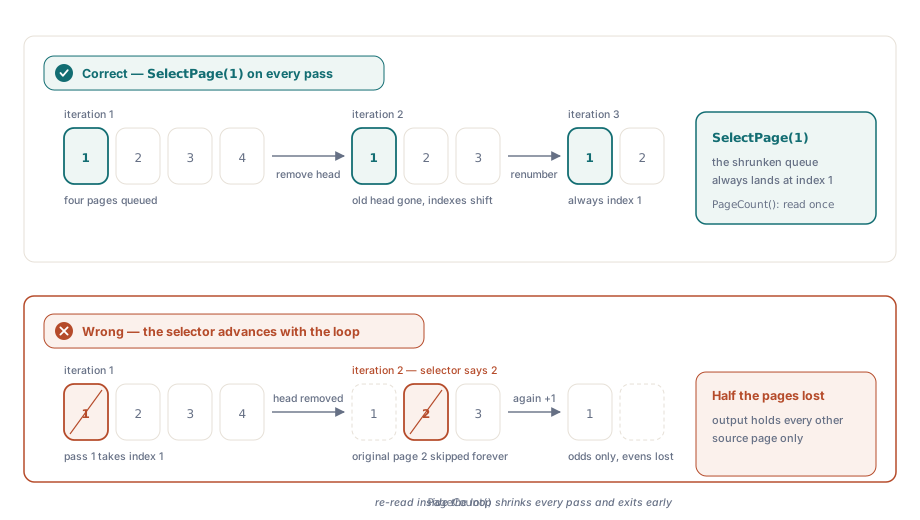
CapturePage przyjmuje numer strony, promuje jej zawartość do rezydującego w pamięci obiektu przechwytywania (capture object) i usuwa stronę z drzewa stron dokumentu. To usunięcie jest intencjonalne i jest powodem, dla którego pętla zawsze wybiera stronę 1 niezależnie od indeksu iteracji: po tym jak strona 1 zostanie przechwycona i usunięta, to co było stroną 2 staje się nową stroną 1, i tak dalej. Jeśli będziesz inkrementował selektor strony (page selector) razem z licznikiem pętli (loop counter), ominiesz co drugą stronę i skończysz z połową oczekiwanego wyniku
Uchwyt przechwytywania zwrócony przez CapturePage nie jest referencją do strony; to raczej migawka treści. Pozostaje ważny po rysowaniu, więc to samo przechwycenie można umieścić więcej niż raz, dopóki nie zwolnisz go przez ReleaseCapturedPage albo dokument nie zniknie. DrawCapturedPage bierze ten uchwyt plus prostokąt docelowy podany jako lewa krawędź, górna krawędź, szerokość i wysokość, wszystkie domyślnie w punktach. Biblioteka skaluje przechwyconą treść, by pasowała dokładnie w ten prostokąt, zachowując proporcje tylko wtedy, gdy twój prostokąt akurat odpowiada oryginalnym proporcjom. Dla skalowania jednolitego chcesz, by prostokąt był oryginalnym rozmiarem pomnożonym przez współczynnik skali, wycentrowanym na stronie
Matematyka centrowania
Przy współczynniku skali równym 70%, pozostałe 30% każdego wymiaru jest dzielone równo między dwie strony. W związku z tym wcięcie poziome to pageWidth * (1.0 - 0.70) / 2, co stanowi 15% szerokości, a wcięcie pionowe wykorzystuje tę samą formułę z użyciem wysokości strony. Docelowy prostokąt dla DrawCapturedPage zaczyna się zatem w (horizBorder, vertBorder) i rozciąga się na pageWidth - 2 * horizBorder przez pageHeight - 2 * vertBorder. Ta arytmetyka nie jest specyficzna dla biblioteki; to po prostu geometria symetrycznego wpasowania mniejszego prostokąta w większy
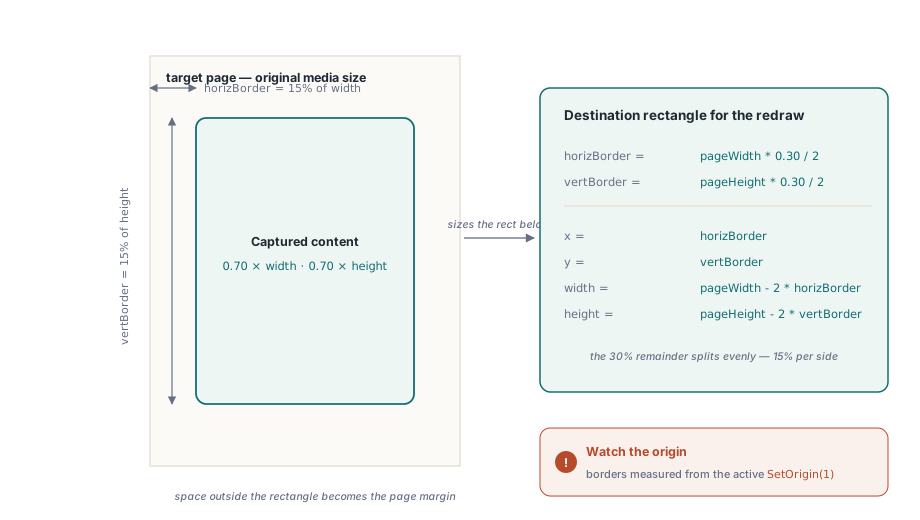
Jedna rzecz warta odnotowania: SetOrigin(1) umieszcza początek układu współrzędnych w lewym górnym rogu, a nie w lewym dolnym. Druga wartość, którą przekazujesz do DrawCapturedPage, to górna krawędź prostokąta, mierzona od tego początku, który ustawiłeś. Dlatego przykłady wołają najpierw SetOrigin(1): przy domyślnym początku w lewym dolnym rogu ten sam vertBorder posadziłby górną krawędź przy dolnym końcu strony i wypchnął większość treści poza nią
Przykład w C#
Poniższy kod przetwarza każdą stronę pliku Pages.pdf przez cykl przechwyć-i-przerysuj i zapisuje wynik do newpages.pdf. PDFL to instancja klasy importowej PDFlibrary dostarczanej z edycją DLL, tworzonej przez new PDFlibrary("PDFlibDLL64.dll"); edycja ActiveX wystawia te same metody przez PDFlibAX.PDFlibrary
private void ScalePages_Click(object sender, EventArgs e)
{
    File.Delete("newpages.pdf");

    double pageWidth, pageHeight, horizBorder, vertBorder;
    double scaleFactor = 0.70;
    int capturedPageId, ret;

    PDFL.LoadFromFile("Pages.pdf", "");
    PDFL.SetOrigin(1);

    int numPages = PDFL.PageCount();

    for (int i = 1; i <= numPages; i++)
    {
        // Zawsze wybieraj stronę 1: CapturePage usuwa stronę, więc strona 2
        // staje się stroną 1 w następnej iteracji.
        PDFL.SelectPage(1);

        pageWidth  = PDFL.PageWidth();
        pageHeight = PDFL.PageHeight();

        horizBorder = pageWidth  * (1.0 - scaleFactor) / 2;
        vertBorder  = pageHeight * (1.0 - scaleFactor) / 2;

        capturedPageId = PDFL.CapturePage(1);
        // 0 = nic nie przechwycono, np. źródło jednostronicowe: jedyna strona nie może zostać usunięta
        if (capturedPageId == 0)
            throw new InvalidOperationException("CapturePage failed on source page " + i);

        PDFL.NewPage();
        PDFL.SetPageDimensions(pageWidth, pageHeight);

        ret = PDFL.DrawCapturedPage(
            capturedPageId,
            horizBorder, vertBorder,
            pageWidth  - 2 * horizBorder,
            pageHeight - 2 * vertBorder);
        if (ret != 1)
            throw new InvalidOperationException("DrawCapturedPage failed on source page " + i);
    }

    PDFL.SaveToFile("newpages.pdf");
}
Przykład w Delphi
Wersja w Delphi używa TPDFlib bezpośrednio, a nie przez klasę importową DLL, ale sekwencja wywołań jest identyczna. Jedna praktyczna różnica to straż pliku wyjściowego: FileExists plus DeleteFile zamiast File.Delete, bo SaveToFile zawiedzie, gdy cel jest zablokowany przez poprzedni przebieg wciąż otwarty w przeglądarce
procedure TForm1.ScalePagesClick(Sender: TObject);
var
  PDFLib: TPDFlib;
  pageWidth, pageHeight, horizBorder, vertBorder: Double;
  scaleFactor: Double;
  capturedPageId, ret, numPages, i: Integer;
begin
  if FileExists('newpages.pdf') then
    DeleteFile('newpages.pdf');

  scaleFactor := 0.70;

  PDFLib := TPDFlib.Create;
  try
    PDFLib.LoadFromFile('Pages.pdf', '');
    PDFLib.SetOrigin(1);

    numPages := PDFLib.PageCount();

    for i := 1 to numPages do
    begin
      PDFLib.SelectPage(1);

      pageWidth  := PDFLib.PageWidth();
      pageHeight := PDFLib.PageHeight();

      horizBorder := pageWidth  * (1.0 - scaleFactor) / 2;
      vertBorder  := pageHeight * (1.0 - scaleFactor) / 2;

      capturedPageId := PDFLib.CapturePage(1);
      // 0 = nic nie przechwycono, np. źródło jednostronicowe: jedyna strona nie może zostać usunięta
      if capturedPageId = 0 then
        raise Exception.CreateFmt('CapturePage failed on source page %d', [i]);

      PDFLib.NewPage();
      PDFLib.SetPageDimensions(pageWidth, pageHeight);

      ret := PDFLib.DrawCapturedPage(
        capturedPageId,
        horizBorder, vertBorder,
        pageWidth  - 2 * horizBorder,
        pageHeight - 2 * vertBorder);
      if ret <> 1 then
        raise Exception.CreateFmt('DrawCapturedPage failed on source page %d', [i]);
    end;

    PDFLib.SaveToFile('newpages.pdf');
  finally
    PDFLib.Free;
  end;
end;
Co tak naprawdę kontroluje współczynnik skali
Wartość 0.70 oznacza tutaj, że wyrenderowana treść zajmuje 70% każdego wymiaru strony, a nie że plik ma 70% swojego pierwotnego rozmiaru w bajtach. Rozmiar pliku po tej operacji zależy od złożoności pierwotnej treści; strona z dużymi obrazami nie zmniejszy się proporcjonalnie, bo dane pikselowe są przerysowywane w tej samej rozdzielczości do mniejszego obszaru. Jeśli celem jest mniejszy plik, spójrz na CompressContent dla strumieni treści stron, które wyszły nieskompresowane, i na rekompresję obrazów (OptimizeImages w edycji Delphi), a nie na skalowanie geometryczne. LinearizeFile to inne narzędzie: porządkuje plik pod ładowanie strona po stronie (Fast Web View), co pomaga przeglądarkom otwierać duże pliki przez sieć, ale ich nie zmniejsza
Podana wartość 0.70 nie oznacza również twardego limitu (hard limit). Dowolna wartość od 0.0 do 1.0 zadziała poprawnie, a parametry wkraczające ponad próg 1.0 powiększą zawartość wykraczając absolutnie poza oryginalne granice u strony (original page boundary), co obetnie i dopasuje krawędzie w ramach narzuconego obszaru roboczego (media box edge), chyba że dla zrównoważenia jednocześnie po prostu odpowiednio powiększysz wymiary samej tej strony. Dokumenty o mieszanych rozmiarach stron (mixed-size documents) są obsługiwane i akceptowane tu w sposób naturalny, ponieważ atrybuty właściwości PageWidth oraz PageHeight są odpytywane oddzielnie i wyciągane bezpośrednio (queried) dla każdej pojedynczej unikalnej strony tuż wprost przed nałożonym etapem pod proces wymierzenia obliczeń przy ramce brzegowej (border calculation), więc ostateczny wygenerowany tu dokument, gdzie dla przykładu strony o numerach nieparzystych bazują na kartkach formatu A4, a te dla wartości parzystych są narzuconym do wydruku ujęciem w formacie A3, wyda prawidłowo wyśrodkowany naturalny układ wyjściowy (correctly centered output) narzucony obozem pod precyzyjne odmalowanie co do zasady precyzyjnie niezależnie w rozmiarze absolutnie na każdej jednej rzutowanej z na obozie wielkości arkusza do pod na rozmiarze strony, bez uciekania we we specjalnie wydzielone odgórnie oddzielne od nakazów bloki specjalnych uwarunkowań wyjątkowych czy w po we z z za we dodatkową specyficzną tu obsługę od przypadków (without any special casing)
Co może pójść nie tak
W praktyce ujawniają się o dziwo dwa główne tryby błędów o awariach (failure modes). Pierwszy wyłania się w naturalny sposób jako zwyczajny problem na plik wyjściowy (output file), pozostawiony jako otwarty w przeglądarce PDF z poprzedniego uruchomienia (previous run): funkcja SaveToFile zakończy się niepowodzeniem lub zapisze zero bajtów (write zero bytes) w zależności od platformy (platform), a nowy wynik nigdy nie zapisać docelowo. Widoczny w kodzie strażnik usuwający plik (file-delete guard) na górze funkcji obsługuje to dla celów deweloperskich (for development), ale w potoku produkcyjnym (production pipeline) zapis do ścieżki tymczasowej (temporary path) i zmiana nazwy (renaming) po sukcesie jest bezpieczniejsze
Druga to niezgodność liczby stron. Ponieważ CapturePage usuwa strony z dokumentu w miarę ich przetwarzania, liczbą, którą odczytasz z PageCount() przed pętlą, jest poprawne ograniczenie, przeciwko któremu iterujesz. Wołanie PageCount() wewnątrz pętli też nie pomaga: każdy przebieg usuwa jedną stronę i dopisuje jedną, więc licznik zostaje płaski i nie mówi nic o tym, ile stron źródłowych zostało. Zmienna pętli w przykładach służy tylko jako licznik pozostałych iteracji; nigdy nie służy do wyboru strony, bo strona do wybrania to zawsze 1 z powodu wyjaśnionego wcześniej
Pokazane tutaj wywołania manipulacji stroną, w tym CapturePage, DrawCapturedPage oraz SetPageDimensions, są częścią losLab PDF Library dla języków Delphi, C#, VB.NET i C++