Dwie minuty na skopiowanie trzech stron z 40-stronicowego PDF-a to nie problem dostrajania wydajności. To sygnał, że używana jest zła ścieżka API. Kiedy pierwszy raz zobaczyłem ten czas na kodzie kopiującym strony zbudowanym na HotPDF Delphi Component, instynkt podpowiadał mi, by najpierw spojrzeć na strukturę dokumentu, a na kod potem. Ta kolejność okazała się odwrócona
Co właściwie było wolne
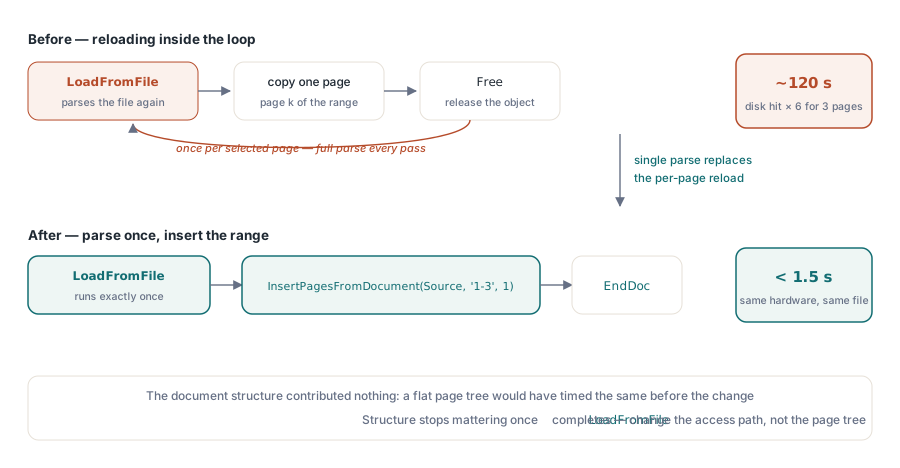
Przedmiotowy plik PDF był 40-stronicowym dokumentem referencyjnym z nietrywialnym drzewem stron: wieloma pośrednimi węzłami /Pages zamiast jednej płaskiej tablicy. Oryginalny przykładowy kod wywoływał LoadFromFile, następnie budował nowy dokument za pomocą BeginDoc, w pętli przechodził przez wybrane numery stron i przy każdej iteracji ponownie ładował dokument źródłowy z dysku, aby pobrać stronę. Jest to koszt pełnego parsowania pomnożony przez liczbę stron, które chcemy wyodrębnić. Plik o rozmiarze 12 MB uderzał w dysk sześć razy dla ekstrakcji trzech stron, ponieważ nikt nie sprawdził, czy plik musi pozostać otwarty między iteracjami
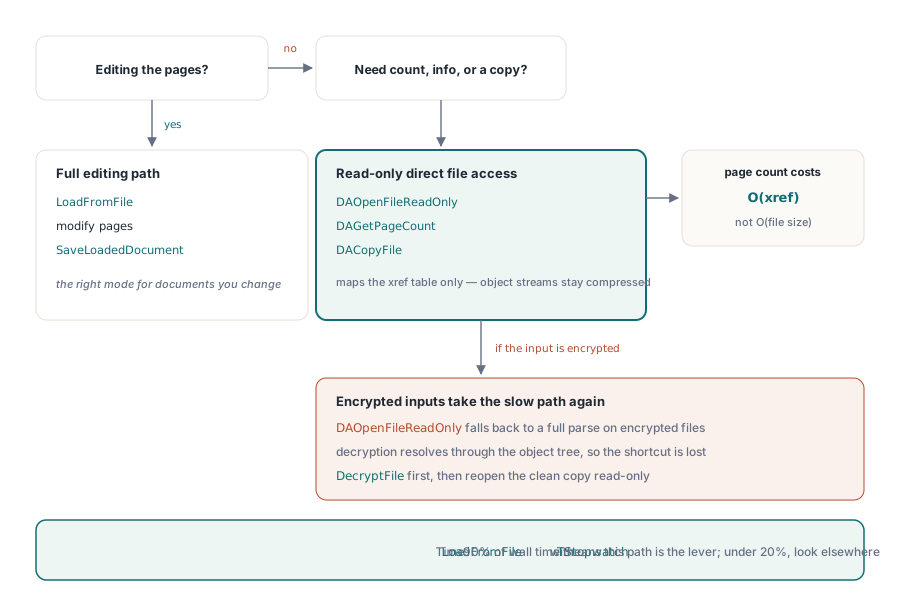
Drugą przyczyna była niewidoczna w kodzie: LoadFromFile w HotPDF buduje model obiektowy w pamięci, na którym pracuje API edycji. To właściwe zachowanie dla dokumentu, który zaraz będziesz modyfikować, ale to więcej pracy, niż potrzebujesz, gdy chcesz tylko liczbę stron i podzbiór stron. Dla odczytu struktury tylko do odczytu DAOpenFileReadOnly omija deserializację pełnego drzewa obiektów, co ma znaczenie przy skompresowanych plikach z dużymi zasobami obrazów
Obie przyczyny sprowadzają się do wybrania API zaprojektowanego do jednego zadania i użycia go do innego
Użycie ExtractPagesToFile do wyodrębniania stron
Właściwa ścieżka do skopiowania zakresu stron z wczytanego dokumentu HotPDF do nowego pliku to ExtractPagesToFile, wołane po LoadFromFile na źródle. Ładujesz źródło raz, a wywołanie buduje dokument docelowy, kopiuje do niego wybrane strony i zapisuje go na dysk — wszystko z tej kopii, która siedzi już w pamięci:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // Załaduj źródło raz: pełne parsowanie dzieje się tu i tylko tu
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // Zapisz żądany zakres ('1-3', '1,5,7-9') prosto do nowego pliku
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
Parametr PageRange przyjmuje ten sam format co przykład dla wiersza poleceń: listę numerów stron albo zakresów oddzielonych przecinkami, jak '1-3' albo '1,5,7-9'. Strony są liczone od 1. ExtractPagesToFile kopiuje każdą wybraną stronę razem ze strumieniami zawartości i zasobami, do których się odwołuje, więc przy ekstrakcji trzech stron z 40-stronicowego dokumentu zbiór roboczy pozostaje mały
Czas na tym samym pliku 12 MB, który wcześniej biegał dwie minuty: około 1,3 sekundy z tym wzorcem. Większość tego czasu to pojedyncze wywołanie LoadFromFile. Struktura dokumentu przestaje mieć znaczenie, skoro tabela obiektów została rozwiązana po raz pierwszy
Kiedy LoadFromFile to za dużo: Direct File API
Jeśli potrzebujesz jedynie policzyć strony, sprawdzić informacje o dokumencie lub skopiować plik bez ingerencji w jego zawartość, API Direct File pozwala całkowicie uniknąć pełnego parsowania. DAOpenFileReadOnly mapuje tabelę odsyłaczy (cross-reference) bez dekompresji strumieni obiektów, dzięki czemu liczenie stron charakteryzuje się złożonością O(rozmiar xref) zamiast O(rozmiar pliku):
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile to kopia zachowująca bajty, bez ponownej serializacji
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
Zastrzeżenie: DAOpenFileReadOnly akceptuje parametr z hasłem, ale w przypadku szyfrowanych plików wejściowych ucieka się do pełnego parsowania, ponieważ deszyfrowanie wymaga drzewa obiektów do rozwiązania słownika szyfrowania. Jeśli twoje pliki źródłowe są zaszyfrowane, najpierw odszyfruj je za pomocą DecryptFile, aby uzyskać jawną kopię, a następnie otwórz ją za pomocą API Direct File. Funkcja na poziomie pliku DecryptFile obiera bezpośrednią ścieżkę przepisywania przez AES-256 w przypadku standardowego szyfrowania i w przypadku dużych plików jest znacznie szybsza niż LoadFromFile, po którym następuje wywołanie SaveLoadedDocument, ponieważ nie buduje pełnego modelu obiektowego w pamięci RAM
Pamięć podczas przetwarzania dużych wsadów (batch processing)
Zadania wsadowe (batch jobs), które przetwarzają dziesiątki plików w pętli, charakteryzują się wzorcem, który wygląda poprawnie, ale kumuluje pamięć: utworzenie obiektu THotPDF wewnątrz pętli, wywołanie LoadFromFile, wykonanie pracy i wywołanie Free. Strukturalnie jest to w porządku. Problem pojawia się, gdy wewnętrzna praca alokuje obiekty pomocnicze (scratch objects), przechwytuje wyjątki (exceptions) i pozostawia te obiekty przy życiu na ścieżkach błędu. Menedżer pamięci w Delphi nie wykonuje defragmentacji, więc sto wycieków na ścieżkach błędu podczas przetwarzania wsadowego może podnieść zużycie pamięci na tyle, by spowolnić alokację dla całej reszty programu
Poprawka nie jest egzotyczna. Każdy THotPDF i każdy pośredni TStream albo TBitmap, który bierze udział w pracy z PDF, należy trzymać w bloku try/finally, w którym Free jest ostatnią instrukcją. Ustaw lokalne wskaźniki na nil przed try, żeby gałąź finally mogła bezpiecznie użyć if Assigned(x) then x.Free, gdy inicjalizacja zawiedzie w połowie. To standardowa dyscyplina własności Delphi i cała historia tej klasy problemów
Jeszcze jedna rzecz do wiedzy w kontekstach wsadowych: AddImage rejestruje każdy obraz w budowanym dokumencie, a HotPDF zdejmuje te rejestracje, gdy EndDoc kończy ten plik. Rejestr podąża za cyklem BeginDoc/EndDoc, nie za LoadFromFile, więc czysty wzorzec dla wsadu to jedna instancja THotPDF na dokument: stwórz, zrób robotę, zapisz, zwolnij
Mierzenie przed zmienianiem czegokolwiek
Zanim sięgniesz po którykolwiek z tych wzorców, zmierz. TStopwatch z System.Diagnostics w Delphi owija QueryPerformanceCounter i jest wystarczająco dokładny do profilowania wall-clock wejścia-wyjścia plikowego. Owiń samo LoadFromFile i zobacz, ile czasu zjada. Jeśli to 90% czasu całości, poprawką jest Direct File API albo zmniejszenie liczby parsowań tego samego pliku. Jeśli poniżej 20%, wąskim gardłem jest coś innego i goniisz zły ślad
Dwuminutowa ekstrakcja, która rozpoczęła ten wpis, okazała się w całości skutkiem wzorca powtarzanego ładowania. Struktura dokumentu nie wniosła nic; płaskie drzewo stron biegłoby tak samo. Przełączenie na pojedyncze LoadFromFile, po którym następuje jedno wywołanie ExtractPagesToFile, sprowadziło czas do około 1,3 sekundy na tym samym sprzęcie bez dotykania czegokolwiek innego
Pokazane tu API do manipulacji stronami jest częścią komponentu HotPDF Delphi Component dla Delphi i C++Builder