Potok przyjmowania dokumentów akceptuje pliki napisane przez obcych. Faktury, skany, załączniki z formularza webowego: każdy podaje się za PDF i niesie setki liczb, na których twój parser ma działać. Długości strumieni, wymiary obrazów, przesunięcia bajtowe, odwołania do obiektów — każdą z nich wybrał ten, kto wyprodukował plik, a obcięte wysłanie albo celowo zniekształcony dokument prędzej czy później umieści jedną z tych liczb tam, gdzie narobi szkód. Różnicą między parserem, który przeżywa taki plik, a takim, który się wywala albo działa dalej z uszkodzoną pamięcią, jest mały zestaw nawyków, niezależny od jakiejkolwiek konkretnej biblioteki PDF
Te nawyki dzielą jedno założenie: wartość odczytana z pliku to twierdzenie, a nie pomiar. Staje się użyteczna dopiero po sprawdzeniu wobec czegoś, co parser zmierzył sam — prawdziwego rozmiaru pliku, prawdziwej liczby bajtów wyprodukowanych przez dekoder, prawdziwej głębokości rekursji. Dalej opisujemy to założenie zastosowane w miejscach, w których parsery dokumentów faktycznie pękają
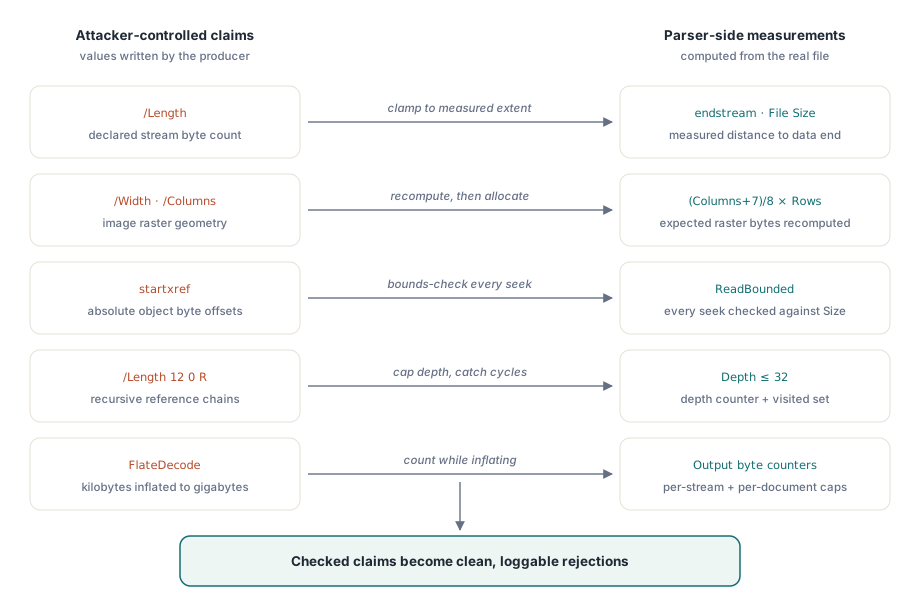
Zadeklarowana długość to twierdzenie, a nie pomiar
Najprostszą niezgodnością jest długość strumienia. Obiekt strumienia PDF deklaruje swoją liczbę bajtów w kluczu /Length, a właściwe dane siedzą pomiędzy słowami kluczowymi stream i endstream. Nic nie wymusza zgodności tych dwóch. Obcięty plik trzyma mniej prawdziwych bajtów niż zadeklarowana liczba; plik z zepsutego generatora może zadeklarować długość sięgającą poza koniec pliku albo w sąsiedni obiekt. Przydziel pamięć według zadeklarowanej wartości i kopiuj aż do endstream, a przepełnisz bufor; odczytaj dokładnie zadeklarowaną liczbę bez sprawdzania dostępności, a wyjdziesz poza koniec pliku. Pozwól zadeklarowanej wartości sterować przydziałem dopiero po przycięciu jej do zmierzonej odległości do końca danych, a niezgodność traktuj jako punkt decyzyjny — napraw, skanując w poszukiwaniu endstream, albo odrzuć strumień — nigdy jako coś, w co się po cichu wierzy
Parametry obrazu opisujące większy raster, niż przydzieliłeś
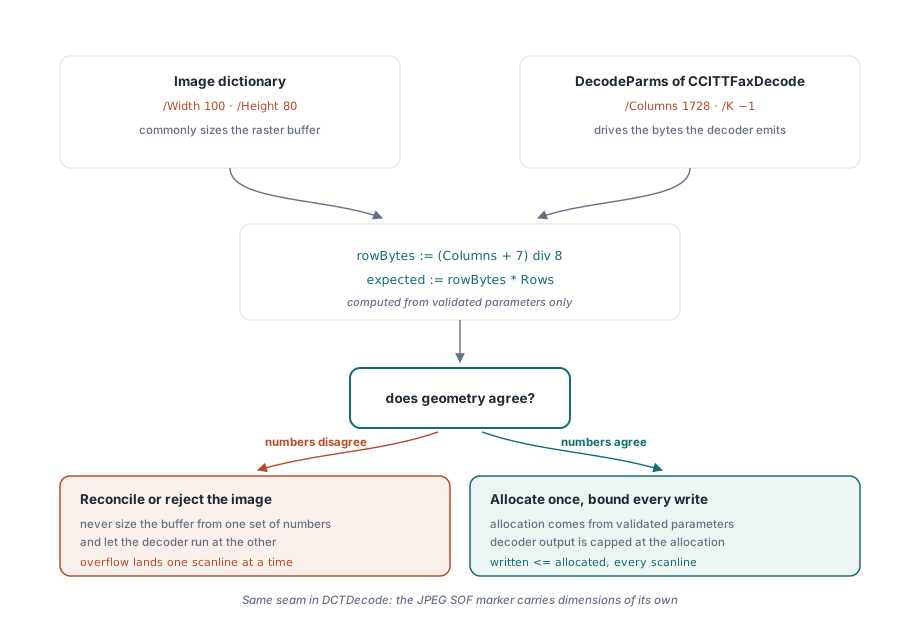
Strumienie obrazów podnoszą stawkę, bo te same piksele opisują dwa niezależne zestawy liczb. Słownik obrazu niesie /Width i /Height, a bufory rastrowe zwykle wymiaruje się z nich. Filtr dekodujący niesie własną geometrię: CCITTFaxDecode bierze /Columns, /Rows i /K ze swojego DecodeParms, gdzie /K wybiera schemat Group 3 albo Group 4, a dekoder emituje (Columns + 7) div 8 bajtów na linię skanowania. Plik, który deklaruje /Width 100, ale podaje filtrowi /Columns 1728 — wartość domyślną — sprawia, że dekoder produkuje ponad szesnaście razy więcej bajtów na wiersz, niż spodziewa się bufor, a przepełnienie ląduje po jednej linii skanowania w tym, co siedzi za przydziałem. Gdy /Rows nie ma, dekoder działa, dopóki dane nie każą mu przestać, więc ogranicz też liczbę wierszy. DCTDecode ma ten sam szew: dane JPEG niosą własną szerokość i wysokość w znaczniku SOF, a nic nie zobowiązuje ich do zgodności ze słownikiem
Reguła obronna jest mechaniczna: policz oczekiwany rozmiar rastra ze sprawdzonych parametrów dekodowania — własnych /Columns i /Rows filtra dla CCITT, wymiarów SOF dla DCT — porównaj go ze swoimi limitami, przydziel pamięć według niego i weryfikuj podczas dekodowania, że wyjście nigdy nie wybiega poza przydział. Gdy słownik i filtr nie zgadzają się co do geometrii, pogódź je albo odrzuć obraz. Czego parser nigdy nie może zrobić, to wymiarować bufor jednym zestawem liczb i pozwolić dekoderowi działać według drugiego
Pułapki arytmetyki i przydziałów w Delphi
Trzy zachowania Delphi podkopują nawet parser, który zamierza walidować. Pierwsze to mnożenie 32-bitowe: Delphi oblicza iloczyn dwóch operandów typu Integer na 32 bitach, niezależnie od szerokości miejsca docelowego, więc Width * Height * BytesPerPixel może się zawinąć, nawet gdy każdy czynnik przechodzi własną kontrolę rozsądku. Skan 30000 na 30000 przy trzech bajtach na piksel to 2,7 miliarda bajtów, co zawija się na ujemną wartość w arytmetyce 32-bitowej ze znakiem; nieco inne czynniki zawijają się na małą dodatnią długość, która przydziela zbyt mały bufor. Wymuś szerokość całego wyrażenia, rzutując pierwszy operand — Size := Int64(Width) * Height * BytesPerPixel — a potem porównaj z jawnym limitem, zanim cokolwiek dotrze do SetLength
Drugie to kontrola zakresu. Domyślna konfiguracja wydania w Delphi ma ją wyłączoną, więc indeks poza zakresem policzony z danych pliku nie zgłasza błędu — czyta albo zapisuje pamięć sąsiadującą z tablicą. Włącz ją z powrotem przez {$R+} (oraz {$Q+} dla przepełnienia arytmetycznego) na początku każdego modułu, który indeksuje wartościami pochodzącymi z pliku. Koszt jest niemierzalny obok wejścia-wyjścia, które parser i tak wykonuje, a zamienia ciche uszkodzenie w możliwy do przechwycenia ERangeError
Trzecie to TMemoryStream.SetSize z dostarczonym przez plik Int64. Na obecnym RTL przydziela dokładnie tyle, ile plik zażądał, więc pojedynczy strumień twierdzący, że ma cztery gigabajty, staje się awarią braku pamięci w środku przyjmowania. Na starszych RTL, gdzie SetSize przyjmuje Longint, wartość jest najpierw po cichu zawężana: zadeklarowane $100000010 staje się 16, przydział się udaje, a zapis prawdziwych danych biegnie daleko poza niego. Sprawdzaj każdy rozmiar wobec zmierzonego rozmiaru źródła i twardego limitu, zanim zobaczy go jakiekolwiek wywołanie przydzielające
Przesunięcia wskazujące poza plik
Tablica odniesień krzyżowych mapuje numery obiektów na bezwzględne przesunięcia bajtowe, a parser skacze tam, gdzie ona wskazuje. W pliku uszkodzonym albo wrogim te przesunięcia lądują za końcem pliku albo wewnątrz niepowiązanych struktur. TStream czyni tę awarię cichą: ustawienie Position poza Size nie jest błędem, a zwykły Read za końcem po prostu zwraca mniej bajtów, niż zażądano, więc kod pomijający sprawdzenie licznika parsuje dalej nieaktualne bajty poprzedniego obiektu. Obroną jest punkt przewężenia — jeden helper, przez który przechodzi każde sterowane plikiem przesunięcie i każdy odczyt, sprawdzający przesunięcie i licznik wobec zmierzonego rozmiaru pliku, zanim strumień się ruszy
uses
  System.SysUtils, System.Classes;

const
  MAX_OBJECT_BYTES = 64 * 1024 * 1024; // żaden obiekt nie może przekroczyć 64 MB

type
  EPdfBoundsError = class(Exception);

// Każdy sterowany plikiem skok i odczyt przechodzi tędy. Offset i Count to
// twierdzenia z pliku; Source.Size jest pomiarem, w który muszą się zmieścić.
procedure ReadBounded(Source: TStream; Offset, Count: Int64;
  var Buffer: TBytes);
begin
  if (Offset < 0) or (Count < 0) or (Count > MAX_OBJECT_BYTES) or
     (Offset > Source.Size) or (Count > Source.Size - Offset) then
    raise EPdfBoundsError.CreateFmt(
      'object extent %d+%d exceeds file size %d',
      [Offset, Count, Source.Size]);
  SetLength(Buffer, Count);
  if Count = 0 then
    Exit;
  Source.Position := Offset;
  Source.ReadBuffer(Buffer[0], Count);
end;
Przepuść przez to przesunięcia odniesień krzyżowych, zasięgi strumieni i odczyty plików osadzonych, a złe przesunięcie stanie się czystym odrzuceniem, które nazywa liczby, zamiast naruszeniem dostępu trzy wywołania później
Cykle i głębokość w grafie obiektów
PDF jest grafem, a nie drzewem. Każda wartość może być odwołaniem pośrednim, odwołanie może rozwiązać się do kolejnego odwołania — /Length 12 0 R, gdzie obiekt 12 trzyma 13 0 R — i nic nie powstrzymuje łańcucha przed zamknięciem się na sobie samym. Resolver, który podąża za odwołaniami naiwnie, rekursuje aż do wyczerpania natywnego stosu, a wyczerpania stosu się nie przechwytuje; ono kończy proces. Głęboko zagnieżdżone tablice i słowniki dochodzą do tego samego końca bez żadnego cyklu
Używaj dwóch zabezpieczeń razem: jawny licznik głębokości ogranicza przypadek uczciwy, choć głęboki, limitem, do którego nie zbliża się żaden legalny plik, a zbiór odwiedzonych łapie prawdziwy cykl przy drugiej wizycie, zamieniając go w precyzyjny, raportowalny błąd zamiast w przekroczenie limitu
uses
  System.SysUtils, System.Generics.Collections;

const
  MAX_RESOLVE_DEPTH = 32; // znacznie głębiej niż każdy legalny łańcuch odwołań

type
  EPdfStructureError = class(Exception);

  TPdfValueKind = (pvNull, pvNumber, pvName, pvString, pvArray,
    pvDictionary, pvStream, pvReference);

  TPdfValue = record
    Kind: TPdfValueKind;
    RefNumber: Integer; // znaczące, gdy Kind = pvReference
    // ... pola danych dla pozostałych rodzajów
  end;

// LoadObject to twoja własna procedura: wyszukuje przesunięcie xref dla
// ObjNumber, czyta obiekt przez ReadBounded i parsuje go.
function ResolveObject(ObjNumber, Depth: Integer;
  Visited: TDictionary<Integer, Boolean>): TPdfValue;
begin
  if Depth > MAX_RESOLVE_DEPTH then
    raise EPdfStructureError.Create('reference chain exceeds depth limit');
  if Visited.ContainsKey(ObjNumber) then
    raise EPdfStructureError.CreateFmt(
      'circular reference through object %d', [ObjNumber]);
  Visited.Add(ObjNumber, True);
  try
    Result := LoadObject(ObjNumber);
    if Result.Kind = pvReference then // np. /Length 12 0 R
      Result := ResolveObject(Result.RefNumber, Depth + 1, Visited);
  finally
    Visited.Remove(ObjNumber); // rodzeństwo może legalnie dzielić ten obiekt
  end;
end;
Dekompresja jest wzmacniaczem
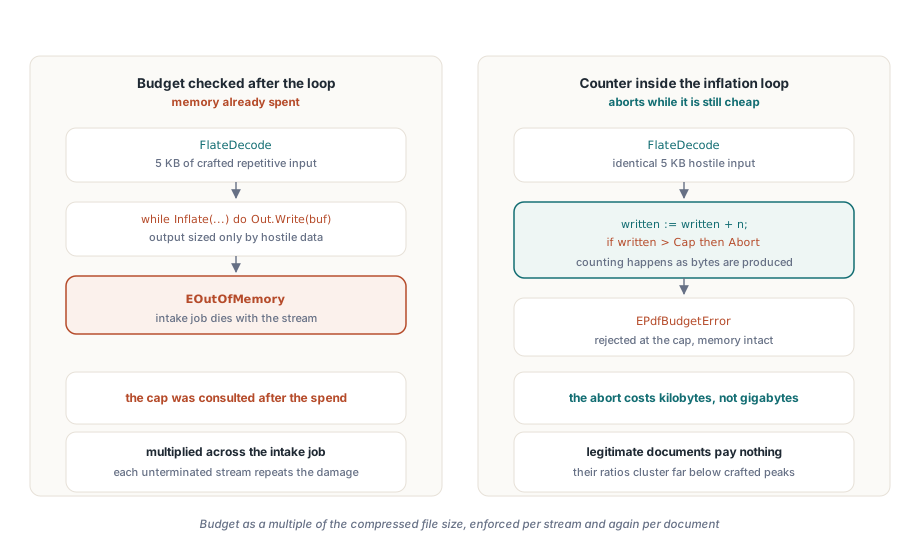
Kilka kilobajtów wejścia FlateDecode może rozprężyć się do gigabajtów; kompresja ogólnego przeznaczenia nagradza powtarzalny tekst jawny, a atakujący potrafi uczynić go maksymalnie powtarzalnym. Ogranicz rozprężony rozmiar każdego strumienia do tego, czego jego konsument może wiarygodnie potrzebować, i trzymaj drugi budżet na cały dokument: pięćset strumieni, każdy tuż pod limitem pojedynczego strumienia, wyczerpuje pamięć równie pewnie jak jeden olbrzymi strumień. Kontrola należy do wnętrza pętli rozprężania, licząc bajty wyjścia w miarę produkcji i przerywając przy naruszeniu, a nie po pętli, gdy pamięć jest już wydana. Budżet dokumentu wyrażony jako wielokrotność skompresowanego rozmiaru pliku działa dobrze, bo legalne dokumenty skupiają się daleko poniżej współczynników, jakie osiąga spreparowany strumień
Obrona w głąb poza twoimi własnymi modułami
Te same klasy defektów żyją wewnątrz bibliotek. Dwa studia przypadku na tym blogu przechodzą przez prawdziwe instancje: zawinięcia liczb całkowitych, nieograniczoną rekursję i niezainicjowane bufory zamknięte w natywnym silniku Pascala w Utwardzaniu pascalowego parsera PDF przeciw złośliwym plikom oraz zagrożenia konwencji wywołań, szerokości liczb całkowitych i własności pamięci przy wiązaniu silnika w C w Utwardzaniu wiązania PDFium Component. Dla naprawdę niezaufanego przyjmowania — publicznego formularza wysyłki, nieuwierzytelnionej skrzynki pocztowej — uruchamiaj też parsowanie i dekodowanie w osobnym procesie o niskich uprawnieniach, żeby plik, który pokona każde zabezpieczenie wewnątrz procesu, kosztował nieudane zadanie, a nie położoną usługę
Lista kontrolna przed startem
Zanim wyjdzie następna kompilacja, przejdź parser wobec tej listy: każdy bufor strumienia wymiarowany z przyciętej długości, a nie z zadeklarowanej; każdy raster wymiarowany ze sprawdzonych parametrów dekodera i skontrolowany wobec jego wyjścia; każdy iloczyn wymiarów liczony w Int64 i porównany z jawnym limitem; {$R+} aktywne w każdym module, który indeksuje wartościami z pliku; każdy skok sprawdzony wobec zmierzonego rozmiaru pliku; każde rozwiązywanie odwołań ograniczone głębokością i sprawdzone pod kątem cykli; każda pętla rozprężania licząca wyjście wobec budżetu strumienia i budżetu dokumentu. Żadna z tych kontroli nie kosztuje mierzalnego czasu na legalnym dokumencie, a każda zamienia uszkodzenie pamięci w czyste, zapisywalne w logu odrzucenie
Uwaga: losLab HotPDF Delphi Component, PDF Library for Delphi Delphi PDF Library oraz PDFium Component stosują te kontrole granic, limity głębokości i ograniczenia rozprężania wewnętrznie, więc potok przyjmowania zbudowany na nich startuje z utwardzonej linii bazowej