HotXLS zapisuje zwykłe liczbowe wartości komórek i cache formuł do XLSX z 17 cyframi znaczącymi, a przy odczycie poprawia parsowanie RTL Delphi ograniczonym, dokładnym sprawdzeniem dziesiętno-na-binary64, więc Double, który włożysz do komórki, wraca bit w bit po zapisie i ponownym otwarciu. Piętnaście cyfr, tyle ile Excel pokazuje na ekranie, nie wystarcza, by zidentyfikować wartość IEEE 754 binary64, a dziura wychodzi dokładnie tam, gdzie mieszkają kolumny finansowe i identyfikatorów: liczby całkowite ponad 1015
Błąd, który wymusił zmianę, wyglądał nieszkodliwie. Formuła arkuszowa INT(-1E15-0.1) daje -1000000000000001, całkiem reprezentowalny double. HotXLS policzył go poprawnie, zapisał do cache, zapisał plik, a cache na dysku czytał -1E15. Excel pokazałby pierwotną wartość dopiero po przeliczeniu, a każdy konsument ufający wartościom z cache, a to większość z nich, dostawał po cichu liczbę mylącą się o jeden. Nic nie wywalało, nic nie ostrzegało, a plik walidował się dobrze
Dlaczego 15 cyfr znaczących nie wystarcza dla double?
Piętnaście cyfr dziesiętnych ma gwarancję przeżycia podróży do binary64 i z powrotem, ale kierunek odwrotny potrzebuje 17. IEEE 754 binary64 ma 53-bitową mantysę, co wychodzi na od 15 do 17 cyfr dziesiętnych, zależnie od tego, gdzie siedzi wartość. Każdy napis dziesiętny o najwyżej 15 cyfrach znaczących konwertuje się na double i drukuje z powrotem bez zmian. Double natomiast potrzebuje do 17 cyfr, zanim jego zapis dziesiętny jednoznacznie go zidentyfikuje, i w zakresie ponad 253 sąsiednie double różnią się o 2, podczas gdy między 1015 a 253 różnią się o 0,125 do 1
FloatToStr Delphi formatuje z 15 cyframi znaczącymi, czyli z tą samą precyzją, jakiej Excel używa do wyświetlania. To dopasowanie to dokładnie powód, dla którego wada tak dobrze się chowa: otwórz plik w Excelu, a komórka wygląda dokładnie jak w twoim programie Delphi, bo Excel też pokazuje tylko 15 cyfr. Różnica staje się widoczna dopiero, gdy porównasz przechowany double, odejmiesz dwie bliskie wartości albo puszczę cache w coś, co robi arytmetykę. Wartość -1000000000000001 ma 16 cyfr znaczących, więc zaokrąglenie do 15 produkuje -1000000000000000 i końcowa jednostka znika na dobre
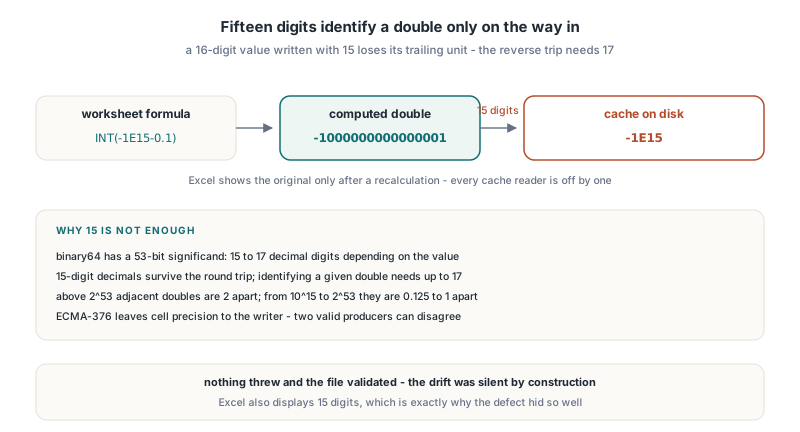
ECMA-376 Part 1 §18.3.1.96 definiuje element <v>, który niesie wartość komórki jako tekst, i nic w schemacie nie rozstrzyga, ile cyfr writer musi wyemitować dla komórki liczbowej. Precyzja to w całości odpowiedzialność writera, dlatego dwie produkujące strony mogą obie pisać ważny XLSX i wciąż się różnić co do tego, jaka liczba jest w komórce
Zapisywanie 17 cyfr znaczących z Delphi
HotXLS używa teraz jednej niezmienniki dla komórek liczbowych: FloatToStrF z ffGeneral, precyzją 17 i niezmiennymi ustawieniami formatu. Gałąź dat writera komórek używała już dokładnie tej projekcji, więc zwykłe liczby po prostu do niej dołączyły. Z zewnątrz w API nic się nie zmienia; przypisujesz Double albo formułę, zapisujesz, a token, który ląduje w <v>, jest wystarczająco precyzyjny, by odtworzyć double
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Ledger');
    Sheet.Cells[1, 1].Value := 9007199254740991.0;   // 2^53 - 1
    Sheet.Cells[2, 1].Value := -1000000000000001.0;
    Sheet.Cells[3, 1].Formula := 'INT(-1E15-0.1)';
    if Book.Recalculate <> lxOk then
      raise Exception.Create('Recalculation failed');
    // Values i cache formuły są zapisywane z 17 cyframi znaczącymi
    if Book.SaveAs('ledger.xlsx') <> lxOk then
      raise Exception.Create('Save failed');
  finally
    Book.Free;
  end;
end;
Siedemnaście cyfr to sufit, nie reguła dopełniania. ffGeneral zrzuca końcowe zera, więc 0.5 jest dalej pisane jako 0.5, a małe liczby całkowite zostają krótkie; tylko wartości, które faktycznie potrzebują dodatkowych cyfr, je dostają. Kosztem jest kilka bajtów na komórkach wcześniej ucinanych, czyli najtańsza poprawka poprawności, jaką kiedykolwiek wyślesz
Dlaczego zapis 17 cyfr wciąż gubi wartości przy odczycie?
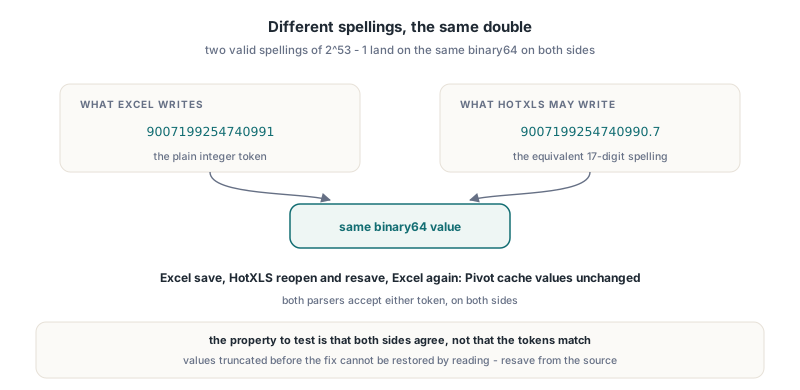
Zapisanie dość cyfr pomaga tylko, gdy czytnik przelicza je na najbliższy double, a Val z RTL nie zawsze to robi. Podczas weryfikacji RTL na maszynie testowej czytał i 9007199254740990.7, i gołą liczbę całkowitą 9007199254740991 w sąsiednią, złą wartość binary64. Oba napisy powinny lądować na 253-1; jeden to 17-cyfrowy zapis, jaki HotXLS potrafi wyprodukować, drugi to sposób, w jaki Excel pisze tę samą wartość. Writer naprawiony w izolacji wysłałby plik, którego HotXLS sam nie umiałby poprawnie przeczytać
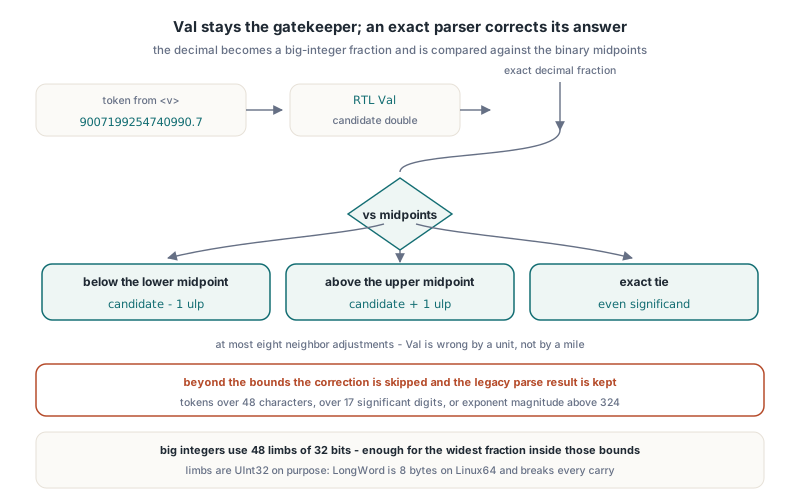
HotXLS trzyma więc Val jako strażnika i poprawia jego odpowiedź. Po tym, jak istniejąca gramatyka liczbowa przyjmie token nie-datowy, dokładny parser buduje liczbę dziesiętną jako ułamek dużych liczb całkowitych i porównuje go z binarnymi punktami środkowymi po obu stronach kandydata RTL. Jeśli liczba dziesiętna spada poniżej dolnego punktu środkowego, kandydat schodzi o jeden ulp; powyżej górnego, wchodzi; przy dokładnym remisie wygrywa parzysta mantysa, czyli reguła IEEE 754 round-to-nearest-even. Kandydat dostaje najwyżej osiem sąsiedzkich korekt, co aż nadto wystarcza, bo Val myli się o jednostkę, nie o milę
Korekta jest celowo ograniczona. Tokeny dłuższe niż 48 znaków, z więcej niż 17 cyframi znaczącymi albo z wielkością wykładnika ponad 324 omijają ją i trzymają wynik starego parsera, a każda wewnętrzna porażka cofa do tego samego. Duże liczby całkowite używają 48 kończyn po 32 bity każda, dość dla najszerszego licznika i mianownika w tych granicach. Jeden detal przenośności ma tu znaczenie: kończyny są deklarowane jawnie jako UInt32. LongWord wygląda na oczywisty wybór, ale to 8 bajtów na celu Linux64 Delphi, a typ kończyny, który po cichu podwaja szerokość, łamie każde przeniesienie i przesunięcie w arytmetyce
Weryfikacja obrotu bit w bit
Porównywanie double przez = wystarcza w tym teście, bo celem jest równość dokładna, ale porównanie wzorców bitowych czyni raport porażki użyteczniejszym: dryf o jeden ulp wychodzi jako różnica 1 w surowej wartości 64-bitowej, a nie jako dwie liczby drukujące się identycznie
function SameBits(A, B: Double): Boolean;
var
  BitsA, BitsB: UInt64;
begin
  Move(A, BitsA, SizeOf(BitsA));
  Move(B, BitsB, SizeOf(BitsB));
  Result := BitsA = BitsB;
end;

procedure CheckReopen(const FileName: string);
const
  Expected: array[1..3] of Double =
    (9007199254740991.0, -1000000000000001.0, -1000000000000001.0);
var
  Book: TXLSXWorkbook;
  Row: Integer;
  Stored: Double;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.Open(FileName) <> lxOk then
      raise Exception.Create('Open failed');
    for Row := 1 to 3 do
    begin
      Stored := Book.Sheets[1].Cells[Row, 1].Value;
      if not SameBits(Stored, Expected[Row]) then
        Writeln('row ', Row, ' drifted: ', FloatToStrF(Stored, ffGeneral, 17, 0));
    end;
  finally
    Book.Free;
  end;
end;
Wiersz 3 jest tym ciekawym. Czyta przechowany wynik INT(-1E15-0.1) bez przeliczania, więc dowodzi, że sam cache jest bezstratny, a nie że silnik formuł potrafi przeliczyć wartość. Jeśli w potoku zależysz od przechowanych wyników, osobny przewodnik po czytaniu przechowanych wartości formuł bez przeliczania opisze stany cache i czego brakującego cache nigdy się nie wymyśla
Które inne części XLSX niosą cache liczbowe?
Naprawa writera komórek zamknęła jedną ścieżkę z kilku, a każdy pozostały punkt zapisu liczbowego trzeba było sprawdzić osobno. Pierwsze wydanie pokryło wartości arkusza i cache formuł, łącznie z cache wartości wyjścia Pivot. Cache źródłowy Pivot i cache Chart wciąż przechodziły przez lej 15-cyfrowy i zostały zamknięte w dwóch wydaniach pogoni, a nie z założenia
- Cache źródłowy Pivot: wartości
sharedItemsi oba writerycacheRecords, inline i strumieniowany, używają teraz tej samej niezmienniki 17-cyfrowej, a ścieżka odczytu pivotów nakłada tę samą dokładną korektę punktów środkowych. Atrybuty opisowe, jakrefreshedDate, trzymają swoją pierwotną pisownię - Cache Chart: pojedynczy punkt zapisu budujący przechowane wartości punktów przełączył się na 17 cyfr, a sześć punktów odczytu, pokrywających wartości i kategorie trendline, walidację słupków błędów i dwie ścieżki renderowania, wszystkie idą przez jeden pomocnik dokładnego parsu
- Cała reszta liczbowego, jak szerokości kolumn i granice osi, wciąż przechodzi przez formatter defensywny, który zrzuca wartości nieskończone i subnormalne do 0, bo zserializowana część nigdy nie może zawierać floata nie do sparsowania
Najważniejsze sprawdzenie współpracy było z samym Excelem. Excel pisze 253-1 jako liczbę całkowitą 9007199254740991; HotXLS może napisać równoważny 17-cyfrowy zapis 9007199254740990.7. Oba tokeny parsują się na ten sam double po obu stronach, więc plik autorstwa Excela, otwarty ponownie i przepisany przez HotXLS, a potem otwarty znowu w Excelu, trzyma te same wartości w swoim cache Pivot. Wzajemne rozpoznanie, nie identyczna pisownia, to własność, o którą trzeba testować
Limity i przypadki brzegowe warte znajomości
Bezstratność znaczy tu, że wartość binary64 jest zachowana, a nie że każda wartość jest reprezentowalna. Wyniki nieskończone wciąż zapisują się jako błędy #NUM!, a subnormalne wciąż jako zero, dokładnie jak wcześniej. Wyświetlanie to osobna sprawa: Excel będzie dalej pokazywał 15 cyfr znaczących na ekranie, więc użytkownik wpisujący 9007199254740993 do Excela wciąż dostaje inną przechowaną wartość i żaden writer tego nie naprawi. Jeśli twój skoroszyt używa Ustaw dokładność jak wyświetlana, wartości są celowo zaokrąglane do ich formatu liczbowego, co jest przeciwieństwem tego, o czym jest ten artykuł; reguły tego trybu opisuje jak HotXLS nakłada zaokrąglanie dokładności jak wyświetlana Excela
Dokładny czytnik też nie wymienia Val; poprawia wyłącznie wartości, które Val już przyjął. Token odrzucany przez RTL jest dalej odrzucany, a token poza granicami 48 znaków, 17 cyfr i wykładnika 324 trzyma, co wyprodukował stary parser. Dla plików pisanych przez HotXLS albo Excel to nigdy nie ma znaczenia, bo żaden nie produkuje takich tokenów dla wartości komórek, ale ręcznie sklejona część XML z 40 cyframi znaczącymi jest czytana z dokładnością RTL, nie z dokładną korektą
FAQ
Czy HotXLS zmienia liczbę, którą Excel wyświetla dla komórki?
Nie. HotXLS zmienia tylko, ile cyfr idzie do przechowanego tokena <v>. Excel dalej wyświetla 15 cyfr znaczących, więc komórki wyglądają tak samo; różnica polega na tym, że leżący pod spodem double zgadza się teraz z tym, co przypisał twój kod Delphi
Dlaczego po prostu nie pisać 16 cyfr zamiast 17?
Szesnaście cyfr nie wystarcza dla każdej wartości binary64. Niektóre double potrzebują 17 cyfr znaczących, zanim ich zapis dziesiętny będzie jednoznaczny, więc writer 16-cyfrowy wciąż mapowałby dwa różne double na ten sam tekst w rzadkich przypadkach, czyli dokładnie tę klasę cichego dryfu, którą zmiana usuwa
Czy pliki zapisane przed poprawką trzeba odtworzyć?
Tylko jeśli zawierają wartości, które potrzebowały więcej niż 15 cyfr. Te tokeny straciły już swoje ostatnie cyfry na dysku, a dokładniejsze ich czytanie nie odtworzy tego, co nigdy nie zostało zapisane. Ponowny zapis z pierwotnych danych albo przeliczenie formuł i kolejny zapis produkuje dokładny plik
Siedemnastocyfrowe wyjście liczbowe, dokładna korekta odczytu binary64 i pasująca obsługa cache Pivot i Chart są częścią HotXLS Delphi Spreadsheet Component dla Delphi, C++Builder i Lazarus, który czyta i pisze XLSX bez zainstalowanego Excela ani automatyzacji OLE