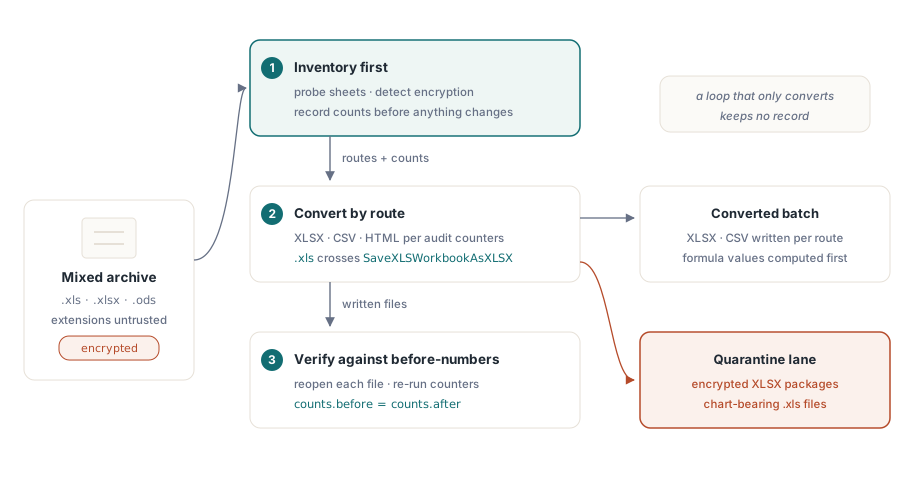
Masowa normalizacja arkuszy to trzy problemy w jednym płaszczu. Masz archiwum mieszanych formatów: .xls z ery BIFF, nowoczesne .xlsx, garść .ods z jakiegoś eksperymentu z LibreOffice i kilka plików, których nikt nie potrafi otworzyć, bo hasło odeszło razem z byłym pracownikiem. Celem jest konwersja wszystkiego do XLSX i CSV. Wersja tego zadania, którą pisze większość ludzi, to pętla otwierająca każdy plik i zapisująca go pod nowym rozszerzeniem, i działa ona dokładnie do chwili, gdy ktoś pyta, które pliki straciły wykresy, zgubiły makra albo w ogóle się nie otworzyły. Pętla nie ma odpowiedzi, bo sama konwersja nie prowadzi żadnego rejestru. Warsztat prowadzi: najpierw robi inwentaryzację, potem konwertuje, a na końcu weryfikuje, i te trzy etapy muszą dzielić się informacją, żeby cokolwiek z tego było godne zaufania
Zmontowanie takiego warsztatu w Delphi albo C++Builder oznacza spięcie czterech możliwości HotXLS, z których żadna nie wymaga zainstalowanego Excela w jakimkolwiek punkcie potoku. Są dwa natywne silniki: fasada BIFF8 dla .xls i fasada OOXML dla .xlsx oraz .ods. Są tanie wywołania sondujące, które czytają metadane bez parsowania całego pliku. Są liczniki audytu na poziomie arkusza, które mówią, co skoroszyt naprawdę zawiera. I jest macierz konwersji z udokumentowanym profilem wierności dla każdej trasy. Cała robota polega na wiedzy, gdzie każde z tych narzędzi ma ostrą krawędź, bo ma ją każde, a te krawędzie to dokładnie te rzeczy, które zamieniają czystą nocną wsadówkę w poniedziałkowy incydent
Sonduj, zanim wczytasz: nazwy arkuszy i wykrywanie szyfrowania
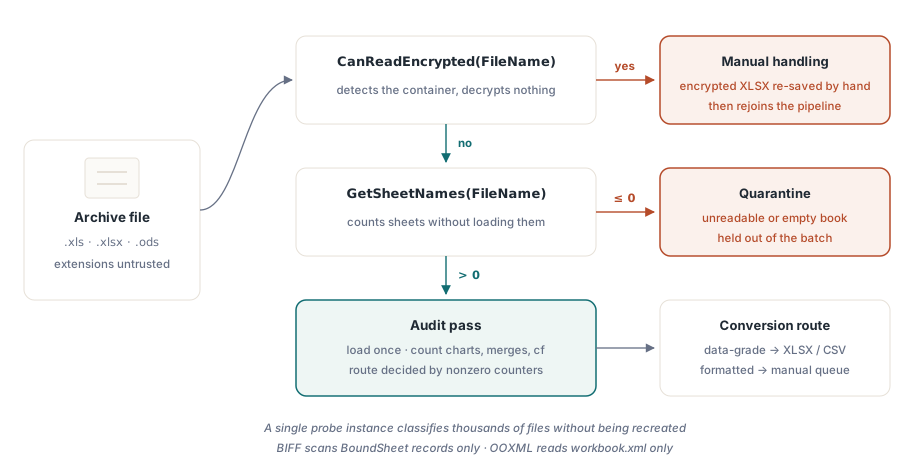
Otwieranie skoroszytu o rozmiarze 200 MB tylko po to, by odkryć, że jest zaszyfrowany, marnuje minuty na plik, a pomnożone przez duże archiwum marnuje dni. Obie fasady udostępniają GetSheetNames, które czyta metadane arkuszy bez zapełniania skoroszytu. Implementacja BIFF skanuje wyłącznie rekordy BoundSheet na początku strumienia; implementacja OOXML czyta wyłącznie workbook.xml wewnątrz archiwum zip. Obok niej CanReadEncrypted wykrywa kontener szyfrowania bez próby deszyfrowania:
var
  Probe: TXLSXWorkbook;
  Names: TStringList;
begin
  Names := TStringList.Create;
  Probe := TXLSXWorkbook.Create;
  try
    if Probe.CanReadEncrypted(FileName) then
    begin
      Writeln(FileName + ': encrypted container - route to manual handling');
      Exit;
    end;
    if Probe.GetSheetNames(FileName, Names) <= 0 then
      Writeln(FileName + ': unreadable - quarantine')
    else
      Writeln(Format('%s: %d sheet(s), first "%s"',
        [FileName, Names.Count, Names[0]]));
  finally
    Probe.Free;
    Names.Free;
  end;
end;
Dwa szczegóły operacyjne czynią tę pętlę tanią. GetSheetNames nie resetuje ani nie zapełnia instancji skoroszytu, więc jeden obiekt sondujący potrafi sklasyfikować tysiące plików bez tworzenia go od nowa. A wersja tego samego wywołania z fasady XLS rozumie też pakiety .xlsx, co czyni ją wygodną pojedynczą sondą, gdy rozszerzeniom plików nie można ufać, a w tak starym archiwum rzadko można. Segregacja przed wczytaniem zasługuje na własne omówienie; mechanika lekkiej inspekcji jest w naszym artykule o wypisywaniu arkuszy i lekkiej inspekcji skoroszytu
Liczenie tego, co skoroszyt naprawdę zawiera
Gdy plik przejdzie segregację, przebieg audytu decyduje o jego trasie konwersji. Fasada XLSX udostępnia licznik dla każdej rodziny funkcji, która waży na decyzji o wierności: scalone komórki, wykresy, obrazy, formaty warunkowe, reguły poprawności danych, tabele, hiperłącza i komentarze, plus flagi na poziomie skoroszytu dla makr, ochrony i formatu źródłowego. Trasa konwersji pliku zależy niemal wyłącznie od tego, które z nich wracają niezerowe
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  I: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.Open(FileName) <> 1 then Exit;
    for I := 0 to Book.Sheets.Count - 1 do
    begin
      Sheet := Book.Sheets[I];
      Writeln(Format('%s: cells=%d merges=%d charts=%d cf=%d dv=%d protected=%s',
        [Sheet.Name, Sheet.Cells.Count, Sheet.MergedCells.Count,
         Sheet.Charts.Count, Sheet.ConditionalFormats.Count,
         Sheet.DataValidations.Count, BoolToStr(Sheet.IsProtected, True)]));
    end;
    if Book.HasVbaProject then
      Writeln('  contains VBA project - macro policy applies');
    if Book.ExternalLinks.Count > 0 then
      Writeln(Format('  %d external link(s)', [Book.ExternalLinks.Count]));
  finally
    Book.Free;
  end;
end;
Czytaj Cells.Count z jednym zastrzeżeniem w głowie. Magazyn komórek jest rzadki, więc liczba zlicza komórki utworzone, a nie prostokątny obszar użytego zakresu. Arkusz z jedną wartością w A1 i drugą w ZZ9999 raportuje dwie komórki, a nie milion z okładem, które leżą pomiędzy. Odpowiednik tego skanu po stronie BIFF używa granic UsedRange razem z ForEachCell i niesie przesunięcie o jeden, na którym przy pierwszym podejściu potyka się prawie każdy: UsedRange.FirstRow i jego rodzeństwo liczone są od zera, podczas gdy Cells.Item[Row, Col] liczone jest od jedynki. Przejście, które zapomni dodać jedynkę do każdej granicy, audytuje niewłaściwy prostokąt i nigdy o tym nie mówi
Dwie dźwignie obniżają koszt przebiegu wyłącznie audytowego nad dużymi, starymi plikami. Ustawienie _DisableGraphics na prawdę przed otwarciem .xls pomija w całości parsowanie warstwy rysunkowej OfficeArt, co oszczędza realny czas na skoroszytach gęstych od kształtów. Jest to jednak wyłącznie optymalizacja do odczytu: zapis z instancji otwartej w ten sposób upuściłby rysunki, których nigdy nie sparsowano, więc ta flaga należy tylko do ścieżek, które nigdy nie zapiszą pliku z powrotem. Gdy audyt potrzebuje zawartości komórek, a nie liczników, callback ForEachCell obchodzi zapełnione komórki bezpośrednio i omija narzut Variant płacony przy każdym dostępie przez indeksowane właściwości komórek, a ten narzut szybko się sumuje przez miliony komórek
Znormalizuj niespójne kody powrotu wcześnie
Wywołania wejścia-wyjścia w HotXLS raportują błędy przez wyniki całkowite, a nie przez wyjątki, i konwencje nie są jednolite w całym API. Większość wywołań otwarcia i zapisu zwraca 1 przy powodzeniu i -1 przy niepowodzeniu. GetSheetNames zwraca liczbę arkuszy albo -1 z wyczyszczoną listą. XLSX-owe SaveAsHTML znów łamie wzorzec i zwraca 0 przy powodzeniu, a -1 przy indeksie arkusza poza zakresem. Warsztat, który wszędzie testuje = 1, po cichu źle sklasyfikuje wywołania sygnalizujące powodzenie inaczej, a taki, który testuje <> -1, połknie te, które zawodzą z innym kodem
Reguła, która przeżywa zetknięcie z całym API, jest węższa, niż wygląda: traktuj <= 0 jako niepowodzenie dla wywołań zwracających liczniki, sprawdzaj udokumentowaną wartość powodzenia dla każdej procedury zapisu, której faktycznie używasz, i schowaj jedno i drugie za małą funkcją sprawdzającą wynik, żeby konwencja mieszkała w dokładnie jednym miejscu. Potoki wsadowe zawodzą znacznie częściej przez powolne piętrzenie się niesprawdzonych kodów powrotu niż przez jakikolwiek egzotyczny błąd parsera, a koszt pomyłki widać czterdzieści tysięcy plików później, gdy nikt już nie pamięta, które konwersje faktycznie się udały
Macierz konwersji i to, gdzie każda droga traci dane
Obie fasady dzielą między siebie pracę konwersyjną. TXLSXWorkbook otwiera XLSX, ODS i CSV, a zapisuje XLSX, ODS, CSV, HTML, RTF oraz XLSX szyfrowany AES. TXLSWorkbook otwiera i zapisuje BIFF oraz eksportuje HTML, RTF i CSV. Przydatne jest to, że każda ścieżka niesie udokumentowany profil wierności, a nie mgliste zapewnienie o poprawności, więc możesz z wyprzedzeniem zdecydować, które trasy są bezpieczne dla których plików
Eksport CSV zapisuje UTF-8 ze znacznikiem BOM, końcami linii CRLF i cytowaniem wg RFC 4180. Czego nie robi, to nie oblicza formuł: komórka trzymająca =SUM(...) eksportuje się jako dosłowny tekst formuły, więc arkusz formuł zmienia się w arkusz ciągów, chyba że najpierw obliczysz wartości. Eksport HTML produkuje jedną tabelę, w której colspan i rowspan zastępują scalone komórki, a style bazowe są wstawione w linii. Eksport RTF ma ostrzejszą granicę: nie potrafi rozciągnąć scalonych komórek na kolumny, więc komórki kontynuacji scalenia wychodzą puste. Import ODS jest celowo lekki, wedle własnej dokumentacji biblioteki. Wartości skalarne i buforowane wyniki formuł przechodzą; style, żywe wyrażenia formuł ODF i rysunki nie. Ma to znaczenie w chwili, gdy w archiwum są prawdziwe pliki OpenDocument objęte normą OASIS ODF 1.3, gdzie cokolwiek zbliżonego do wizualnie wiernej konwersji wymaga więcej, niż ta ścieżka importu została zbudowana unieść, a to przebieg audytu mówi ci, że takie pliki istnieją, zanim wsadówka po cichu je spłaszczy
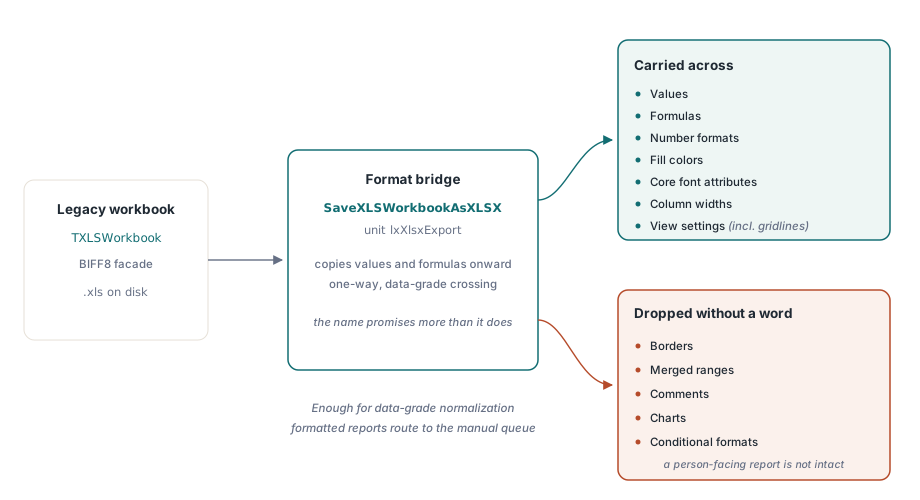
SaveXLSWorkbookAsXLSX to most dla danych, a nie dla układu
Fasada BIFF nie potrafi zapisywać OOXML bezpośrednio, więc przejście z .xls do .xlsx biegnie przez funkcję SaveXLSWorkbookAsXLSX z modułu lxXlsxExport. Wierność tego mostu warto postawić jasno, bo nazwa sugeruje więcej, niż most robi. Kopiuje wartości, formuły, formaty liczb, kolory wypełnień, podstawowe atrybuty czcionek, szerokości kolumn i ustawienia widoku, takie jak linie siatki. Nie kopiuje obramowań, zakresów scalonych, komentarzy, wykresów ani formatów warunkowych. Dla normalizacji na poziomie danych, gdzie systemy niżej w potoku będą parsować wynik i nikt nie patrzy na formatowanie, to dokładnie wystarczy i nic potrzebnego nie ginie. Dla sformatowanego raportu zarządczego, który ma czytać człowiek, to za mało, i właśnie tutaj liczniki audytu zarabiają na swoje miejsce: plik oznaczony przez audyt jako niosący wykresy i formaty warunkowe powinien trafić do kolejki ręcznej, a nie przez most, który bez słowa upuści jedno i drugie
var
  Legacy: IXLSWorkbook;        // referencja interfejsowa: nie zwalniaj
  Modern: TXLSXWorkbook;
begin
  if SameText(ExtractFileExt(FileName), '.xls') then
  begin
    Legacy := TXLSWorkbook.Create;
    if Legacy.Open(FileName) <= 0 then Exit;
    if SaveXLSWorkbookAsXLSX(Legacy,
         ChangeFileExt(FileName, '.xlsx')) <= 0 then
      Writeln('bridge failed: ' + FileName);
  end
  else
  begin
    Modern := TXLSXWorkbook.Create;
    try
      Modern.StreamingWrite := True;     // strumieniuj XML arkusza do zip
      if Modern.Open(FileName) = 1 then
        Modern.SaveAsCSV(ChangeFileExt(FileName, '.csv'), 0, ',');
    finally
      Modern.Free;
    end;
  end;
end;
Powyższa pętla pokazuje też dźwignię przepustowości po stronie OOXML. Ustawienie StreamingWrite na prawdę strumieniuje XML arkusza wprost do pakietu wyjściowego, zamiast odkładać go w pamięci jako jeden gigantyczny ciąg, a to różnica między wygodnym przebiegiem a awarią z braku pamięci, gdy pliki dobijają do setek tysięcy wierszy. Wymiarowanie i zachowanie pamięci w tym trybie mają własne omówienie w naszym artykule o zapisie strumieniowym dla serwerowych zadań wsadowych. Jeszcze jedna właściwość ma znaczenie dla wsadówki, która chce wykorzystać każdy rdzeń: żadna z fasad nie jest bezpieczna wątkowo, ale żadna też nie dzieli stanu globalnego, więc wspieranym wzorcem konwersji równoległej jest jedna instancja skoroszytu na wątek roboczy, bez blokad między nimi
Pliki z hasłem i co z nimi zrobić
Zablokowane pliki archiwum dzielą się czysto według formatu, a ten podział decyduje, dokąd trafią. Szyfrowanie starszego .xls, czy to RC4, RC4 przez CryptoAPI, czy stare zaciemnianie XOR, jest czytelne: przekaż hasło do Open, a plik konwertuje się jak każdy inny. Zaszyfrowane pakiety .xlsx to inna historia. HotXLS wykrywa je przez CanReadEncrypted, ale nie potrafi ich odszyfrować, więc jedynym uczciwym ruchem jest skierowanie ich do kolejki, w której człowiek otwiera i zapisuje ponownie każdy z nich w Excelu, zanim wrócą do potoku. Tę asymetrię warto zaprojektować z góry, bo to właśnie zaszyfrowane pliki XLSX są najczęściej dokumentami, na których komuś naprawdę zależy
Domykanie pętli weryfikacją
Trzeci etap jest tym, który się pomija, a pominięcie go zamienia masową konwersję w zobowiązanie. Żadna ścieżka zapisu w HotXLS nie oblicza formuł. Excel przelicza, gdy otwiera plik, więc konwersja z XLSX do XLSX pozostaje poprawna, ale cel CSV dostaje dosłowny tekst formuły, chyba że potok najpierw uruchomi Calculate na komórkach i zapisze wyniki z powrotem. Wiedza o tym z góry jest różnicą między CSV pełnym liczb a CSV pełnym ciągów =SUM(...), których nikt nie zauważa, dopóki import niżej w potoku się nimi nie zakrztusi
Sama weryfikacja jest na tyle tania, że nie ma wymówki, by ją pominąć. Otwórz ponownie każdy przekonwertowany plik tą samą biblioteką, przelicz liczniki audytu i porównaj je z liczbami sprzed konwersji, które przebieg inwentaryzacji już zapisał. Liczba arkuszy, która spadła, liczba wykresów, która poszła do zera tam, gdzie źródło miało trzy, liczba komórek, która runęła w przepaść: każde z tych zdarzeń to cicha strata złapana za cenę jednego otwarcia. Sprawdź do tego wyrywkowo próbkę okiem w Excelu albo LibreOffice, a to połączenie łapie przeważającą większość szkód konwersji, zanim trafią do odbiorcy. To cały powód, dla którego etap inwentaryzacji zasila etap weryfikacji. Bez liczb sprzed konwersji liczby po niej niczego nie dowodzą
Warsztat z audytem na początku zamienia ryzykowną masową konwersję w mierzalny proces z torem kwarantanny dla plików, które nie potrafią przejść czysto. Wszystkie pokazane tutaj wywołania sondujące, liczące i konwertujące są częścią HotXLS Delphi Component, który uruchamia je natywnie w procesie, bez automatyzacji Excela