Skoroszyt ODS z jedną tabelą przestawną przechodzi przez bibliotekę, edytowana zostaje pojedyncza komórka źródłowa, a zapisany plik otwiera się z wszelkimi wartościami komórek nietkniętymi i bez tabeli: content.xml na wejściu miał jeden <table:data-pilot-table>, na wyjściu ma zero. Oczywista naprawa to skopiowanie XML-a tabeli jako napisu. To przywraca liczbę elementów, po czym parser rozumiejący przestrzenie nazw odmawia przyjęcia zapisanej części z błędem niepowiązanego prefiksu. Oba niepowodzenia mają jeden korzeń. Fragment XML-a podróżuje bezpiecznie tylko wtedy, gdy deklaracje przestrzeni nazw, od których zależy, podróżują razem z nim
Gdzie w content.xml mieszka definicja tabeli przestawnej ODS
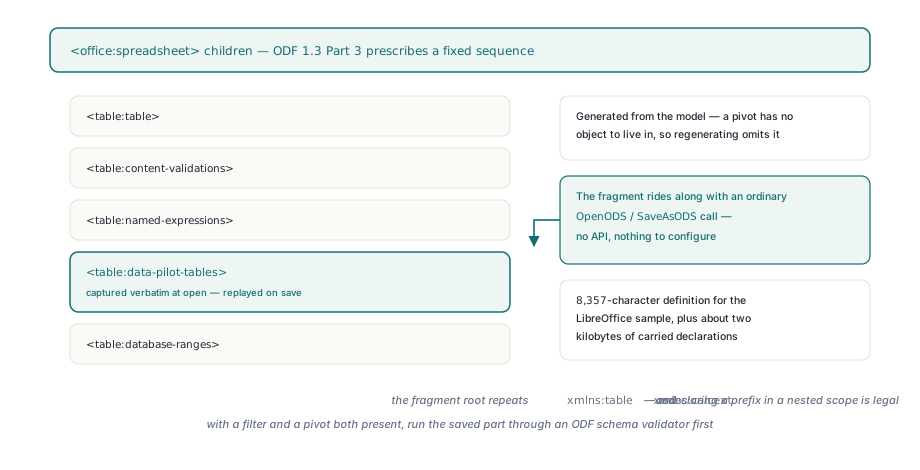
Tabela przestawna OpenDocument, którą format nazywa data pilot, to definicja przechowywana za arkuszami w content.xml, a writer odbudowujący tę część z własnego modelu obiektów zachowa ją tylko wtedy, gdy model ma gdzie ją umieścić. ODF 1.3 Part 3 §9.6 opisuje kontener: <table:data-pilot-tables> mieści po jednym <table:data-pilot-table> na tabelę, każdy z table:source-cell-range, zestawem dzieci table:data-pilot-field, table:target-range-address i listą table:buttons. Komórki wynikowe, które tabela pokazuje, siedzą wewnątrz arkusza jako zwykłe komórki. Writer, który regeneruje tylko komórki, style, walidacje, nazwane wyrażenia i zakresy bazodanowe, produkuje więc zupełnie poprawny arkusz z tymi samymi liczbami na ekranie i bez tabeli przestawnej za nimi
HotXLS Delphi Excel Component wyczytuje całe poddrzewo <table:data-pilot-tables> z content.xml podczas OpenODS, zanim sparsuje choć jedną komórkę, a potem próbuje przełożyć kolekcję na swój model tabel przestawnych. Definicja w zwykłym kształcie, który model reprezentuje — z lokalnym zakresem źródłowym, polem wierszowym, miarami agregującymi i zapisanymi wynikami zgodnymi z danymi źródłowymi — staje się TXLSPivotTable na liście PivotTables arkusza, tym samym obiektem, który dostaje się z tabeli XLSX i można rozbudowywać o pola liczone i odświeżać z Delphi. Wszystko poza tym kształtem zostawia kolekcję jako przechwycony XML, a SaveAsODS zapisuje go z powrotem. Wystarczy atrybut w przestrzeni nazw, której tłumacz nie zna: tabele zapisane przez LibreOffice mogą nieść atrybuty loext: i calcext:, a atrybut loext: wysyła definicję na ścieżkę przechwyconą
Fallback jest all or nothing na cały skoroszyt. Jeśli jedna tabela z kolekcji trzech wypadnie poza tłumaczalny kształt, wszystkie trzy zostają przechwyconym XML-em. Rozdzielenie ich zostawiłoby w content.xml dwa źródła prawdy dla jednego kontenera, połowę odbudowaną z obiektów i połowę odtworzoną z tekstu, a każda rozbieżność między połówkami trafiłaby do pliku użytkownika. Trzymanie kolekcji w całości to bezpieczniejszy domyślny wybór i ta sama polityka, którą HotXLS stosuje dla nieznanych bloków extLst w XLSX: czego model nie umie ponieść, zostaje zapisane tak, jak było
Dlaczego pocięta definicja tabeli psuje zapisany plik?
Definicja tabeli wycięta z content.xml wyszukiwaniem napisów traci deklaracje przestrzeni nazw, które nadają jej prefiksom sens, a Namespaces in XML traktuje prefiks bez deklaracji jako błąd well-formedness. Podejście napisowe jest krótkie: zdekoduj część do WideString, znajdź <table:data-pilot-tables przez Pos, znajdź za nim pasujący tag zamykający i skopiuj wszystko pomiędzy. Wychodzący tekst wygląda na kompletny. Zawiera loext:ignore-selected-page="true" na polu strony i calcext:repeat-item-labels="false" na każdym poziomie, ale deklaracje xmlns:loext i xmlns:calcext, które wiążą te prefiksy, siedzą na korzeniu dokumentu <office:document-content>, tysiące znaków wcześniej
Namespaces in XML 1.0 §6.1 utrzymuje deklarację w zasięgu od tagu początkowego, który ją niesie, do pasującego tagu końcowego, i każda nazwa z prefiksem wewnątrz rozwiązuje się względem niej. Wytnij poddrzewo z dokumentu, a wycinasz je z tego zasięgu. Gdy fragment trafi do nowego dokumentu, każdy prefiks rozwiąże się tylko wtedy, gdy nowy korzeń akurat go deklaruje. HotXLS pisze własny <office:document-content> z przestrzeniami nazw, których używa jego writer, w tym office, table, text, style, fo, draw, calcext, tableooo i of. W pociętej kopii table: się rozwiąże, calcext: się rozwiąże, a loext: nie. Jeden niepowiązany prefiks wystarcza, by parser rozumiejący przestrzenie nazw odrzucił całą część, więc tabela nie degraduje się łagodnie; dane arkusza wokół niej też stają się nieczytelne
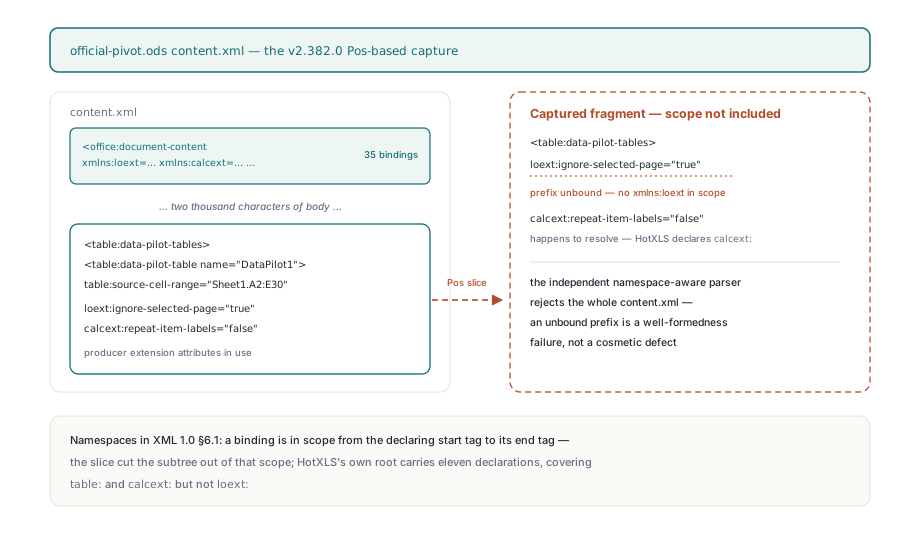
Wyszukiwanie napisów ma i inne ślepe pola, z którymi przechwyt oparty na czytniku nigdy się nie spotka. Pos trafia w tekst tagu wewnątrz komentarza, sekcji CDATA albo wartości atrybutu, która go cytuje. Nie odróżni zagnieżdżonych elementów o tej samej nazwie. I dopasowuje literał prefiksu table:, podczas gdy ODF pozwala producentowi związać przestrzeń nazw table z dowolnym prefiksem
Jak HotXLS przenosi zasięg przestrzeni nazw na fragment
HotXLS przechwytuje poddrzewo tabeli czytnikiem XML strumieniowym, który śledzi każdą deklarację przestrzeni nazw razem z głębokością, na której się pojawiła, i w momencie dotarcia do elementu docelowego kopiuje deklaracje wciąż obowiązujące na tag otwierający fragmentu. Stos rośnie na każdym tagu początkowym deklarującym xmlns lub xmlns:prefix i maleje, gdy element, który zadeklarował wiązanie, się zamyka. Puste elementy wymagają tego samego traktowania: <x xmlns:p="..."/> nigdy nie generuje osobnego zdarzenia tagu końcowego, więc zdjęcie ze stosu musi odpalić się także na pustym tagu początkowym, inaczej wiązanie przecieka do rodzeństwa
W miejscu docelowym przechwyt przechodzi stos od wiązania najgłębszego na zewnątrz i pisze każdy prefiks raz. Chodzenie od środka na zewnątrz realizuje shadowing. Jeśli <office:spreadsheet> wiąże ponownie prefiks już zadeklarowany na korzeniu, bliższa wartość jest tą obowiązującą w tabeli, dokładnie jak wymaga §6.1, a zbiór już zapisanych prefiksów pilnuje, by wartość zewnętrzna nie podążyła za nią. Prefiks, który element tabeli deklaruje na samym sobie, jest pomijany, bo podwójne xmlns:table na jednym tagu to inny błąd well-formedness
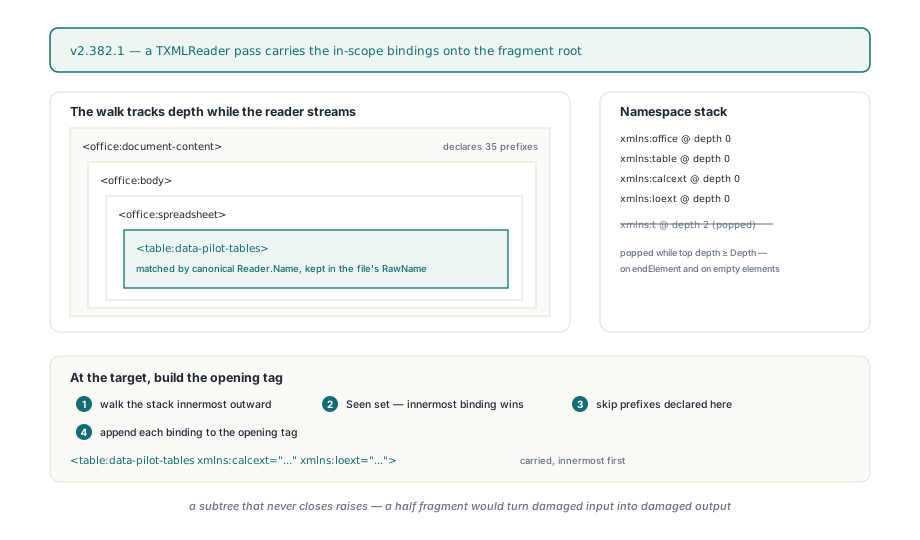
Cel jest dopasowywany po przestrzeni nazw, więc producent piszący <t:data-pilot-tables> z t związanym z URI tabeli ODF też zostaje rozpoznany, a przechwycone tagi zachowują pisownię z pliku. Węzły tekstowe ze spacjami wracają dokładnie tak, jak były zapisane. Cytowanie atrybutów i wybór między <x/> a <x></x> podlegają normalizacji, bo fragment jest ponownie serializowany ze zdarzeń czytnika, a nie kopiowany bajt w bajt. Jeśli content.xml skończy się, gdy poddrzewo tabeli jest wciąż otwarte — jak w skróconym pliku — otwarcie kończy się wyjątkiem, zamiast trzymać pół definicji, która zostałaby zapisana przy kolejnym zapisie
Przenoszony zbiór jest celowo hojny. Przechwyt kopiuje każde wiązanie w zasięgu, niezależnie czy poddrzewo go używa, więc korzeń fragmentu powtarza xmlns:table i xmlns:calcext, choć korzeń zapisanego dokumentu też je deklaruje. Ponowna deklaracja prefiksu w zagnieżdżonym zasięgu jest legalna wg Namespaces in XML, a plik od producenta deklarującego dziesiątki przestrzeni nazw na korzeniu tyje o parę kilobajtów. Przycięcie listy oznaczałoby skanowanie poddrzewa pod kątem każdego prefiksu w nazwach elementów, nazwach atrybutów i wartościach atrybutów trzymających QName, a jedna pomyłka w tej robocie sprowadza błąd niepowiązanego prefiksu z powrotem. Kilka redundantnych deklaracji kosztuje znacznie mniej niż to ryzyko
Otwarcie, edycja i zapis skoroszytu niosącego tabelę
Od strony wywołującej nie ma czego włączać: definicja tabeli jedzie razem ze zwykłym OpenODS i SaveAsODS. Arkusze numeruje się od 1, a obie metody zwracają 1 przy sukcesie:
uses
  System.SysUtils, lxHandleX;

procedure EditPivotSource(const InFile, OutFile: string);
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS(InFile) <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InFile]);
    // E2 leży wewnątrz zakresu źródłowego tabeli Sheet1.A2:E30
    Book.Sheets[1].Cells[2, 5].Value := 1250.0;
    if Book.SaveAsODS(OutFile) <> 1 then
      raise Exception.CreateFmt('Cannot save %s', [OutFile]);
  finally
    Book.Free;
  end;
end;
W zapisanym content.xml kolekcja tabel siedzi wewnątrz <office:spreadsheet> tuż za generowanym przez writer <table:named-expressions> i przed <table:database-ranges>. Skoroszyt niosący jednocześnie AutoFilter, który HotXLS zapisuje jako zakres bazodanowy, i tabelę przestawną stawia oba elementy obok siebie, i jeśli twój potok przepuszcza plik przez ścisły walidator schematu ODF, to właśnie ta para jest miejscem, od którego warto zacząć szukanie
Edycja z tego przykładu zmienia wartość źródłową i zostawia komórki wynikowe tabeli takie, jakie były. Przechwycona definicja jest odtwarzana dosłownie: HotXLS jej nie przelicza, a aplikacja arkuszowa otwierająca plik przeliczy tabelę przy następnym odświeżeniu. To samo dotyczy adresów. Zmień nazwę Sheet1 albo przenieś blok źródłowy, a zapisana definicja wciąż będzie wskazywać Sheet1.A2:E30, co konsumująca aplikacja zgłosi jako zepsuty zakres przy odświeżeniu. W skoroszytach, których tabele podróżują tą drogą, trzymaj nazwy arkuszy i blok źródłowy stabilne
Którą ścieżkę przeszła dana tabela?
Najszybszy test to lista PivotTables arkusza: przetłumaczona definicja pokazuje się tam jako TXLSPivotTable, przechwycona nie. Raport konwersji odpowiada na drugą połowę pytania: co stałoby się z tabelą w innym formacie wyjściowym. GetConversionReport ogląda skoroszyt bez zapisu i przeliczania, a zwrócony raport należy do wywołującego:
uses
  System.SysUtils, lxHandleX, lxDiagnostics;

function DescribeOdsPivots(Book: TXLSXWorkbook): string;
var
  I, Modeled: Integer;
  Report: TXLSConversionReport;
begin
  Modeled := 0;
  for I := 1 to Book.Sheets.Count do          // Sheets jest numerowane od 1
    Inc(Modeled, Book.Sheets[I].PivotTables.Count);

  Report := Book.GetConversionReport(xlsConversionOpenXmlWorkbook);
  try
    for I := 0 to Report.Count - 1 do
      if (Report[I].Feature = 'OpenDocumentPivotTables') and
         (Report[I].Fidelity = xlsConversionDropped) then
        Exit('Captured ODF pivot XML: keep this workbook on .ods');
  finally
    Report.Free;
  end;

  if Modeled > 0 then
    Result := Format('%d pivot table(s) in the pivot model', [Modeled])
  else
    Result := 'No pivot definitions';
end;
Ścieżka wyjściowa ma znaczenie, bo przechwycony XML to słownictwo ODF i emituje go tylko writer ODS. Zapisany jako .xlsx, przechwycona kolekcja nie ma odpowiednika w SpreadsheetML, a raport wypisuje ją pod OpenDocumentPivotTables z xlsConversionDropped. Writer binarnego .xlsb odmawia skoroszytu, który wciąż ją trzyma. Przetłumaczona tabela to zwykły obiekt modelu i podlega regułom formatu docelowego. Różnice między ścieżkami importu i eksportu ODS obowiązują tu jak wszędzie, a dla plików z tabelami bezpieczna droga to .ods na wejściu, .ods na wyjściu
Z fallbacku all-or-nothing wynika jeszcze jedna reguła. Skoroszyt albo odtwarza przechwyconą kolekcję, albo zapisuje swoje tabele z modelu; nigdy nie miesza jednego i drugiego w jednym content.xml. Dodanie tabeli przez AddPivotTable do skoroszytu, który już trzyma przechwycony XML tabel, zatrzymuje zapis ODS z błędem, zamiast splatać generowany XML obok odtwarzanego
Kontrola zapisanej części drugim parserem
Liczba elementów nie dowodzi niczego o przestrzeniach nazw. Wyrażenie regularne znajdujące tagi początkowe data-pilot-table w zapisanym content.xml widzi tekst, i pocięta kopia z drugiej sekcji przechodzi taki test. Parser rozumiejący przestrzenie nazw, niemający nic wspólnego z biblioteką, która pisała plik, jest sędzią o wiele surowszym, a Delphi ma taki w komplecie. Poniższa funkcja to kontrola do dorzucenia do własnego zestawu testów; TZipFile i TXMLDocument pochodzą z RTL Delphi, nie z HotXLS:
uses
  System.SysUtils, System.Classes, System.Zip,
  Xml.xmldom, Xml.XMLIntf, Xml.XMLDoc;

// Własny helper testowy: True, gdy content.xml z pakietu .ods
// wczytuje się w parserze DOM rozumiejącym przestrzenie nazw
function OdsContentParses(const OdsFile: string; out Error: string): Boolean;
var
  Zip: TZipFile;
  Bytes: TBytes;
  Stream: TBytesStream;
  Doc: IXMLDocument;
begin
  Error := '';
  Zip := TZipFile.Create;
  try
    Zip.Open(OdsFile, zmRead);
    Zip.Read('content.xml', Bytes);
  finally
    Zip.Free;
  end;
  Stream := TBytesStream.Create(Bytes);
  try
    Doc := TXMLDocument.Create(nil);
    try
      Doc.LoadFromStream(Stream);     // niepowiązany prefiks wywali się tu
      Result := True;
    except
      on E: EDOMParseError do
      begin
        Error := E.Message;
        Result := False;
      end;
    end;
  finally
    Stream.Free;
  end;
end;
Puszczaj ją na każdym .ods, który zapisuje twój kod, a dla plików z tabelami zrób krok dalej i porównaj po sparsowaniu poddrzewo tabeli wejścia i wyjścia: tag, posortowane atrybuty, tekst i dzieci, rekurencyjnie, z nazwami rozwiniętymi do URI przestrzeni nazw plus nazwy lokalnej. Takie porównanie przepuści przeliterowany inaczej prefiks i złapie niepowiązany, co jest dokładnie granicą między nieszkodliwym a zepsutym. Karm je plikami od każdego producenta, którego użytkownicy naprawdę używają. Dokument, który wiąże przestrzeń nazw table z innym prefiksem, deklaruje prefiks na samym elemencie tabeli albo wiąże go ponownie w <office:spreadsheet>, przetestuje reguły pomijania i shadowingu w sposób, którego pojedynczy plik LibreOffice nie wymusi
Czytnik i writer ODS, model tabel przestawnych dla XLSX i ODS oraz raport konwersji użyty wyżej to wszystko części HotXLS Delphi Excel Component; strona produktu opisuje pełne wsparcie odczytu i zapisu XLSX, XLS i ODS dla Delphi i C++Buildera