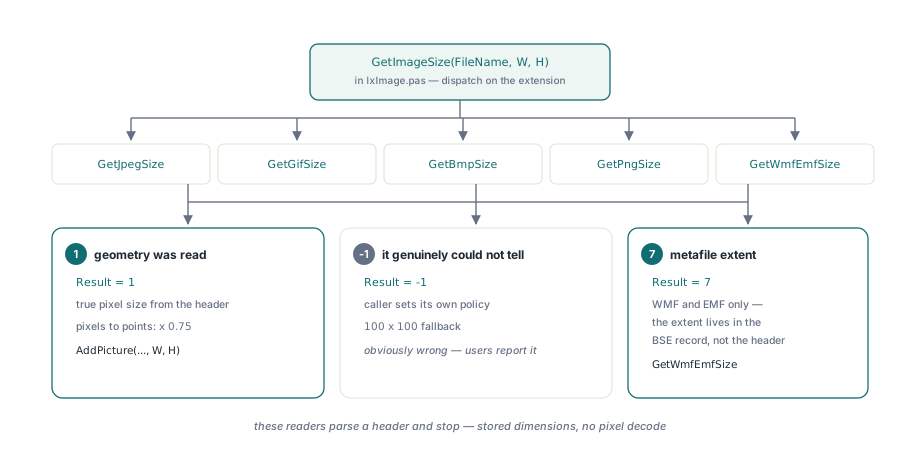
HotXLS czyta prawdziwą geometrię pikselową obrazka z własnego nagłówka pliku obrazu, zanim zapisana zostanie jakakolwiek geometria rysunkowa. GetImageSize w lxImage.pas dysponuje po rozszerzeniu pliku do GetJpegSize, GetGifSize, GetBmpSize, GetPngSize albo GetWmfEmfSize, przelicza piksele na punkty współczynnikiem 0.75 i zwraca -1, gdy naprawdę nie potrafi powiedzieć
Ten ostatni warunek to część, której dopracowanie zajęło najwięcej czasu. Czytnik rozmiarów, który nie potrafi zawieść, to czytnik rozmiarów, który kłamie, a kłamstwo o geometrii obrazu nie wypływa w momencie wstawiania. Wypływa tygodnie później, gdy ktoś otwiera skoroszyt, a logo firmy jest spłaszczonym prostokątem
Dlaczego obrazek potrzebuje prawdziwej geometrii, zanim trafi do rysunku?
Bo format arkusza przechowuje wymiar, nie obraz. Gdy AddPicture albo Images.AddFromFile umieszcza obrazek, część rysunkowa zapisuje jawną szerokość i wysokość kształtu — w DrawingML to atrybuty cx i cy elementu a:ext, w angielskich jednostkach metrycznych, zgodnie z ECMA-376 Part 1 §20.4. Nic w tym rekordzie nie mówi „użyj naturalnego rozmiaru obrazu", więc naturalny rozmiar musi skądś pochodzić, a jedyne miejsce, gdzie istnieje, to bajty obrazu. Pomylisz się trzykrotnie, a obrazek będzie rozciągnięty trzykrotnie, w każdej aplikacji otwierającej skoroszyt, na zawsze. Konwersja jednostek z tych wymiarów pikselowych do EMU to osobna sprawa, opisana w artykule o jednostkach EMU i skalowaniu; ten tekst jest o kroku przed nią, o tym, skąd w ogóle biorą się liczby pikseli. Fallback, gdy czytnik zawiedzie, to 100 na 100, i ta liczba jest celowo, oczywiście zła. To nie zgadywanie prawdopodobnego rozmiaru, to marker oznaczający „nikt nie umiał odczytać tego pliku", i jest dużo lepszy niż wiarygodnie wyglądająca zła liczba, bo użytkownik zgłasza go natychmiast
GIF: deskryptor, którego nigdy nie parsowano
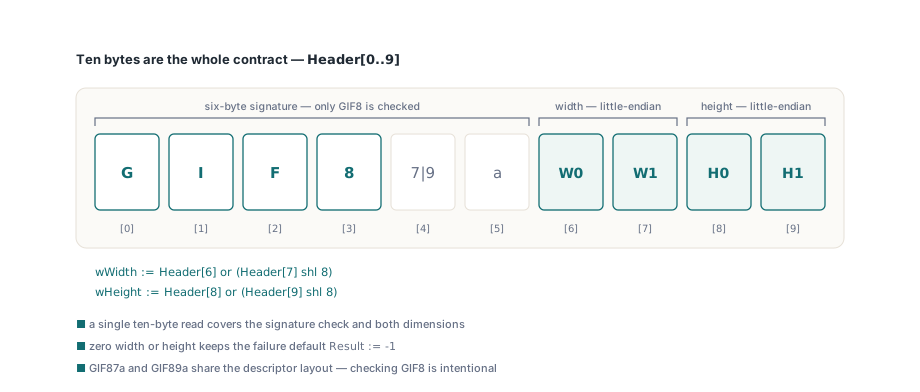
GetGifSize jest nowy, a zanim powstał, każdy GIF wstawiony do arkusza wychodził na dokładnie 100 na 100 — nie było żadnej gałęzi GIF, więc rozszerzenie spadało do domyślnego ramienia GetImageSize i zwracało -1. To najtańszy nagłówek w zestawie do sparsowania, co czyni pominięcie lekko żenującym i bardzo łatwym do naprawy. Specyfikacja GIF89a kładzie Logical Screen Descriptor tuż za sześciobajtową sygnaturą, a §18 definiuje jego pierwsze dwa pola jako szerokość i wysokość ekranu logicznego, każde jako 16-bitową wartość bez znaku w kolejności little-endian. W kategoriach pliku to bajty 6 i 7 dla szerokości oraz 8 i 9 dla wysokości, więc jedno dziesięciobajtowe odczytanie pokrywa sprawdzenie sygnatury i oba wymiary
function GetGifSize(const AFileName: WideString; var AWidth, AHeight: Double): Integer;
var
  f: TWFileStream;
  Header: array [0.. 9] of Byte;
  wWidth, wHeight: Word;
begin
  Result:= - 1;
  AWidth:= 100;
  AHeight:= 100;
  f:= TWFileStream.Create(AFileName, fmOpenRead);
  try
    // Sygnatura "GIF8", potem Logical Screen Descriptor: szerokość i
    // wysokość jako słowa little-endian na offsetach 6 i 8
    if (f.Read(Header[0], SizeOf(Header))= SizeOf(Header))and
      (Header[0]= Ord('G'))and (Header[1]= Ord('I'))and
      (Header[2]= Ord('F'))and (Header[3]= Ord('8')) then
    begin
      wWidth:= Header[6]or (Header[7] shl 8);
      wHeight:= Header[8]or (Header[9] shl 8);
      if (wWidth> 0)and (wHeight> 0) then
      begin
        AWidth:= wWidth* 0.75;
        AHeight:= wHeight* 0.75;
        Result:= 1;
      end;
    end;
  finally
    f.Free;
  end;
end;
Zwróć uwagę na jego kształt: wartości porażki są przypisywane pierwsze, a ścieżka sukcesu jest jedyną rzeczą, która je nadpisuje. Każdy czytnik w lxImage.pas trzyma się tej kolejności, bo czyni „nie umiałem tego odczytać" wartością domyślną zamiast czymś, o czym trzeba pamiętać przy każdym wczesnym wyjściu. Sprawdzanie tylko GIF8 zamiast pełnego stringa GIF87a albo GIF89a jest zamierzone — układ deskryptora jest identyczny w obu rewizjach, a odrzucanie pliku, którego geometria jest czytelna, nie ma sensu
Co właściwie zmienia rozmiar nagłówka BMP równy 12?
GetBmpSize czyta cztery bajty na offsecie 14 jako rozmiar nagłówka DIB i rozgałęzia się po wartości, bo BMP z rozmiarem nagłówka 12 przechowuje wymiary w zupełnie innej szerokości pola niż każde inne BMP. [MS-WMF] §2.2.2 rozkłada rodzinę: BITMAPCOREHEADER ma 12 bajtów i niesie 16-bitowe szerokość i wysokość, a BITMAPINFOHEADER, BITMAPV4HEADER i BITMAPV5HEADER wszystkie zaczynają się od 32-bitowych ze znakiem biWidth i biHeight. Czytanie czterech bajtów tam, gdzie plik ma dwa, nie zawodzi głośno; wciąga liczbę płaszczyzn i głębię bitową jako starszą połowę liczby i raportuje bitmapę kilkaset tysięcy pikseli szeroką. Druga pułapka w tym samym nagłówku to znak biHeight: wartość ujemna nie znaczy ujemnej wysokości, tylko że wiersze DIB są składowane od góry do dołu zamiast od dołu do góry, a to stwierdzenie o kolejności pikseli, które nie ma nic wspólnego z geometrią
  f.Seek(14, soFromBeginning);
  if f.Read(HeaderSize, 4)= 4 then
  begin
    if HeaderSize= 12 then
    begin
      // BITMAPCOREHEADER przechowuje wymiary 16-bitowe
      if (f.Read(wWidth, 2)= 2)and (f.Read(wHeight, 2)= 2) then
      begin
        lWidth:= wWidth;
        lHeight:= wHeight;
        Result:= 1;
      end;
    end
    else if (f.Read(lWidth, 4)= 4)and (f.Read(lHeight, 4)= 4) then
      Result:= 1;
  end;
  // ...
  // Ujemne biHeight oznacza tylko DIB od góry do dołu; wielkość to rozmiar
  if (Result= 1)and (lWidth> 0)and (lHeight<> 0) then
  begin
    AWidth:= lWidth* 0.75;
    AHeight:= Abs(lHeight)* 0.75;
  end
  else
    Result:= - 1;
Ostatnia strażniczka zasługuje na bliską lekturę. Wysokość jest testowana przeciw <> 0, nie > 0, bo ujemna jest legalna, a zero nie, i Abs jest stosowane tylko w punkcie konwersji. Szerokość nie ma odpowiednika — ujemne biWidth nie jest zdefiniowane przez format, więc jest traktowane jak uszkodzony plik i degradowane do -1. Przekazanie surowej ujemnej wartości w górę zamiast tego dałoby ujemny wymiar w rekordzie rysunkowym, a to jest przycinane, ignorowane albo renderowane jako odbity kształt, w zależności od tego, która aplikacja otwiera skoroszyt
JPEG: które markery są właściwie nagłówkami ramek?
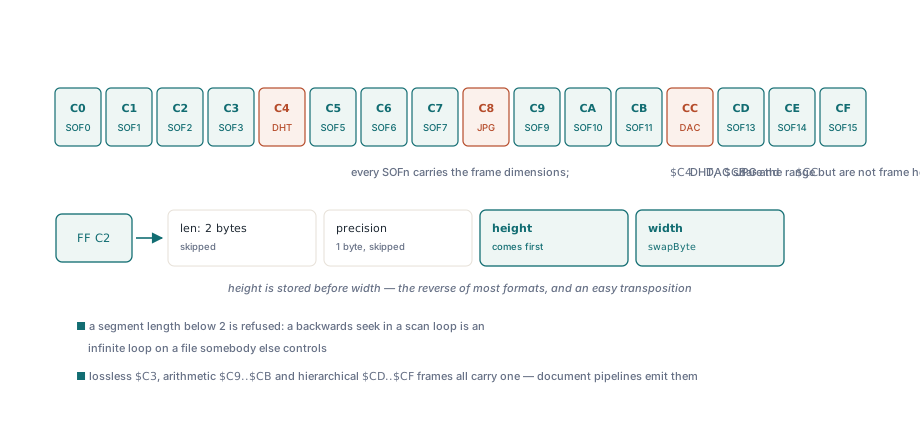
GetJpegSize przyjmuje zestaw markerów [$C0..$C3, $C5..$C7, $C9..$CB, $CD..$CF], a trzy luki w tym zakresie to cały sedno. ITU-T T.81 §B.2.2 definiuje nagłówek ramki jako SOFn, i to w nagłówku ramki mieszkają liczba linii i próbek na linię, w każdym typie ramki, nie tylko w tych powszechnych. Markery wpadające w ten sam numeryczny przedział, ale niebędące nagłówkami ramek, to $C4 (DHT, definiowanie tablic Huffmana), $C8 (JPG, zarezerwowany) i $CC (DAC, definiowanie warunkowania kodowania arytmetycznego). Czytnik rozpoznający tylko baseline, extended sequential i progressive — $C0, $C1 i $C2 — działa na prawie każdym JPEG-u, który produkuje aparat albo narzędzie do zrzutów ekranu, i po cichu zawodzi na tych, które mają znaczenie w przepływach dokumentów: JPEG bezstratny ($C3), warianty z kodowaniem arytmetycznym ($C9 przez $CB) i hierarchiczne typy ramek ($CD przez $CF) wszystkie przeskanowują nagłówek ramki, zjeżdżają za koniec pliku i lądują w fallbacu. Obrazowanie medyczne i pipeline'y skanowanych dokumentów produkują dokładnie takie pliki
// Każdy marker SOFn niesie wymiary ramki; $C4 (DHT), $C8 (JPG)
// i $CC (DAC) dzielą zakres, ale nie są nagłówkami ramek
if Seg in [$C0.. $C3, $C5.. $C7, $C9.. $CB, $CD.. $CF] then
begin
  ReadLen:= f.Read(Dummy[0], 3);
  ReadLen:= f.Read(wHeight, 2);
  wHeight:= swapByte(wHeight);
  ReadLen:= f.Read(wWidth, 2);
  wWidth:= swapByte(wWidth);
  found:= True;
  Break;
end
Dwa szczegóły w tych siedmiu liniach. Trzy pominięte bajty to słowo długości segmentu plus bajt precyzji próbek, więc odczyt ląduje na liczbie linii; JPEG przechowuje wysokość przed szerokością, czyli odwrotnie niż większość formatów, co łatwo przestawić. A wartości przechodzą przez swapByte, bo JPEG jest w całości big-endianowy — ten sam powód, dla którego GetPngSize przepuszcza swoje 32-bitowe wartości IHDR przez lswapByte. Wędrówka po segmentach ma własną strażniczkę: gdy marker nie jest bezparametrowy, czytnik bierze dwubajtową długość, zamienia bajty i odmawia seeku, gdy wartość jest poniżej 2 — długość krótsza niż własne pole przełożyłaby się na seek do tyłu, a seek do tyłu w pętli skanującej to nieskończona pętla na pliku, którego ktoś inny jest właścicielem
Zwrócenie minus jeden bije zwrócenie prawdopodobnej liczby
Wspólny wątek przez wszystkie pięć czytników jest taki, że GetImageSize rozróżnia trzy wyniki, nie dwa. 1 znaczy, że geometria została odczytana z pliku. -1 znaczy, że nie, i wywołujący powinien użyć domyślnej. 7 zwraca GetWmfEmfSize i znaczy coś zupełnie innego: mówi AddPicture, żeby wziął rozmiar z rekordu BSE metafilu, bo WMF albo EMF niesie swój wymiar we własnym rekordzie obrazu skoroszytu, nie na stałym offsecie w nagłówku pliku. Obsługa metafili w ogóle jest opisana w artykule o ograniczonym dekoderze EMF i WMF. GetJpegSize pokazuje, dlaczego to rozróżnienie potrzebuje jawnego flagu zamiast wnioskowania: pętla skanowania może zakończyć się na trzy sposoby — znalazła nagłówek ramki, trafiła na koniec pliku albo wysiadła na uszkodzonej długości segmentu — a tylko pierwszy przypisuje wWidth i wHeight. Bez booleanu found pozostałe dwie ścieżki przekonwertowałyby cokolwiek akurat zawierały te lokalne zmienne i podały wynik w górę jako sukces. Niezainicjalizowane lokalne często są zerem, a zero to tu najgorsza możliwa odpowiedź: przechodzi przez każdą dolną walidację i produkuje niewidzialny obrazek, którego nikt nie może zaznaczyć ani usunąć
var
  W, H: Double;
begin
  case GetImageSize(FileName, W, H) of
    1: Sheet.AddPicture(FileName, Row, Col, W, H);
    7: Sheet.AddPicture(FileName, Row, Col);  // metafile: rozmiar z rekordu BSE
  else
    // W i H to 100 x 100; zdecyduj o polityce zamiast przyjmować placeholder
    LogWarning('unreadable image geometry: ' + FileName);
  end;
end;
Gdzie są uczciwe granice
Te czytniki celowo parsują nagłówek i kończą. Nie dekodują pikseli, więc raportują składowane wymiary i nic więcej, a są przypadki, w których składowane wymiary nie są całą historią. Animowany GIF, którego ramki są mniejsze niż ekran logiczny, wciąż raportuje ekran logiczny, co jest poprawne dla układu i może nie zgadzać się z tym, co pokazuje przeglądarka. JPEG z tagiem orientacji EXIF wymagającym obrotu o 90 stopni raportuje nieobrócone wymiary ramki, więc portret zrobiony telefonem może wrócić jako krajobraz. DIB z niekwadratowym współczynnikiem pikseli raportuje surowe liczby pikseli, a współczynnik 0.75 zakłada 96 DPI wszędzie. Żadne z tych nie są bugami czytania nagłówków i żadnego nie da się naprawić bez dekodowania obrazu, do czego ta warstwa nie służy — to udokumentowane granice, więc jeśli twój pipeline obsługuje zdjęcia z telefonu, przeczytaj tag orientacji sam i zamień wartości przed wywołaniem AddPicture. Wszystko inne o umieszczaniu obrazków, kotwiczeniu i obiektowym modelu rysunków jest w artykule o wykresach, obrazach i rysunkach
HotXLS czyta i zapisuje XLS, XLSX, ODS i CSV natywnie w Delphi i C++Builder bez potrzeby instalacji Excela, a wstawianie obrazków przechodzi przez tę ścieżkę nagłówków w każdym z tych formatów. Wsparcie formatów i szczegóły licencji są na stronie produktu HotXLS Delphi spreadsheet component