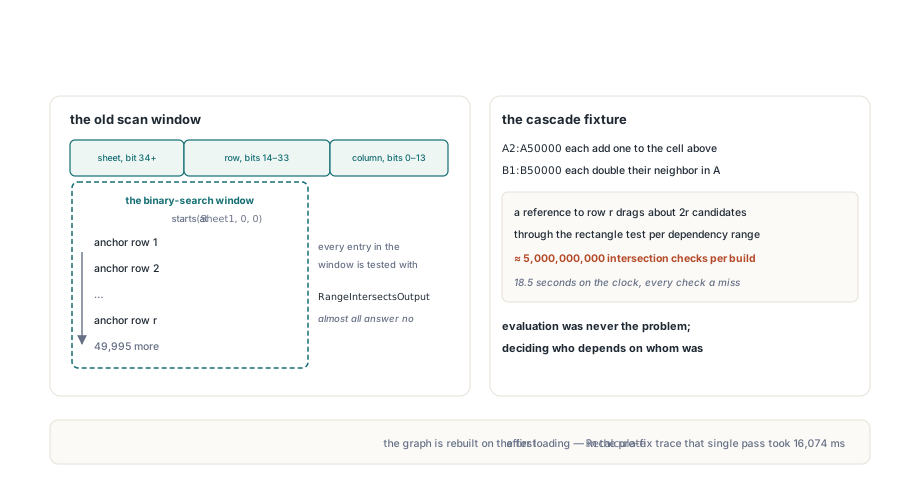
Arkusz z 50 000 formuł w kolumnie A, z których każda dodaje jedno do komórki wyżej, i drugie 50 000 w kolumnie B podwajających sąsiada, to model kalkulacyjny mniej więcej tak prosty, jak się tylko da. Jego ewaluacja kosztuje 100 000 dodawań i mnożeń. Ustalenie kolejności ewaluacji kosztuje dużo więcej, jeśli builder krawędzi napisano oczywistym sposobem: przeszukaj każdą formułę od góry referencjonowanego arkusza aż po referencjonowany wiersz, przetestuj każdą na nakładanie i zachowaj trafienia. Dla tego jednego arkusza wychodzi z grubsza pięć miliardów testów prostokątów, i prawie każdy z nich odpowiada „nie”
Tamte pięć miliardów to arytmetyka, nie odczyt ze stopera. Referencja do wiersza r wciąga do okna przeszukiwania około 2r kandydatów, po jednym na kolumnę dla każdego wiersza powyżej, a zsumowanie tego po 100 000 referencji ląduje w miliardach. Ciekawe jest to, że okno naprawdę musi zaczynać się od samej góry arkusza, i powód nie ma nic wspólnego z lenistwem
Gdzie przebudowa zależności wydaje swój czas
Silnik przeliczania HotXLS przebudowuje graf zależności formuł za każdym razem, gdy zmienia się topologia formuł: pierwsze Recalculate po wczytaniu albo wygenerowaniu skoroszytu i pierwsze po przepisaniu formuł, dodaniu lub usunięciu arkuszy albo sklonowaniu bloku komórek. Obie klasy skoroszytów, TXLSWorkbook i TXLSXWorkbook, budują do tego TXLSDepGraph z modułu lxDepGraph. Każda komórka z formułą staje się jednym węzłem z kotwicą (Row, Col) i prostokątem wyjścia biegnącym do (OutRow2, OutCol2). Dla zwykłej formuły prostokąt to sama komórka kotwicy
Węzły są porządkowane spakowanym kluczem 64-bitowym z XLSDepMakeKey: kolumna siedzi w bitach 0–13, wiersz w bitach 14–33, a indeks arkusza od bitu 34 w górę. Sortowanie po tym kluczu daje porządek arkusz-major, wiersz-major, więc znalezienie ostatniej formuły, która mogłaby się liczyć dla referencji, to pojedyncze wyszukiwanie binarne po (Sheet2, Row2, 16383). Pierwsza jest problemem. Dolna granica musi być (Sheet1, 0, 0), czyli sam szczyt referencjonowanego arkusza, a wszystko między obiema granicami staje się kandydatem
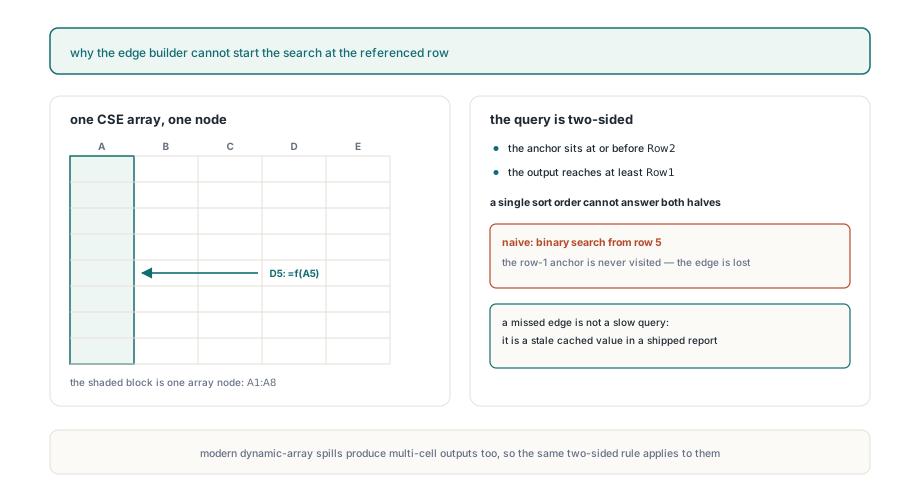
Dlaczego wyszukiwanie nie może zacząć od referencjonowanego wiersza?
Formuła tablicowa zakotwiczona nad zakresem może posiadać komórki wewnątrz niego. W TXLSXWorkbook tablica CSE wpisana w A1:A8 to jeden węzeł, którego kotwicą jest A1, a wyjście schodzi aż do wiersza 8, jak opisuje artykuł o przeliczaniu przyrostowym i grafie zależności. Formuła w D5 czytająca tylko A5 wciąż potrzebuje krawędzi od tego węzła. Zacznij wyszukiwanie binarne od wiersza 5, a kotwica w wierszu 1 nigdy nie zostanie odwiedzona, krawędź nie zostanie zapisana, i D5 może zostać ewaluowane przed tablicą, od której zależy. Objawem jest nieaktualna wartość z cache w zapisanym skoroszycie, co znacznie trudniej zauważyć niż wolne przeliczanie
Prawdziwe zapytanie ma więc dwie strony. Węzeł jest kandydatem, gdy jego kotwica leży na Row2 albo przed nim, a jego wyjście sięga co najmniej Row1, na arkuszu wewnątrz referencji i z nakładającymi się kolumnami. Sortowanie po kotwicy odpowiada na pierwszą połowę. Nic w porządku kotwic nie mówi niczego o drugiej połowie, bo formuła w wierszu 3 może mieć na wyjściu jedną komórkę albo tysiąc wierszy. Ta sama sylwetka u tabel what-if: TXLSXWorkbook rejestruje każdą tabelę danych jako jeden węzeł obejmujący cały swój obszar wyników. Formuły dynamicznych tablic idą inną drogą i są znaczone jako ulotne, więc przeliczają się przy każdym przebiegu; jak zachowują się rozlane zakresy, opisuje artykuł o formułach rozlewanych dynamicznych tablic
TXLSDepGraph jest klasą publiczną, więc przypadek łatwo odtworzyć bez skoroszytu. Indeksy arkuszy są liczone od jedynki, a wiersze i kolumny od zera, zgodnie ze współrzędnymi kalkulatora. Program probierczy poniżej rejestruje korzeń tablicowy i czytelnika, buduje krawędzie, a przy okazji przepuszcza odwrócony łańcuch referencji punktowych przez ten sam typ grafu, by pokazać licznik, na którym opierają się następne sekcje
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // Tablica CSE: kotwica A1 (wiersz 0, kolumna 0), wyjście aż do A8 (wiersz 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5 (wiersz 4, kolumna 3) czyta tylko A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, korzeń A1
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: korzeń A1 i sam D5
  finally
    G.Free;
  end;

  // Łańcuch A1..A100000, każda komórka czyta komórkę wyżej, dodawany od dołu
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
Przycinanie poddrzew po ich największym wierszu wyjścia
TXLSDepGraph.BuildEdges zostawia sortowanie po kotwicy dla górnej granicy, a dolną obsługuje drzewem przedziałowym z maksimum, rozłożonym na porządku posortowanym. Każdy wpis drzewa trzyma największe OutRow2 ze wszystkich węzłów pod sobą. Zapytanie schodzi w dół tylko wewnątrz okna kluczy i porzuca każde poddrzewo, którego zapamiętane maksimum leży nad Row1, bo żadna formuła w tym poddrzewie nie sięgnie referencjonowanych wierszy. Węzły, które przeżyją, i tak dostają pełny test prostokąta, więc zakresy arkuszy i kolumny są sprawdzane dokładnie jak dawniej
Technika jest na tyle mała, że można pokazać ją w całości. Poniższy szkic to zminimalizowana wersja napisana na potrzeby tego artykułu, z własnymi nazwami; żadna z nich nie jest API HotXLS, a tablice czy wypełnienie czytelnik dostarcza sam, z listy wierszy wyjścia już posortowanej po kluczu kotwicy
uses
  System.Math, System.Generics.Collections;

// Tylko szkic: drzewo przedziałowe z maksimum po węzłach posortowanych po kluczu kotwicy.
// OutRow2[i] to ostatni wiersz wyjścia i-tego węzła w porządku posortowanym.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// Zbiera, od lewej do prawej, każdy węzeł w [Lo, Hi), którego wyjście sięga Row1
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // poza oknem albo nic nie sięga Row1
  if L = R then
  begin
    Hits.Add(L);                 // wołający i tak uruchamia pełny test prostokąta
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // najpierw lewe
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // zachowuje porządek skanu
end;

// Buduj raz przez BuildMax(Ix, 1, 0, Count - 1),
// potem na każdą referencję wołaj Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits)
Na referencję praca spada z rozmiaru okna do O((k + 1) log n), gdzie k to liczba węzłów, których wyjście faktycznie sięga referencjonowanych wierszy. Wracając do modelu z otwarcia, referencja z Br do Ar testuje teraz dwa prostokąty, Ar i sam Br, a referencja z Ar do komórki wyżej testuje dwa węzły na tym wierszu. Na palcach to około 200 000 testów na całą budowę zamiast pięciu miliardów
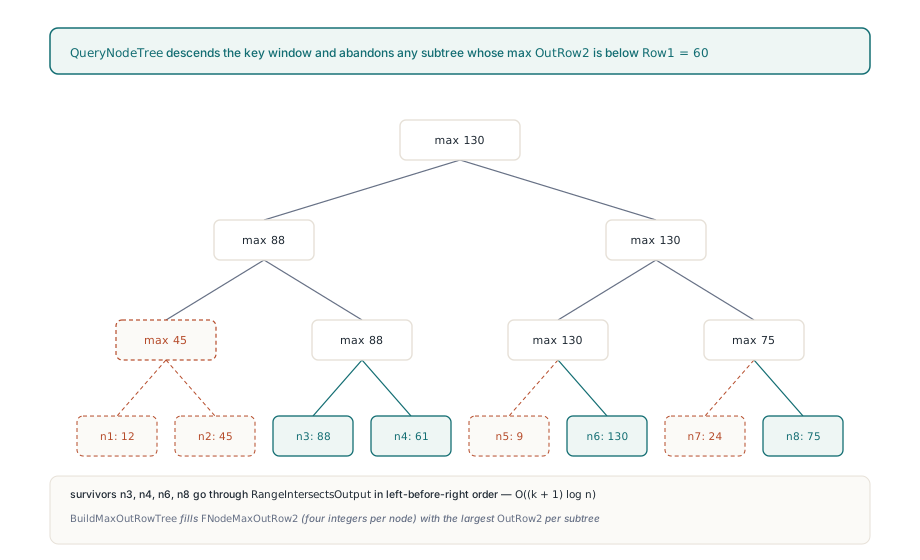
Te same krawędzie, w tej samej kolejności
Rekurencja lewe-przed-prawymi znaczy więcej, niż wygląda. Przeżyłe węzły są odwiedzane dokładnie w tej kolejności, w jakiej odwiedziłaby je zwykła pętla po oknie, więc tablice Dependents i Precedents każdego węzła wypełniają się w tej samej sekwencji, a porządek topologiczny z nich budowany wychodzi ten sam przy każdym uruchomieniu. Ten porządek to nie tylko wewnętrzna księgowość: gdy graf jest aktualny, writer XLSX emituje xl/calcChain.xml w kolejności, w jakiej zwraca FullTopoOrder, więc niedeterministyczna kolejność wizyt pokazałaby się jako zaszumione diffy między dwoma zapisami niezmienionego skoroszytu
Rodzaje krawędzi też zachowują swoje reguły. Referencje siedzące w argumencie tablicy wyszukiwania VLOOKUP, MATCH, XLOOKUP i podobnych funkcji produkują krawędzie lookup-scan, które propagują brud, ale trzymają się z dala od wykrywania cykli. Gdy węzeł ma do tego samego precedensa i twardą referencję, i referencję wyszukiwania, twarda krawędź zapisana pierwsza tłumi późniejszą krawędź skanu, a krawędź skanu zapisana pierwsza zachowuje swoje miejsce, podczas gdy twarda krawędź jest i tak dodawana. To porządkowanie sprawia, że zakresy wyszukiwania nie produkują fałszywych odwołań cyklicznych, i trzyma się tylko wtedy, gdy przycięty spacer odwiedza kandydatów w porządku skanu
Właściwość EdgeCandidateChecks robi przycinanie obserwowalnym. Liczy prostokąty wyjścia, które ostatnie wywołanie BuildEdges faktycznie przetestowało, i resetuje się na początku każdej budowy. W programie probierczym powyżej odwrócony łańcuch zgłasza 99 999, po jednym teście na referencję, mimo że węzły były dodawane od dołu i sortowanie musiało ułożyć je wszystkie na nowo. AddNode znaczy jako nieaktualne i sort, i krawędzie, więc następne BuildEdges albo NodeIndexOf przebudowuje indeks, zamiast go łatać
Gdzie siedzi pozostały koszt
Drzewo przycina tylko po wierszach, i ten wybór kształtuje to, za co duży model nadal płaci
- Pudła po kolumnach wciąż są płatne na liściach: wszystkie 2 626 formuł wypełniających
A100:Z200sięgają wiersza 100, więc referencja doAA100:AA200przetestuje każdą, zanim odrzuci ją po kolumnach - Szerokie referencje, jak zakresy całych kolumn, naprawdę mają wiele precedensów; indeks usuwa zmarnowane sprawdzenia, a budowanie prawdziwych krawędzi pozostaje proporcjonalne do ich liczby
- Referencja obejmująca kilka arkuszy otwiera okno pokrywające cały pierwszy arkusz, więc formuły na nim z głębokimi wyjściami docierają do testu liścia; krawędzie wychodzą te same, słabsze jest tylko przycinanie
- Drzewo kosztuje cztery liczby całkowite na węzeł formuły, około 1,6 MB dla 100 000 formuł, a każda zmiana topologii płaci pełne przesortowanie O(n log n) plus budowę drzewa O(n) przy następnej budowie krawędzi
Wiersze to właściwy jednowymiarowy indeks. Generowane raporty, księgi i modele finansowe rosną w dół, więc odległość po wierszach to miejsce, z którego pochodzi prawie wszystkich zmarnowanych kandydatów, podczas gdy pudło po kolumnach odrzuca test prostokąta w garści porównań liczb całkowitych. Drugi wymiar w drzewie skomplikowałby każde zapytanie, żeby oszczędzać testy, które już teraz są tanie
Strona wołająca ma swój koszt: droga jest przebudowa grafu, a edycje wartości jej nie wyzwalają. Recalculate buduje graf przy pierwszym wywołaniu; późniejsze przeliczają tylko formuły poniżej zmienionych wartości, plus ulotne. Wzorcem, do którego trzeba dążyć, jest najpierw zapisanie wszystkich formuł i jednokrotne przeliczenie. Harness poniżej mierzy oba rodzaje przebiegu na klasycznym silniku, gdzie Recalculate zwraca liczbę komórek z formułami, których nie dało się ewaluować; uruchamiaj go na sprzęcie, który będzie gościł zadanie wsadowe, bo czasy absolutne mocno zależą od maszyny
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // łańcuch 49 999 ogniw w kolumnie A
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // 50 000 zależnych w kolumnie B
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // buduje graf, ewaluuje wszystko
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // edycja wartości: graf jest reużywany
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // tylko brudny podgraf
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
W tym modelu przebieg po wartościach wciąż przelicza wszystkie 99 999 formuł, bo cała kolumna A wisi na A1; pomijana jest budowa grafu. Nadpisanie komórki z formułą zwykłą wartością to co innego, bo to zmiana topologii i następne Recalculate buduje graf od zera
Ta sama kwadratowa sylwetka w klonowanych nazwach zdefiniowanych
Pasy raportów chowają ten sam wzorzec w innym miejscu. TXLSXWorksheet.CloneRangeTo kopiuje nazwy zdefiniowane wskazujące bezpośrednio na zakres wewnątrz klonowanego bloku, a każda kopia potrzebuje nazwy unikalnej w swoim zakresie: Total_2, Total_3 i tak dalej. Wyszukiwanie, które przy każdej kopii startuje od _2, sonduje za każdym razem jednego kandydata więcej, więc arkusz zbudowany ze setek sklonowanych pasów wydaje na samo nazywanie kwadratową liczbę wyszukiwań nazw
TXLSXDefinedNames omija to dzięki podpowiedzi sufiksu trzymanej w indeksie nazw, po jednej na nazwę bazową i zakres. Następne wyszukiwanie startuje od sufiksu zwróconego ostatnim razem i najpierw sprawdza go ponownie, bo wołający może nazwy faktycznie nie dodać. Usunięcie nazwy, przemianowanie jej przez Name, przeniesienie przez SheetIndex albo wyczyszczenie kolekcji zrzuca indeks razem z każdą podpowiedzią, więc następny klon wraca do pierwszego wolnego sufiksu i wypełnia każdą dziurę, którą zmiana otworzyła
Jeśli twoja aplikacja w Delphi albo C++Builderze generuje albo przelicza duże skoroszyty Excela, komponent Excel HotXLS dla Delphi i C++Buildera dostarcza ten indeksowany graf zależności w silniku przeliczania dla obu swoich klas skoroszytów — klasycznej i XLSX