HotXLS odtwarza etykiety równań trendline i R-squared Excela w Delphi przez XLSTrendlineEquationLabel z modułu lxStandard. Funkcja dopasowuje punkty serii właścicielskiej dla trendline liniowych, wykładniczych, logarytmicznych, wielomianowych (rząd 2-6), potęgowych i średniej kroczącej i zwraca ten sam napis, jaki Excel zgłasza w DataLabel.Text, punkt kodowy w punkt kodowy, albo False, gdy dopasowanie jest nieokreślone
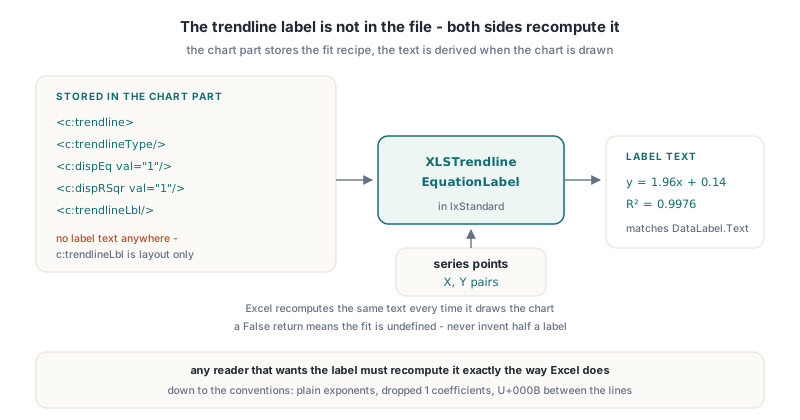
Powód, dla którego to w ogóle potrzebuje funkcji, jest taki, że etykiety nie ma w pliku. Wykres XLSX przechowuje element c:trendline z c:trendlineType, przełącznikami c:dispEq i c:dispRSqr i opcjonalnym c:trendlineLbl dla pozycji i formatowania, ale ECMA-376 DrawingML Charts nie daje etykiecie żadnego własnego tekstu. Excel przelicza y = 1.96x + 0.14 za każdym razem, gdy rysuje wykres. Każdy kod Delphi, który chce pokazać, wyeksportować, wyszukać albo porównać ten napis bez uruchamiania Excela, musi go przeliczyć też, i przeliczyć tak, jak robi to Excel, aż po odstępy wokół znaku minus
Dlaczego nie sformatować współczynników regresji samemu?
Ręcznie sformatowane współczynniki prawie nigdy nie pasują do etykiety Excela, bo etykieta trzyma się kilku małych konwencji, łatwych do przegapienia i łatwych do sprawdzenia. HotXLS zamroził te konwencje z żywych odczytów COM Excela z DataLabel.Text na wykresie punktowym, a potem napisał formater pod to wyrocznię, a nie pod intuicję
Konwencje, które kąszą w praktyce:
- Wykładniki to zwykłe znaki w tekście etykiety. Etykieta wielomianowa czyta
x2, niex², a etykieta potęgowa czytax0.9732; podniesiony wygląd to atrybut renderowania wykresu, nie część napisu - Jedynym znakiem spoza ASCII jest U+00B2, podniesiona dwójka w prefiksie
R² = - Współczynnik dokładnie 1 albo -1 jest opuszczany, więc Excel pisze
y = x + 3, niey = 1x + 3 - Składniki łączą się przez swoje znaki ze spacjami (
+i-), podczas gdy wiodący ujemny współczynnik bierze goły minus, jak wy = -0.0429x2 + 2.2171x - 0.16 - Gdy Excel pokazuje obie linie,
DataLabel.Textskleja je U+000B, pionowym tabulatorem, a nie parą CR/LF
Formatowanie liczb też ma granice. XLSTrendlineEquationLabel drukuje zero jako 0, przełącza się na jedno-cyfrową notację naukową, jak 2E+06, gdy wielkość jest poniżej 0,0001 albo co najmniej 1000000, a poza tym używa notacji stałej z czterema miejscami po przecinku do 99,9999, o jedno mniej na każdą dalszą cyfrę całkowitą, z przyciętymi końcowymi zerami. Dlatego 1.96 wychodzi jako 1.96, a nie 1.9600
Wywoływanie XLSTrendlineEquationLabel z Delphi
XLSTrendlineEquationLabel przyjmuje rodzaj trendline jako liczbę porządkową TXLSXChartTrendlineType, rząd wielomianu, otwartą tablicę rekordów TXLSTrendlineLabelPoint z polami X i Y oraz dwa przełączniki wyświetlania. Zwraca napisy równania i R-squared przez parametry out jako WideString, zostawiając napis pustym, gdy jego przełącznik jest wyłączony. Argument rzędu ma znaczenie tylko dla xlsxTrendPolynomial; dla innych rodzajów podawaj 0
uses
  lxStandard, lxHandleX;

procedure ShowFiveTrendlines;
const
  YS: array[0..4] of Double = (2.1, 3.9, 6.2, 8.1, 9.8);
var
  Points: array[0..4] of TXLSTrendlineLabelPoint;
  Eq, R2: WideString;
  I: Integer;
begin
  for I := 0 to 4 do
  begin
    Points[I].X := I + 1;
    Points[I].Y := YS[I];
  end;

  // Liniowy: Eq = 'y = 1.96x + 0.14', R2 = 'R' + #$00B2 + ' = 0.9976'
  if XLSTrendlineEquationLabel(Ord(xlsxTrendLinear), 0, Points,
    True, True, Eq, R2) then
    Writeln(Eq, ' | ', R2);

  // Wielomian rzędu 2: 'y = -0.0429x2 + 2.2171x - 0.16', R2 0.9983
  if XLSTrendlineEquationLabel(Ord(xlsxTrendPolynomial), 2, Points,
    True, True, Eq, R2) then
    Writeln(Eq, ' | ', R2);

  // Wykładniczy: 'y = 1.6767e0.3812x', R2 0.9386
  if XLSTrendlineEquationLabel(Ord(xlsxTrendExponential), 0, Points,
    True, True, Eq, R2) then
    Writeln(Eq, ' | ', R2);

  // Ten sam napis, jaki Excel wkłada do DataLabel.Text, gdy pokazane są obie linie
  Eq := Eq + #$000B + R2;
end;
Pięć wartości w tej próbce to zamrożona wyrocznia Excela, którą zestaw testowy HotXLS sprawdza dla każdej rodziny. Dopasowanie logarytmiczne wraca jako y = 4.7635ln(x) + 1.4589 z R² = 0.9519, a dopasowanie potęgowe jako y = 2.0719x0.9732 z R² = 0.9978. Jeśli twoje wyjście różni się od Excela na tych samych danych, biblioteka i wyrocznia są w niezgodzie, i to jest błąd wart zgłoszenia, nie preferencja zaokrąglania
Jak Excel liczy R-squared dla trendline wykładniczych i potęgowych?
Dla etykiety trendline R-squared to kwadrat korelacji Pearsona między dopasowanymi wartościami a rzeczywistymi wartościami Y w pierwotnej przestrzeni danych, i XLSTrendlineEquationLabel liczy go tak samo. Współczynniki dopasowania wykładniczego, logarytmicznego albo potęgowego wciąż pochodzą ze zwykłych najmniejszych kwadratów na danych po transformacji logarytmicznej: ln(y) względem x dla wykładniczego, y względem ln(x) dla logarytmicznego i ln(y) względem ln(x) dla potęgowego. Tylko liczba dopasowania jest mierzona z powrotem w domenie naturalnej
To detal, w którym większość reimplementacji się myli, bo podręcznikowe podejście mierzy R-squared w przekształconej przestrzeni, gdzie prosta była dopasowywana. Na populacji wyroczni różnica wychodzi już na drugim miejscu po przecinku. Dopasowanie wykładnicze w przekształconej przestrzeni daje 0.9477, podczas gdy etykieta Excela, odczytana żywcem, mówi R² = 0.9386, czyli korelację w domenie naturalnej. Generator etykiet, który reużywa swoich statystyk regresji z przestrzeni przekształconej, wypisałby złą liczbę na pierwszym wykresie, jaki użytkownik porówna
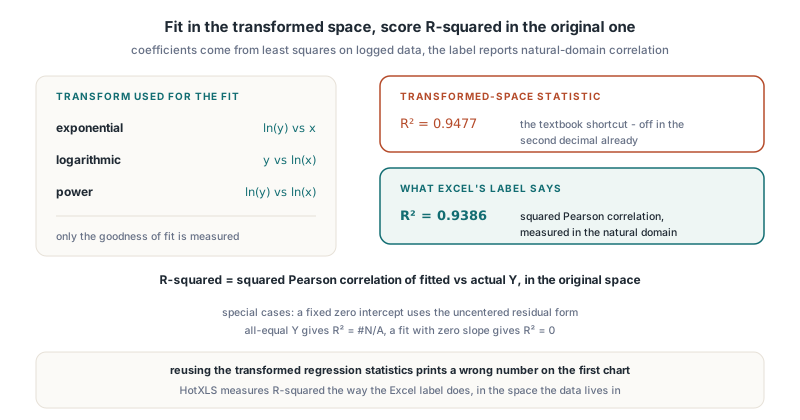
Dwa przypadki specjalne zmieniają wzór. Trendline liniowy ze stałym wyrazem wolnym zerem używa niewycentrowanej formy resztowej, 1 minus suma kwadratów reszt przez sumę kwadratów wartości Y, co zgadza się z tym, co Excel pokazuje dla tej konfiguracji. Populacja, której wartości Y są wszystkie równe, nie ma wariancji do wyjaśnienia, więc wynikiem jest R² = #N/A obok stałego równania, jak y = 5. Nie stała populacja, której dopasowanie akurat ma zerowe nachylenie, dostaje zamiast tego R² = 0
Stałe wyrazy wolne i drugie przeciążenie
Drugie przeciążenie XLSTrendlineEquationLabel dokłada InterceptSet: Boolean i Intercept: Double przed parametrami wyjściowymi, co zwierciadli element c:intercept trendline i własności InterceptSet i Intercept z TXLSXChartTrendline. Excel oferuje stały wyraz wolny tylko dla trendline liniowych, wykładniczych i wielomianowych, i funkcja egzekwuje tę samą regułę: stały wyraz wolny przy dopasowaniu logarytmicznym albo potęgowym zwraca False, a dopasowanie wykładnicze potrzebuje dodatniego wyrazu wolnego, bo dopasowanie pracuje na jego logarytmie
procedure LabelForTrendline(Trend: TXLSXChartTrendline;
  const Points: array of TXLSTrendlineLabelPoint);
var
  Eq, R2: WideString;
begin
  if not XLSTrendlineEquationLabel(Ord(Trend.TrendlineType), Trend.Order,
    Points, Trend.DispEq, Trend.DispRSqr, Trend.InterceptSet,
    Trend.Intercept, Eq, R2) then
  begin
    // Nieokreślone dopasowanie: nie wymyślaj etykiety
    Writeln('No label for this trendline');
    Exit;
  end;
  if Eq <> '' then Writeln(Eq);
  if R2 <> '' then Writeln(R2);
end;

procedure AddQuadraticThroughOrigin(Series: TXLSXChartSeries);
var
  Trend: TXLSXChartTrendline;
begin
  Trend := Series.AddTrendline(xlsxTrendPolynomial);
  Trend.Order := 2;
  Trend.DispEq := True;
  Trend.DispRSqr := True;
  Trend.InterceptSet := True;
  Trend.Intercept := 0;
end;
Podanie własnych własności trendline prosto w przeciążenie trzyma etykietę w kroku z tym, co skoroszyt każe Excelowi narysować. Gdy InterceptSet jest False, wartość Intercept jest ignorowana, więc przekazywanie własności bezwarunkowo jest bezpieczne. Stały wyraz wolny obniża też wymóg punktów o jeden: wielomian rzędu n zwykle potrzebuje n + 1 punktów, ale tylko n, gdy wyraz stały jest przypięty
Jakich wartości X faktycznie używa trendline wykresu Line?
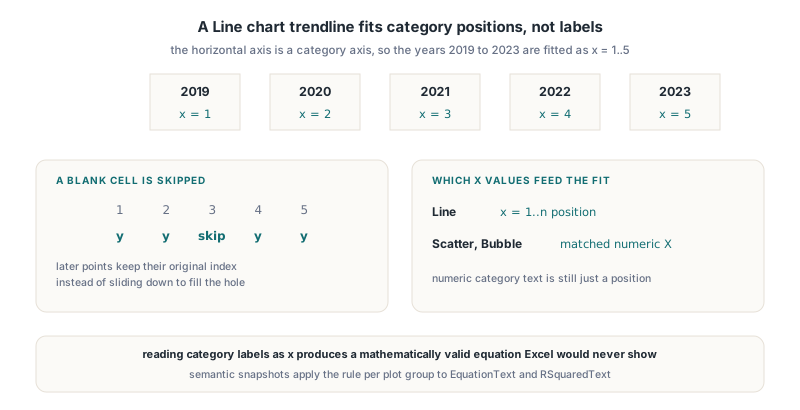
Trendline na zwykłym wykresie Line dopasowuje się względem pozycji kategorii liczonej od 1, nie etykiety kategorii, nawet gdy etykiety są liczbami. Excel traktuje poziomą oś wykresu Line jako oś kategorii, więc seria narysowana nad latami 2019-2023 jest dopasowywana jako x = 1..5 i wyraz wolny równania to odzwierciedla. Wykresy Scatter i Bubble są inne: dopasowują się względem dopasowanych liczbowych wartości X każdego punktu
HotXLS nauczył się tego twardym doświadczeniem. Pierwsza wersja projekcji semantycznych migawek czytała liczbowy tekst kategorii jako właściwe x, co produkowało matematycznie ważne równanie, którego Excel by nigdy nie pokazał. Poprawka pogoni przeniosła dopasowania Line na pierwotną pozycję kategorii dla każdej kategorii, liczbowej czy nie, i rozstrzygnęła też, co się dzieje z dziurami: pusta komórka Y jest zostawiana poza dopasowaniem, ale późniejsze punkty trzymają swój pierwotny indeks, zamiast zsuwać się w dół, żeby zapełnić dziurę. To samo rozróżnienie pozycji kategorii i prawdziwych wartości stoi za kalendarzowo dokładnymi podziałkami osi dat w wykresach HotXLS
uses
  Math, lxStandard, lxHandleX;

// Values trzyma serię Line w kolejności kategorii; NaN znaczy pustą komórkę
function LinePointsFromCategories(const Values: array of Double):
  TArray<TXLSTrendlineLabelPoint>;
var
  I, N: Integer;
begin
  SetLength(Result, Length(Values));
  N := 0;
  for I := 0 to High(Values) do
  begin
    if IsNan(Values[I]) then
      Continue;                  // pomiń pustą, trzymaj późniejsze indeksy
    Result[N].X := I + 1;        // pozycja kategorii liczona od 1
    Result[N].Y := Values[I];
    Inc(N);
  end;
  SetLength(Result, N);
end;
Pomyłka w tym kroku i każda inna konwencja z tego artykułu jest zmarnowana, bo etykieta będzie poprawnie sformatowanym tekstem dla złej regresji. Semantyczne migawki skoroszytu w HotXLS nakładają już tę regułę per grupa kreślenia, gdy emitują własności EquationText i RSquaredText, więc migawka zaimportowanego wykresu niesie tekst etykiety, jaki pokazałby Excel, obok reszty zachowanego ChartML dla zaimportowanych wykresów Excel
Kiedy XLSTrendlineEquationLabel zwraca False?
XLSTrendlineEquationLabel zwraca False i zostawia oba napisy puste, ilekroć dopasowanie jest nieokreślone, zamiast publikować częściową albo zgadywaną etykietę. Funkcja nigdy nie emituje pół równania, więc wynik True zawsze znaczy, że oba żądane napisy są kompletne
- Mniej niż dwa punkty, rodzaj trendu poza 0..5 albo rząd wielomianu poza 2..6
- Nie dodatnie X dla dopasowań logarytmicznych albo potęgowych, albo nie dodatnie Y dla wykładniczych albo potęgowych, bo oba potrzebują logarytmu
- Wejścia NaN albo nieskończone, albo jakiekolwiek X, Y albo wyraz wolny o wielkości powyżej 1E50
- Za mało punktów dla rzędu wielomianu, wszystkie wartości X równe dla dopasowania niewielomianowego bez stałego wyrazu wolnego albo osobliwy układ wielomianowy
- Wartości dopasowane wychodzące poza zakres skończony (powyżej 1E100) albo wykładniki, które przepełniłyby
Średnia krocząca to celowy wyjątek. Excel nie wystawia równania ani napisu R-squared dla trendline średniej kroczącej, nawet gdy przechowane przełączniki dispEq i dispRSqr są włączone, więc funkcja zwraca True z oboma napisami pustymi, co poprawnie mówi wołającemu, że nie ma czego rysować
Stabilność numeryczna i obecne granice
Trendline wielomianowe to miejsce, gdzie naiwny kod gubi cyfry. Surowe równania normalne dla dopasowania szóstego rzędu po wartościach X w tysiącach są źle uwarunkowane, więc HotXLS centruje i skaluje X przed zbudowaniem układu, rozwiązuje go eliminacją Gaussa-Jordana z częściowym wyborem i dopiero potem rozwija współczynniki z powrotem do pierwotnej zmiennej. Dopasowania liniowe i korelacja R-squared używają przyrostowej akumulacji średniej i wariancji z tego samego powodu, a wyraz wolny, który jest jedynie szumem zmiennoprzecinkowym względem danych, jest przyciągany do zera, żeby etykieta nie kończyła się + 4E-17
Uczciwe granice są w formatowaniu. Funkcja produkuje domyślne liczby etykiet Excela; własny LabelNumberFormat na etykiecie trendline jest przechowywany przez TXLSXChartTrendline, ale nie jest nakładany na policzony tekst. Stylizacja wykładników na podniesione w renderowanym wyjściu i automatyczne rozmieszczanie etykiet to osobna robota, a dopasowania o bardzo wysokim rzędzie po danych z dużym przesunięciem albo prawie współliniowych mogą wciąż być odrzucane jako osobliwe zamiast rozwiązane. Dla biblioteki, która ma się zgadzać z Excelem, odmowa to bezpieczniejsza porażka
FAQ
Czy plik XLSX przechowuje tekst równania trendline
Nie. Element c:trendline przechowuje typ dopasowania, rząd albo okres, opcjonalny wyraz wolny, prognozy i przełączniki c:dispEq i c:dispRSqr, a c:trendlineLbl przechowuje rozmieszczenie i formatowanie etykiety. Excel liczy tekst równania i R-squared w czasie renderowania, dlatego HotXLS liczy go przez XLSTrendlineEquationLabel
Dlaczego etykieta wielomianowa pokazuje x2 zamiast indeksu górnego
Bo dokładnie to zawiera DataLabel.Text Excela. Wykładnik to zwykła cyfra w napisie, a Excel nakłada podniesione formatowanie, gdy rysuje wykres. Znak U+00B2 pojawia się tylko w prefiksie R² = linii R-squared
Czy da się liczyć etykiety dla wykresów zbudowanych klasycznym silnikiem XLS
XLSTrendlineEquationLabel mieszka w lxStandard i jest współdzielony przez oba silniki HotXLS, więc działa z każdym zbiorem punktów, jaki umiesz wydobyć. Automatyczna projekcja tekstu etykiety do semantycznych migawek obejmuje na razie wykresy OOXML; dla innych źródeł zbuduj tablicę TXLSTrendlineLabelPoint sam i trzymaj się reguły pozycji kategorii dla wykresów Line
Liczenie etykiet trendline, autoryng wykresów i reszta modelu obiektowego Excel są w HotXLS, natywnym komponencie arkuszy Delphi dla XLS i XLSX, bez wymaganej instalacji Excela w czasie biegu