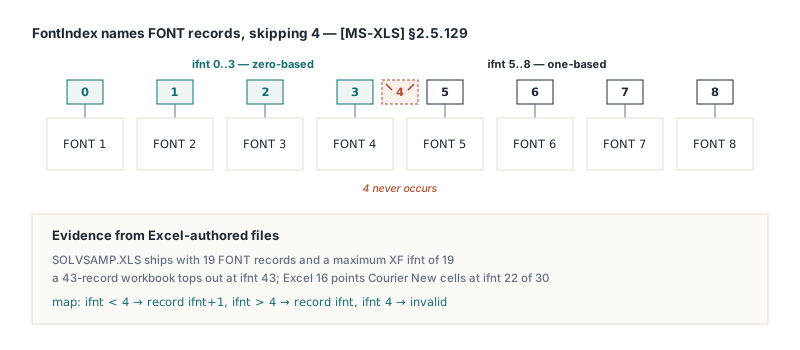
Skoroszyt BIFF8 z ośmioma rekordami FONT zawiera rekord XF, którego pole fontu ma wartość 8. Licząc od zera, to jeden slot za końcem tabeli, a mimo to Excel renderuje komórkę ósmym fontem bez słowa. Wartość jest legalna: [MS-XLS] §2.5.129 numeruje pierwsze cztery rekordy FONT od 0 do 3, pomija 4 całkowicie i numeruje każdy późniejszy rekord jego pozycją liczoną od jedynki
Piąty rekord FONT to więc ifnt 5, a dobrze uformowany plik nigdy nie potrzebuje wartości większej niż liczba rekordów FONT. Reguła czyta się jak literówka w specyfikacji — właśnie dlatego ludzie ją "poprawiają" — a ponieważ formaty komórek, rich text współdzielonych stringów i runy komentarzy niosą wszystkie ten sam typ FontIndex, lektura różniąca się między ścieżkami wiąże część fontów poprawnie, a inne o rekord obok. To ta sama rodzina co dziwactwa długości i kodowania w dekodowaniu cch i fHigh w BIFF8 XLUnicodeString — plik jest w porządku, nie jest nią jego odczyt
Co mówi [MS-XLS] §2.5.129 i jak to sprawdzić na prawdziwym pliku
[MS-XLS] §2.5.129 definiuje FontIndex jako pozycję rekordu z dziurą. Wartości poniżej 4 są liczone od zera, wartości powyżej 4 od jedynki, a wartości 4 używać NIE WOLNO. Rekordy XF wskazują nią fonty, wpisy FormatRun bogatego współdzielonego stringa jej używają, a także runy formatujące TXO opisane w §2.5.272
Nie musisz wierzyć specyfikacji na słowo. Zrzuć .xls zapisany przez samego Excela dowolną przeglądarką rekordów BIFF, policz rekordy FONT (typ rekordu $0031), potem przeskanuj pole fontu na starcie każdego rekordu XF ($00E0). Najwyższa wartość mieści się w liczbie rekordów, a czwórki nie ma na liście. Jeśli znajdziesz 4 albo wartość powyżej liczby FONT, plik napisało coś innego niż Excel i jego numeracja fontów zasługuje na bliższe spojrzenie. Dla narzędzia diagnostycznego albo testu całe mapowanie mieści się w dwóch funkcjach
// Własne helpery, nie część żadnej biblioteki
// [MS-XLS] 2.5.129 FontIndex: 0..3 zero-based, > 4 one-based, 4 niepoprawne
function FontIndexToRecordNo(Ifnt: Word): Integer;  // rekord FONT liczony od 1
begin
  if Ifnt < 4 then
    Result := Ifnt + 1
  else if Ifnt > 4 then
    Result := Ifnt
  else
    Result := -1;  // 4 nie może wystąpić
end;

function RecordNoToFontIndex(RecordNo: Integer): Word;
begin
  if RecordNo <= 4 then
    Result := RecordNo - 1
  else
    Result := RecordNo;
end;
Jak HotXLS numeruje fonty w rekordach XF i runach rich text
HotXLS czyta i pisze każde odwołanie do fontu w BIFF8 w numeracji ze specyfikacji. Przy zapisie tabela fontów jest kompresowana do fontów, na które coś faktycznie wskazuje, a pozycja każdego ocalałego fontu staje się FontIndexem: pozycje 1 do 4 wychodzą jako 0 do 3, pozycja 5 i wyżej wychodzi bez zmian. Wczytywanie odwraca to, więc każda wartość 5 lub więcej zsuwa się o jeden, by znaleźć font w pamięci, a cokolwiek poniżej 5 zostaje na miejscu. Ta sama konwersja jest stosowana do rekordów XF, do runów rich text w tabeli współdzielonych stringów, do runów komentarzy i pól tekstowych oraz do odwołań do fontów wewnątrz klasycznych rekordów wykresów
Dla kodu aplikacji widoczną częścią jest TextRuns na TXLSComment i TXLSTextBox. TextRuns.FontIndex[I] zwraca numerację plikową dokładnie tak, jak została wczytana, z pominiętą czwórką. Indeksy runów liczą od 1, a CharIndex[I] to przesunięcie znakowe, na którym zaczyna się run I. Wystawianie numeru plikowego zamiast slotu tabeli liczonego od zera to tu lepszy domyśl: to, co raportuje API, zgadza się z tym, co pokazuje zrzut rekordów. Kosztem jest jedno wywołanie helpera powyżej, zanim potraktujesz wartość jako pozycję tabeli
var
  Book: IXLSWorkbook;
  Note: TXLSComment;
  I: Integer;
  Ifnt: Word;
begin
  Book := TXLSWorkbook.Create;
  if Book.Open('review-notes.xls') <> 1 then
    raise Exception.Create('Cannot open review-notes.xls');
  Note := Book.Sheets[1].Range['C2', 'C2'].Comment;
  if Note <> nil then
    for I := 1 to Note.TextRuns.Count do
    begin
      Ifnt := Note.TextRuns.FontIndex[I];   // numeracja plikowa, czwórka pominięta
      // własny sprawdzian zdrowia: 4 znaczy, że plik łamie 2.5.129
      if Ifnt = 4 then
        raise Exception.CreateFmt('Run %d uses invalid ifnt 4', [I]);
      Writeln(Format('run %d at char %d: ifnt %d = FONT record #%d',
        [I, Note.TextRuns.CharIndex[I], Ifnt, FontIndexToRecordNo(Ifnt)]));
    end;
end;
Po zapisie liczba zapisana dla runa może różnić się od tej, którą przeczytałeś albo ustawiłeś. Zapis renumeruje runy razem z kompresowaną tabelą fontów, więc liczba się zmienia, a font, na który wskazuje — nie
Dlaczego zero-based poprawka przesuwa każdy własny font
Pułapka zwykle zaczyna się od raportu błędu, który wygląda rozsądnie. Ktoś zrzuca skoroszyt z ośmioma rekordami FONT, widzi XF celujący w font 8, wnioskuje, że pisarz wyprodukował indeks poza zakresem, i przełącza pisarza i czytnika na czystą arytmetykę zero-based. Test round trip nadal przechodzi, bo załatany pisarz i załatany czytnik zgadzają się ze sobą. Excel się nie zgadza. Plik zapisany w ten sposób trzyma pierwszy własny font jako ifnt 4, które Excel rozwiązuje do fontu domyślnego, a każdy kolejny własny font ląduje rekord za wcześnie. Czytanie własnych plików Excela idzie w drugą stronę: każdy font wiąże się rekord za późno
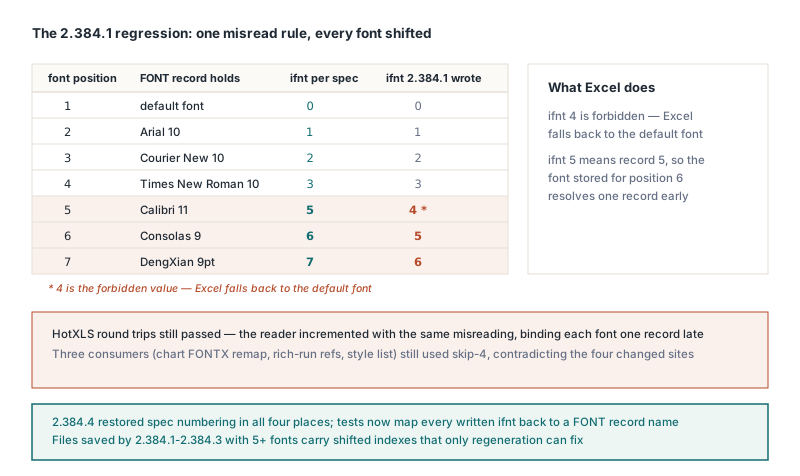
Dwa sygnały zdradzają błędną lekturę, zanim wypłynie. Pierwszy to test asercjonujący ifnt < FontCount. Wygląda jak sprawdzenie granic, a faktycznie zapisuje błędną lekturę jako wymaganie. Test, który mapuje każde zapisane ifnt z powrotem do nazwy rekordu FONT przez formułę ze specyfikacji, łapie przesunięcie przy pierwszym przebiegu
Drugi sygnał to kod, który przeczy sam sobie. Kompletny czytnik i pisarz BIFF8 stosuje regułę pomijania 4 w kilku miejscach: wyjście XF, wejście XF, remapowanie runów współdzielonych stringów, runy komentarzy, rekordy fontów wykresów. Gdy zmiana przenosi część z nich na numerację zero-based i zostawia resztę, nietknięte miejsca są dowodem, więc podejrzewaj zmianę, zanim podejrzewasz je. Częściowa zmiana potrafi się ukrywać długo, bo fonty używane w rich texcie są zwykle też powoływane przez jakiś format komórki
Dlaczego runsy fontów komentarzy psują się dopiero przy drugim zapisie?
Runy komentarzy i pól tekstowych potrafią przeżyć jeden zapis i paść przy następnym, gdy spotkają się dwa nawyki pisarza. Pierwszy to asymetryczne przycinanie: trzymaj pierwsze N-1 rekordów FONT bezwarunkowo na miejscu i wyrzucaj tylko ostatni, gdy żaden XF się na niego nie powołuje. Drugi to zapisywanie runów formatujących TXO ([MS-XLS] §2.4.329) z powrotem bajt za bajt bez renumeracji. Każdy nawyk osobno przechodzi test pojedynczego zapisu. Razem ustawiają utratę fontu, która czeka jedną generację
Powód leży w tym, co pisze Excel. Pliki .xls autorstwa Excela często kończą się niepowołanym fontem na ogonie; na systemie z chińskimi ustawieniami regionalnymi to 9-punktowy DengXian. Przy pierwszym zapisie font używany wyłącznie przez run komentarza nigdy więc nie jest ostatni i nic widocznie się nie rusza. Ten zapis wyrzuca jednak font z ogona i awansuje font tylko-komentarzowy na ostatnią pozycję. Drugi zapis znajduje ostatni font bez powołania XF i wyrzuca go. ifnt runa celuje teraz za koniec tabeli, a Excel cofa się do fontu domyślnego. Jeśli skoroszyt zyskał w międzyczasie font, run wiąże się z nowym przybyszem. Notatki otwierane, adnotowane i zapisywane w kółko, jak te z budowania workflow przeglądu komentarzy i hiperłączy, to miejsce, gdzie to wychodzi pierwsze
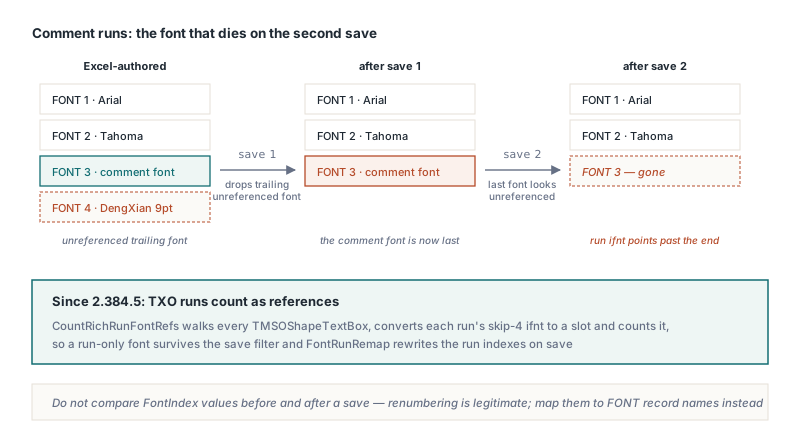
HotXLS traktuje runy komentarzy i pól tekstowych tak samo jak runy współdzielonych stringów. Zanim tabela fontów zostanie skompresowana, każdy run na każdym arkuszu jest przeliczany ze swojego FontIndexu z pominięciem 4 na slot tabeli i liczony jako powołanie, co utrzymuje przy życiu font używany tylko przez run. Na wyjściu runy przechodzą przez tę samą tabelę slot-na-zapisany-indeks, która renumeruje rekordy XF. Końcowy wpis TxOLastRun nie niesie fontu i jest zapisywany tak, jak został przeczytany. Przez tę renumerację porównywanie wartości FontIndex przed i po zapisie nie mówi nic; porównuj nazwy fontów, do których się rozwiązują
Kopie, wstawianie wierszy i runy przekraczające skoroszyty
W klasycznym silniku Range.Copy, CopyRange, Sheets.AddCopy i przesunięcia komórek za Range.Insert i Range.Delete przechodzą przez jedną ścieżkę kopiowania komórek, a przesunięcie to po prostu kopia połączona z wyczyszczeniem. Kopia, która niósłaby tylko tekst komentarza i autora, zamieniłaby notatkę o dwóch runach w notatkę o jednym foncie po jednym wstawieniu wiersza — bez dotknięcia komentarza przez użytkownika
HotXLS kopiuje przesunięcie startowe i font każdego runa razem z tekstem. Wewnątrz jednego skoroszytu FontIndex jest używany ponownie jak jest. Między skoroszytami font podróżuje po wartości: liczba skip-4 jest przeliczana na slot, font jest dopasowywany albo dodawany w docelowej tabeli fontów po swoich atrybutach, a powstały slot jest przeliczany z powrotem na numerację plikową. Rich text we współdzielonych stringach przechodzi tę samą konwersję, gdy Sheets.AddCopy kopiuje arkusz do innego skoroszytu, więc oba rodzaje runów nie mogą się rozjechać. Strona tabeli fontów idzie tym samym podejściem po wartości co strona formuł opisana w kopiowaniu między skoroszytami i rebindingu formuł
Dwa przypadki brzegowe warto znać, gdy piszesz do tego testy:
- Wklejenie w miejscu, gdzie źródło i cel rozwiązują się do tego samego komentarza, zachowuje runy; nic nie jest czyszczone, zanim zostało przeczytane
Sheets.AddCopykopiuje też komentarze przyczepione do komórek bez zapisanego rekordu komórki, które sama pętla po zapisanych komórkach przegapiłaby
W silniku XLSX kopie klonują runy komentarzy po wartości, a część komentarzy jest czytana i pisana z rFont, strike, u i vertAlign. Nazwa fontu runa, przekreślenie, podkreślenie i ustawienie indeksu górnego albo dolnego wracają więc nienaruszone po zapisie i ponownym otwarciu
Test regresyjny, który przeżywa renumerację
Każda pułapka w tym artykule przechodzi test w pamięci. Błędna lektura zero-based mieszka w sparowanym pisarzu i czytniku, utrata fontu komentarza potrzebuje dwóch zapisów, a zgubione runy komentarzy na XLSX wychodzą dopiero po ponownym otwarciu. Test musi więc otwierać z dysku, robić co najmniej dwie generacje zapisu i sprawdzać strukturę runów zamiast surowych numerów fontów. Zacznij od skoroszytu zapisanego przez samego Excela, z komentarzem o dwóch runach na C2, którego drugi run używa fontu, na który nic innego w pliku nie wskazuje; to font, który drugi zapis w przeciwnym razie wyrzuciłby
procedure CheckNoteAcrossTwoSaves(const SrcFile, Out1, Out2: string);
var
  Book: IXLSWorkbook;
  Note: TXLSComment;
  RunCount: Integer;
  SecondRunAt: Word;
begin
  // Wywołania Assert to własne sprawdzenia testowe
  Book := TXLSWorkbook.Create;
  Assert(Book.Open(SrcFile) = 1);          // zapisany przez Excela, C2 ma dwa runy
  Note := Book.Sheets[1].Range['C2', 'C2'].Comment;
  Assert(Note <> nil);
  RunCount := Note.TextRuns.Count;
  SecondRunAt := Note.TextRuns.CharIndex[2];

  Book.Sheets[1].Range['C2', 'C2'].Copy(Book.Sheets[1].Range['E5', 'E5']);
  Book.Sheets[1].Range['C1', 'C1'].Insert(xlShiftDown);   // C2 przesuwa się na C3
  Assert(Book.SaveAs(Out1) = 1);

  Book := TXLSWorkbook.Create;               // generacja druga
  Assert(Book.Open(Out1) = 1);
  Assert(Book.SaveAs(Out2) = 1);

  Book := TXLSWorkbook.Create;               // otwórz ponownie, nigdy nie ufaj pamięci
  Assert(Book.Open(Out2) = 1);
  Note := Book.Sheets[1].Range['C3', 'C3'].Comment;
  Assert((Note <> nil) and (Note.TextRuns.Count = RunCount));
  Assert(Note.TextRuns.CharIndex[2] = SecondRunAt);
  Assert(Note.TextRuns.FontIndex[2] <> 4);
  Note := Book.Sheets[1].Range['E5', 'E5'].Comment;
  Assert((Note <> nil) and (Note.TextRuns.Count = RunCount));
end;
Liczba runów i przesunięcia startowe łapią spłaszczone notatki. Sam font potrzebuje jednego kroku poza testem: otwórz Out2 w przeglądarce rekordów, przepuść ifnt każdego runa przez FontIndexToRecordNo i potwierdź, że rekord FONT, na który trafia, niesie tę samą nazwę fontu co w pliku źródłowym. W Excelu zgubiony font wychodzi jako domyślna czcionka na drugim runie notatki C3
Klasyczne XLS wciąż pojawiają się w mnóstwie projektów Delphi i C++Builder, a każdy konsument fontów w pliku BIFF8 musi zgadzać się co do §2.5.129, żeby wyjście otwierało się poprawnie w Excelu. HotXLS, arkuszowy komponent dla Delphi, stosuje numerację skip-4 w formatach komórek, współdzielonych stringach, komentarzach, polach tekstowych i wykresach, renumeruje runy przy każdym zapisie i przenosi je po wartości między skoroszytami, czytając i pisząc XLS i XLSX bez Excela i automatyzacji OLE