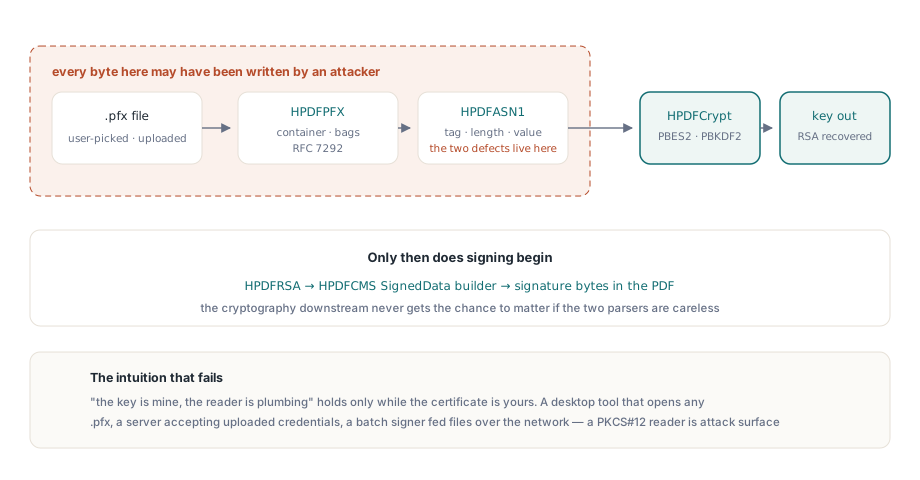
Kiedy podpisujesz plik PDF, zazwyczaj myślisz o kluczu podpisującym jako o czymś, co kontrolujesz. Znajduje się on w wygenerowanym przez Ciebie pliku .pfx, chronionym wybranym przez Ciebie hasłem. Kod, który odczytuje ten plik, wydaje się zwykłym kodem łączącym, a nie granicą bezpieczeństwa. Ta intuicja staje się błędna w momencie, gdy certyfikat przestaje być Twój. Narzędzie desktopowe pozwalające użytkownikowi wybrać dowolny plik .pfx, serwer akceptujący przesłane dane uwierzytelniające, moduł podpisywania wsadowego zasilany certyfikatami z sieci – wszystkie te elementy przekazują bajty zależne od atakującego do parsera, zanim zostanie wyprodukowany choćby jeden bajt podpisu. Czytnik PKCS#12 to powierzchnia ataku, w tym samym sensie co dekoder obrazu czy moduł ładujący czcionki
Ten artykuł przechodzi przez dwie pułapki, przed którymi musi bronić się każdy czytnik PKCS#12, obie na ścieżce importu danych uwierzytelniających podpisu, oraz przez to, jak zamyka je HotPDF. Żadna nie jest egzotyczna. Obie wychodzą z tej samej przyczyny źródłowej, która trafia niemal każdy parser binarny napisany w języku z liczbami całkowitymi o stałej szerokości: długość albo liczba z pliku jest obdarzana zaufaniem o jeden krok za daleko. Jedna prowadzi do odczytu poza zakresem, druga do procesu wiszącego, dopóki go nie zabijesz
Gdzie wędrują bajty
Importowanie pliku .pfx w celu podpisania dokumentu to nie jedna operacja, lecz krótki potok, a każdy jego etap analizuje coś, co mógł zapisać atakujący. Kontenerem jest struktura PKCS#12 zdefiniowana w RFC 7292, czyli gniazdo bezpiecznych worków (AuthenticatedSafe) owinięte wokół zaszyfrowanej osłony przechowującej klucz prywatny. Odczytanie go oznacza przejście przez ASN.1, wygenerowanie klucza z hasła, odszyfrowanie, a następnie przekazanie odzyskanego klucza RSA do kodu budującego podpis
W HotPDF etapy te są mapowane na osobne moduły. Logika kontenera PKCS#12 znajduje się w HPDFPFX. Każdy znacznik, długość i wartość, których dotyka, jest dekodowana przez czytnik ASN.1 w HPDFASN1. Generowanie klucza i deszyfrowanie PBES2 znajdują się w HPDFCrypt obok PBKDF2HMACSHA256. Po odzyskaniu klucza, moduł HPDFRSA i kreator CMS SignedData w HPDFCMS zamieniają go w odłączony podpis osadzony w pliku PDF. Publiczny punkt wejściowy, który napędza cały łańcuch, to jedno wywołanie
// Napędza cały potok: wczytaj PDF będący miejscem, sparsuj PFX,
// wyprowadź klucz, zbuduj CMS SignedData, zapisz podpisane wyjście.
if THotPDF.SignPDFWithPFX('Prepared.pdf', 'Signed.pdf',
     'signer.pfx', 'p@ssw0rd') then
  // podpis osadzony
else
  // podpisywanie nie zostało ukończone
;
Każdy bajt pliku signer.pfx przepływa przez HPDFASN1 i HPDFPFX, zanim nastąpi jakakolwiek kryptografia. Jeśli te dwa moduły nie będą ostrożne z danymi z pliku, kryptografia na dalszych etapach nigdy nie będzie miała znaczenia
Pułapka pierwsza: długość ASN.1, która zawija się poza strażnikiem
ASN.1 w DER i BER koduje każdy element jako znacznik, długość i tyleż bajtów zawartości. Długość to pole, któremu musisz ufać, ale które musisz zweryfikować, bo mówi parserowi, jak daleko czytać, a zapisał go ten, kto wyprodukował plik. X.690 §8.1.3 definiuje dwa kodowania. Forma krótka pakuje długość od 0 do 127 w pojedynczym bajcie. Forma długa, używana dla wszystkiego większego, wydaje jeden bajt wiodący, którego siedem najmłodszych bitów podaje liczbę następujących bajtów długości, po czym tyleż bajtów big-endian niesie właściwą wartość. Cztery bajty długości mogą zadeklarować rozmiar zawartości zbliżony do czterech gigabajtów
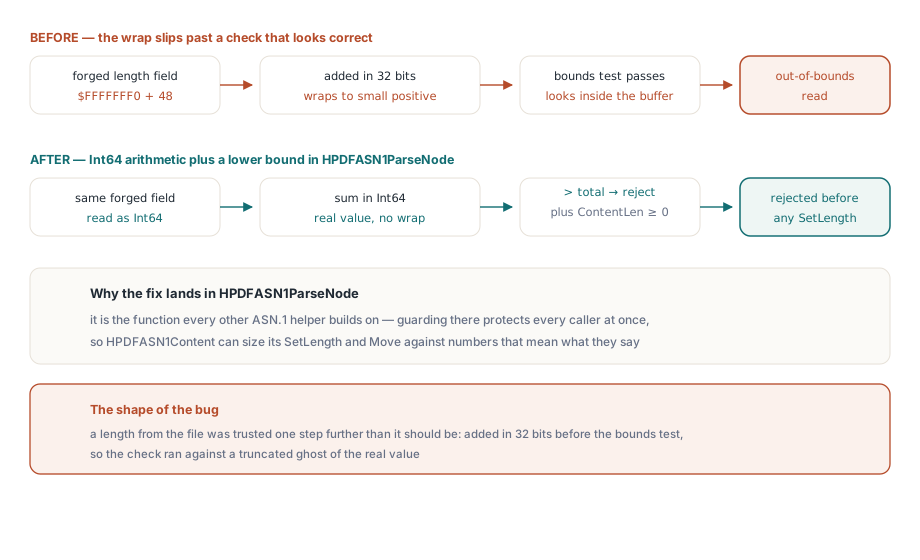
Po zdekodowaniu takiej wartości parser musi sprawdzić, czy zawartość faktycznie mieści się w buforze, zanim jej zaufa. Naturalnym testem jest potwierdzenie, że bieżąca pozycja plus długość zawartości nie wykracza poza koniec danych. Zapisane w oczywisty sposób, gdzie pozycja, długość zawartości i suma są przechowywane w 32-bitowych liczbach całkowitych ze znakiem, to zabezpieczenie jest uszkodzone:
// Pułapka: arytmetyka 32-bitowej liczby ze znakiem. Przy ContentLen bliskim MaxInt,
// Pos + ContentLen przepełnia się do WARTOŚCI UJEMNEJ, więc porównanie
// jest fałszywe i sfałszowana długość ~2 GB przechodzi wprost dalej.
if Pos + ContentLen > Total then
  raise EHPDFASN1Error.Create('content overruns buffer');
Problem polega na dodawaniu, a nie na porównywaniu. Gdy ContentLen jest bliskie MaxInt (2147483647), Pos + ContentLen powoduje przepełnienie zakresu 32-bitowej liczby ze znakiem i zawija się do liczby ujemnej. Suma ujemna nigdy nie jest większa niż Total, więc zabezpieczenie zgłasza, że wszystko jest w porządku i pozwala parserowi kontynuować pracę z długością zawartości wynoszącą około dwóch gigabajtów, której bufor nie zawiera. To, co dzieje się dalej, to uszkodzenie: czytnik przydziela bufor dla tej zadeklarowanej długości i kopiuje do niego dane, wykonując SetLength, a następnie Move z odczytem ze źródła. Źródło ma tylko kilkaset bajtów, więc kopiowanie czyta daleko poza końcem wejścia – jest to odczyt poza zakresem, który w najlepszym przypadku powoduje awarię, a w najgorszym ujawnia sąsiednią pamięć procesu do parsera
Jedyne poprawne zabezpieczenie poszerza sumę pośrednią przed porównaniem, więc dodawanie nie może przepełnić typu, w którym jest liczone. HotPDF promuje oba operandy do Int64:
// Poprawnie: oba operandy poszerzone do Int64 przed dodaniem, więc suma
// nie może się zawinąć. Sfałszowana długość 2 GB teraz zawodzi przy sprawdzeniu zakresu.
if ContentLen < 0 then
  raise EHPDFASN1Error.Create('negative content length after decoding.');
if Int64(Pos) + Int64(ContentLen) > Int64(Total) then
  raise EHPDFASN1Error.Create('content overruns buffer');
Int64 mieści sumę dwóch wartości 32-bitowych bez straty, więc porównanie widzi prawdziwą liczbę i odrzuca podrobioną długość. Osobne sprawdzenie nieujemności ContentLen zamyka pasujący przypadek, w którym zdekodowana wartość sama z siebie wyląduje ujemna. W HotPDF ten strażnik mieszka w HPDFASN1ParseNode, funkcji produkującej węzeł, na którym buduje się każdy inny pomocnik. Ponieważ HPDFASN1Content wymiaruje swoje SetLength i Move wprost z długości zawartości węzła, węzeł, który przeszedłby przez słaby strażnik, zatrułby każdy odczyt pobrany z niego. Wyegzekwowanie granicy w punkcie dekodowania to to, co czyni pomocników powyżej bezpiecznymi
Pułapka druga: liczba iteracji PBKDF2 użyta jako broń
Druga wada to nie błąd pamięci, lecz plik mówiący procesorowi, jak ciężko ma pracować. PKCS#12 chroni materiał klucza za pomocą PBES2, schematu opartego na haśle z PKCS#5, opisanego w RFC 8018. PBES2 uruchamia funkcję wyprowadzania klucza, tutaj PBKDF2 z HMAC-SHA-256, a następnie szyfr, tutaj AES-256-CBC. PBKDF2 przyjmuje liczbę iteracji, a ta liczba to parametr przenoszony w pliku. Jej jedynym celem jest spowolnienie procesu: większa liczba iteracji oznacza, że każda próba odgadnięcia hasła kosztuje więcej, co jest dobre przeciwko atakującemu offline. RFC 8018 §4.2 wyraźnie wskazuje, że większa liczba jest lepsza dla bezpieczeństwa i celowo nie ustawia górnego limitu
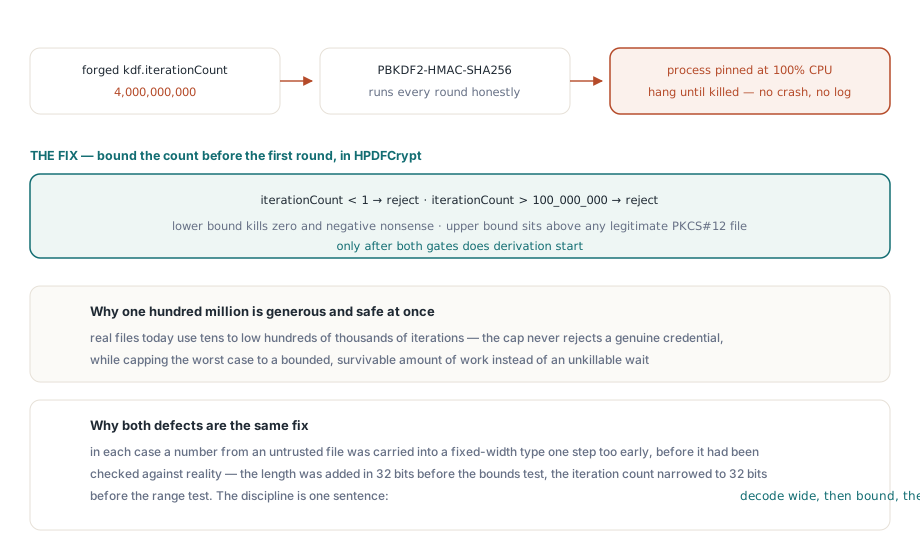
Ta otwartość jest w porządku, gdy to Ty wygenerowałeś plik. Staje się ona bronią, gdy plik został utworzony przez atakującego. Liczba iteracji to współczynnik pracy kontrolowany przez atakującego, a to z kolei stanowi odmowę usługi o złożoności algorytmicznej (DoS). Sfałszowany plik .pfx może zakodować liczbę iteracji w miliardach; parser posłusznie ją odczytuje i wywołuje PBKDF2 dla tak wielu rund HMAC-SHA-256, a proces znika w pętli, która nie powróci przez minuty lub godziny po podaniu jednego pliku. Na serwerze podpisującym, który obsługuje jedno uwierzytelnienie na żądanie, pojedyncze spreparowane przesłanie blokuje wątek roboczy
Liczba pogarsza zawinięcie, zanim sprawi, że procesor zacznie się kręcić. Wartość iteracji żyje w pliku jako ASN.1 INTEGER, który nie ma stałej szerokości, podczas gdy pole, które PBKDF2 ostatecznie konsumuje, to 32-bitowy Integer. Zdekoduj INTEGER wprost do tego pola, a duża wartość się obetnie, a wartość skonstruowana, by wylądować na bicie znaku, wróci ujemna albo jako jakaś niepowiązana mała liczba, więc nawet rozmiar pracy nie jest już tym, o co plik wyglądał na proszący. HotPDF czyta wartość w pełnej szerokości i ogranicza ją przed zawężeniem:
// Przeczytaj liczbę iteracji najpierw jako Int64, potem ogranicz do rozsądnego pasma
// ZANIM zostanie zwężona do 32-bitowego pola Iterations używanego przez PBKDF2.
LIter := HPDFASN1ToInteger(Data, Node);          // zwraca Int64
if (LIter < 1) or (LIter > 100000000) then
  raise EHPDFPFXError.CreateFmt(
    'PBKDF2 iteration count %d is outside the accepted range 1..100000000',
    [LIter]);
Iterations := Integer(LIter);                    // bezpieczne: już ograniczone
Odczyt do Int64 oznacza, że zdekodowana wartość jest tą rzeczywistą, a nie jej obciętym duchem. Dolna granica odrzuca liczby zerowe i ujemne, które są bezsensowne przy generowaniu klucza. Górna granica, sto milionów, plasuje się znacznie powyżej jakiegokolwiek legalnego pliku PKCS#12, który obecnie używa od kilkudziesięciu do kilkuset tysięcy iteracji, jednocześnie ograniczając najgorszy przypadek do skończonej, możliwej do przetrwania ilości pracy. Dopiero po przejściu tego zakresu wartość jest zawężana do pola 32-bitowego, więc obcięcie nie może już nikogo zaskoczyć. W HotPDF to ograniczenie znajduje się w ParsePBES2Params, gdzie parametry PBKDF2 są dekodowane w drodze do PBKDF2HMACSHA256
Dlaczego oba strażniki to ten sam strażnik
Dwie pułapki wyglądają różnie — jedna to przepełnienie bufora, druga wiszący proces — ale to ta sama pomyłka. W każdym przypadku liczba z niezaufanego pliku trafia do typu o stałej szerokości o jeden krok za wcześnie, zanim zostanie skonfrontowana z rzeczywistością. Długość jest dodawana w 32 bitach przed testem granicznym; liczba iteracji jest zawężana do 32 bitów przed testem zakresu. Obie ulegają tej samej dyscyplinie: dekoduj w pełnej szerokości, sprawdź względem prawdziwego limitu i dopiero wtedy zawężaj. Pośredni Int64 to nie wybór stylistyczny, to jedyna szerokość, w której strażnik widzi wartość, którą atakujący faktycznie zapisał. Granica, która się przepełnia, nie jest granicą, a liczba bez sufitu nie jest parametrem — to zdalny przepustnik na twoim własnym procesorze
Praktyczne wskazówki dla potoku podpisującego
Wąska lekcja polega na tym, by walidować niezaufane certyfikaty wejściowe tak, jak każdą niezaufaną zawartość przesyłaną na serwer. Ogranicz rozmiar pliku .pfx, który akceptujesz, ponieważ legalny plik ma rozmiar kilkuba jtowy, a nie megabajtowy. Traktuj niepowodzenie analizy jako rutynowe odrzucenie danych wejściowych, a nie błąd warty wyświetlania śladu stosu użytkownikowi. Jeśli podpisujesz na serwerze, uruchamiaj import tam, gdzie zablokowany proces roboczy nie może wyłączyć usługi, i ustaw limit czasu operacji, aby nieoczekiwanie kosztowny plik był ograniczony czasem zegarowym, a także limitem iteracji
Szersza lekcja wykracza poza certyfikaty. Zabezpieczanie parsera to nie jednorazowy audyt jednego modułu, lecz cecha każdego miejsca, w którym Twoja biblioteka odczytuje bajty, których sama nie zapisała. Biblioteka PDF analizuje wiele rzeczy z niezaufanych źródeł: czcionki osadzone w dokumencie, obrazy w pół tuzinie kodeków, filtry strumieni oraz, na ścieżce podpisów, certyfikaty. Każde z nich to powierzchnia ataku i każde zasługuje na taką samą podejrzliwość wobec każdej długości i każdej liczby. HotPDF buduje ścieżkę importu i podpisów na bazie zabezpieczonych modułów HPDFASN1, HPDFPFX, HPDFCrypt i HPDFCMS opisanych tutaj, dzięki czemu przekazywane dane uwierzytelniające, niezależnie od ich pochodzenia, są analizowane defensywnie, zanim zostaną obdarzone zaufaniem
Przebieg podpisów chroniony przez te testy został omówiony od początku do końca w naszym przewodniku po podpisach cyfrowych PAdES w Delphi, a ta sama obronna postawa zastosowana do szyfrowania dokumentów, w tym ścieżka klucza AES-256 współdzieląca tę bazę kodu, została opisana w artykule na temat szyfrowania AES-256 i bezpieczeństwa. Wszystko to jest dostarczane jako część komponentu HotPDF Delphi Component dla Delphi i C++Builder wraz z interfejsami API do ładowania, edycji, szyfrowania i podpisywania omówionymi w innych miejscach tego bloga