Otagowany raport z wyciętą stroną okładki może otwierać się z właściwą liczbą stron i mimo to być uszkodzony w trzech miejscach: zakładka „Contents" nie reaguje na kliknięcie, tester dostępności zgłasza element struktury nienależący do żadnej strony, a ścisły walidator wyłapuje odwołanie do obiektu wolnego. Drzewo stron jest w porządku. ISO 32000-1 §7.7.3 żąda tylko, aby strona zniknęła z /Kids i aby /Count zmniejszył się o jeden, i plik może spełniać ten punkt, gdy połowa jego katalogu wciąż wskazuje na brakującą stronę
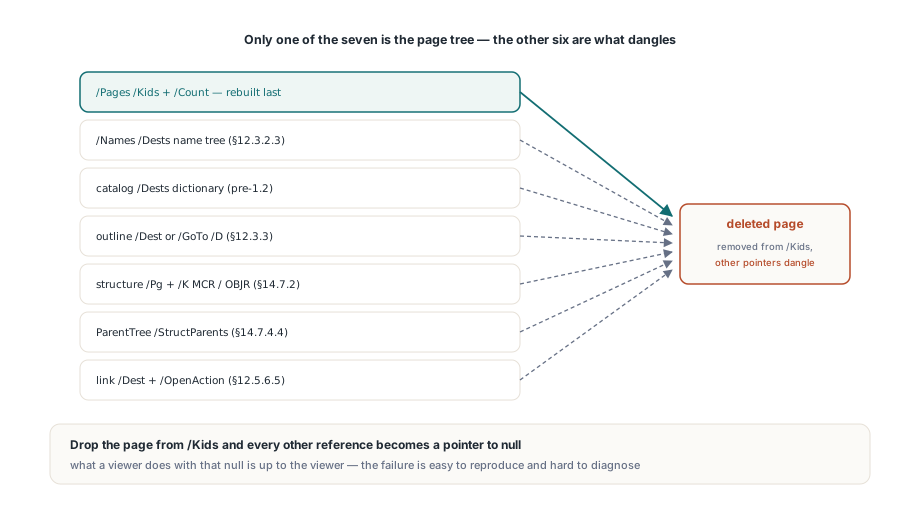
Siedem struktur może trzymać odwołanie do jednej strony
Tylko jedna z nich to drzewo stron. Reszta rozciąga się na katalog, konspekt, strukturę logiczną i adnotacje innych stron, i każda z nich rozwiązuje się do null, gdy tylko obiekt strony zniknie z pliku. Co przeglądarka zrobi z tym nullem, to jej wybór, więc ten sam przycięty plik może zachowywać się różnie w dwóch czytnikach
- Drzewo nazw pod
/Names/Dests(§7.7.4, §12.3.2.3) mapuje nazwy na tablice miejsc docelowych, których pierwszym elementem jest strona - Słownik
/Destssprzed wersji 1.2, wprost w katalogu, trzyma tablice tego samego rodzaju, kluczowane nazwą - Elementy konspektu (§12.3.3) sięgają strony przez wprost podane
/Destalbo przez akcję/Az/S /GoToi tablicą/D - Elementy struktury (§14.7.2) niosą klucz
/Pgnazywający stronę, na której żyje ich oznaczona zawartość, a ich dzieci w/Kmogą być odwołaniami do oznaczonej zawartości i odwołaniami do obiektów (§14.7.4.3) związanymi z tą stroną ParentTree(§14.7.4.4) mapuje numery/StructParentsstron i adnotacji z powrotem na elementy struktury, a element może tam siedzieć, nie pojawiając się nigdzie w łańcuchu/Kod korzenia- Adnotacje odsyłaczy na innych stronach (§12.5.6.5) niosą
/Destalbo akcję/GoTocelującą w stronę, a katalogowe/OpenActionmoże robić to samo
Co THotPDF.DeletePage robi, zanim dotknie /Kids
THotPDF.DeletePage(PageIndex) na wczytanym dokumencie najpierw przeczesuje każdą z tych struktur, a drzewo stron przepisuje na końcu. Indeks jest liczony od zera. Zanim cokolwiek się zmieni, działają dwa zabezpieczenia: indeks poza zakresem podnosi Invalid page number, a żądanie usunięcia jedynej pozostałej strony też kończy się wyjątkiem, bo węzeł /Pages bez żadnego dziecka nie opisuje poprawnego dokumentu
Kolejność przeczesywania jest stała: drzewo /Names /Dests, legacy słownik /Dests w katalogu, /OpenAction, konspekt, /StructTreeRoot razem z jego ParentTree, a na końcu tablice /Annots każdej strony, która zostaje. Dopiero potem obiekt strony jest oznaczany jako usunięty, jego widgety są odczepiane od drzewa pól AcroForm, a /Kids, /Count i /Parent każdej zachowanej strony są przepisywane. Po stronie formularzy pole nadrzędne, które po zniknięciu widgetu nie ma już dzieci, również jest usuwane, aż po /Fields włącznie, więc przycięty formularz nie zostawia wpisu pola z niczym na ekranie
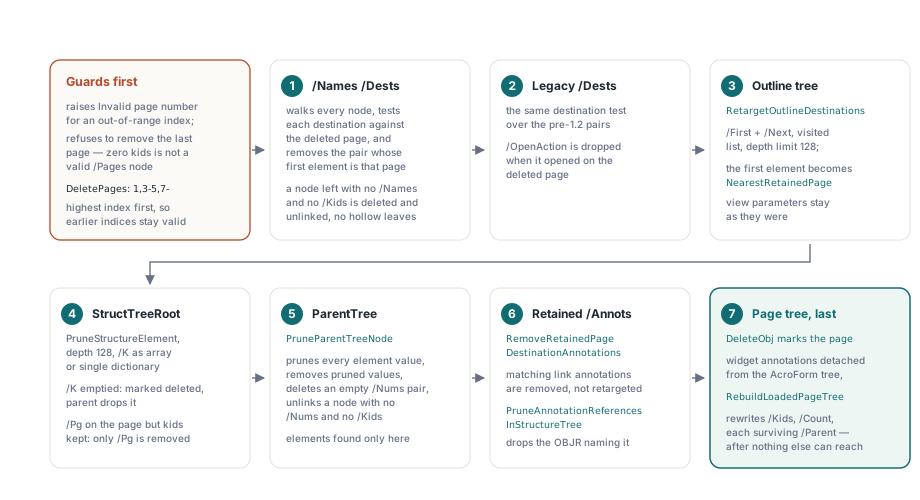
DeletePages przyjmuje oparty na jedynkach zakres w postaci łańcucha, taki jak '1,3-5,7-' — notację, której używają pozostałe operacje na stronach wczytanego dokumentu — i usuwa od najwyższej wybranej strony w dół. Przechodzenie z góry na dół utrzymuje ważność wpisanych numerów, choć strony znikają spod nich. Zakres obejmujący wszystkie strony kończy się wyjątkiem z tego samego powodu, dla którego DeletePage odmawia ostatniej strony, a funkcja zwraca liczbę usuniętych stron
var
  Pdf: THotPDF;
  Removed: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile zwraca liczbę wczytanych stron
    if Pdf.LoadFromFile('tagged-report.pdf') > 0 then
    begin
      // Indeksy od zera: strona 0 to okładka
      Pdf.DeletePage(0);
      // Zakres liczony od jedynki, względem dokumentu takim, jakim jest teraz
      Removed := Pdf.DeletePages('3-4,9');
      Pdf.SaveLoadedDocument('tagged-report-trimmed.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Nazwy znikają, zakładki zmieniają cel
Nazwane miejsca docelowe celujące w usuwaną stronę są usuwane. Zakładki celujące w nią dostają nowy cel. W drzewie /Names /Dests odwiedzony zostaje każdy węzeł, a każde miejsce docelowe jest testowane w obu formach dozwolonych przez specyfikację: gołej tablicy i słownika z kluczem /D; para nazwa/wartość znika, gdy pierwszym elementem tablicy jest usuwana strona. Węzeł pośredni, w którym nie zostaje ani /Names, ani /Kids, jest odczepiany od rodzica, więc drzewo nie trzyma wydrążonych liści. Legacy słownik /Dests w katalogu dostaje ten sam test, klucz po kluczu, a katalogowe /OpenAction, które otwierało dokument na usuwanej stronie, jest usuwane — widok początkowy zostaje domyślnemu zachowaniu przeglądarki
Węzeł, który traci wpisy, traci też swoją tablicę /Limits. Nowych skrajnych kluczy nie wylicza się od nowa, a przeglądarki rozwiązują nazwy bez nich. §7.9.6 jednak wymaga /Limits na węzłach pośrednich i liściach, więc jeśli preflight w twoim pipeline ściśle egzekwuje tę regułę, przepuść przycięty plik przez niego w tym samym zadaniu
Konspekt jest przechodzony przez /First i /Next z listą odwiedzonych i limitem głębokości 128, więc uszkodzony łańcuch /Next zapętlony w sobie nie zawiesi wywołania. Dla każdej tablicy /Dest albo tablicy /D akcji /GoTo celującej w usuwaną stronę pierwszy element jest zastępowany stroną, która następowała po niej, albo stroną poprzedzającą, gdy usuwana strona była ostatnia. Parametry widoku za odwołaniem do strony zostają bez zmian, więc skok /XYZ zachowuje swoje wartości left, top i zoom i stosuje je do nowej strony
Asymetria jest zamierzona. Nazwa, która nie rozwiązuje się do niczego, jest legalna i nieszkodliwa; GoTo wskazujące nieistniejące miejsce docelowe po prostu nic nie robi. Zakładka z miejscem docelowym null jest gorsza: wciąż siedzi na pasku bocznym, wygląda klikalnie i zawodzi. Lądowanie na najbliższej zachowanej stronie to lepszy z dwóch niedoskonałych wyników. Zmiana celu obejmuje tylko jawne tablice miejsc docelowych. Element konspektu, którego /Dest jest łańcuchem nazwy, rozwiązuje się przez drzewo nazw, a gdy przeczesywanie usunęło już tę nazwę, zakładka nie prowadzi nigdzie — dokumenty intensywnie używające nazwanych zakładek zasługują po usunięciu na sprawdzenie. Test poniżej czyta nazwy przez ResolveLoadedNamedDestination, które patrzy wyłącznie na tablicę /Names węzła korzenia; daje sensowną odpowiedź dla płaskiego drzewa nazw, natomiast drzewo podzielone na /Kids zwraca -1 dla każdej nazwy. Sama struktura konspektu, łącznie z nieoczywistą semantyką /Count, jest opisana w przewodniku po dodawaniu zakładek i nazwanych miejsc docelowych we wczytanym PDF
// Sprawdź wynik zamiast go zakładać.
// Memo1 to TMemo na twoim formularzu.
Pdf.DeletePage(0);
// ResolveLoadedNamedDestination czyta tylko korzeniową tablicę /Names,
// więc ten test ma sens dla płaskiego drzewa nazw; na drzewie
// z /Kids zwraca -1 dla każdej nazwy, usuniętej czy nie
if Pdf.ResolveLoadedNamedDestination('cover') = -1 then
  Memo1.Lines.Add('"cover" is not resolvable from the root /Names array');
// Zakładka, która wskazywała okładkę, rozwiązuje się teraz do strony,
// która następowała po niej, czyli indeksu 0 po usunięciu
Memo1.Lines.Add(Format('Bookmark "Contents" -> page index %d',
  [Pdf.GetLoadedBookmarkPageIndex('Contents')]));
Przycinanie drzewa struktury i ParentTree
Elementy struktury, które istniały wyłącznie dla usuwanej strony, są usuwane, a elementy rozciągające się na kilka stron tracą klucz /Pg, zachowując dzieci. Przejście startuje od /StructTreeRoot, schodzi po /K do głębokości 128 i akceptuje zarówno formę tablicową, jak i jednosłownikową formę /K, na którą pozwala §14.7.2. Dzieci każdego elementu przycina się, zanim osądzony zostanie sam element. Jeśli przycięcie opróżniło jego /K, element jest usuwany, a rodzic go zrzuca. Jeśli jego własny /Pg nazywa usuwaną stronę, ale ma jeszcze dzieci i rodzica /P, znika tylko /Pg, bo /Pg na elemencie to jedynie domyślna strona dla dzieci z oznaczonej zawartości, które nie nazywają własnej, a te dzieci mogą mieszkać na innych stronach. Element, którego /Pg to usuwana strona i który nie ma nic pod sobą, jest usuwany całkowicie; słowniki odwołań do oznaczonej zawartości, których /Pg nazywa tę stronę, podpadają pod tę samą regułę
ParentTree dostaje to samo traktowanie, i to z powodu, który łatwo przeoczyć: element może być osiągalny z ParentTree i znikąd indziej. To drzewo numeryczne mapuje liczby całkowite /StructParents na pojedynczy element albo tablicę elementów. Każda wartość jest przycinana według reguł powyżej, usunięte wartości wypadają ze swoich tablic, para /Nums z pustą tablicą jest usuwana, a węzeł bez /Nums i bez /Kids jest odczepiany. Pomiń ten etap, a sieroty wciąż będą wskazywać uwolnioną stronę przez /Pg. Dla kogoś, kto wyciąga tekst w kolejności tagów, to oczywiste: wyodrębnianie tekstu w kolejności struktury przechodzi dokładnie te drzewa, a element z /Pg równym null to akapit, który wypada z kolejności czytania
Dlaczego łącza na zachowanych stronach są usuwane, a nie przepinane?
Adnotacja odsyłacza na zachowanej stronie, której tablica /Dest albo akcja /GoTo celuje w usuwaną stronę, jest usuwana z tablicy /Annots tej strony, a jej tag idzie za nią. Słownik OBJR, którego /Obj wskazywało tę adnotację, jest wyciągany z jej elementu struktury; jeśli ten OBJR był jedynym dzieckiem elementu, usuwany jest też element, a ParentTree jest przycinane ponownie. Pozostawienie OBJR złamałoby §14.7.4.3, który oczekuje, że /Obj wskazuje prawdziwy obiekt, a checker PDF/UA zobaczyłby element Link, którego odwołanie do obiektu nie prowadzi nigdzie
Zakładki zmieniają cel; łącza nie. Odsyłacz w treści, który mówi „zobacz stronę 3", jest nieprawdziwy, gdy strona 3 znika, a po cichu przepięcie go na stronę 4 zamienia zepsute łącze w mylące. Zakładka lądująca na następnym rozdziale to nawigacja; łącze w treści to twierdzenie o zawartości. Usunięcie jest bezpieczniejszym domyśłem. Jeśli twój workflow potrzebuje, by te łącza przetrwały, przepisz ich miejsca docelowe przed wywołaniem DeletePage, bo po wywołaniu są już poza tablicami /Annots
Zapisy przyrostowe i pułapka bezpośredniego dziecka
DeletePage zachowuje się tak samo między BeginIncrementalUpdate a SaveIncrementalUpdate. Dopisywana sekcja trzyma obiekty zmienione przez przeczesywanie plus wpisy wolne dla usuniętych obiektów, które miały własne numery obiektów, jak strona i usunięte adnotacje odsyłaczy. Wszystko powyżej pierwotnego %%EOF zostaje bajt w bajt, jak wymaga §7.5.6
Pdf := THotPDF.Create(nil);
try
  Pdf.BeginIncrementalUpdate('tagged-report.pdf');
  Pdf.DeletePage(0);
  // Elementy struktury, które straciły bezpośrednie dziecko /MCR,
  // są dopisywane w przepisanej formie z krótszą tablicą /K
  Pdf.SaveIncrementalUpdate('tagged-report-trimmed.pdf');
finally
  Pdf.Free;
end;
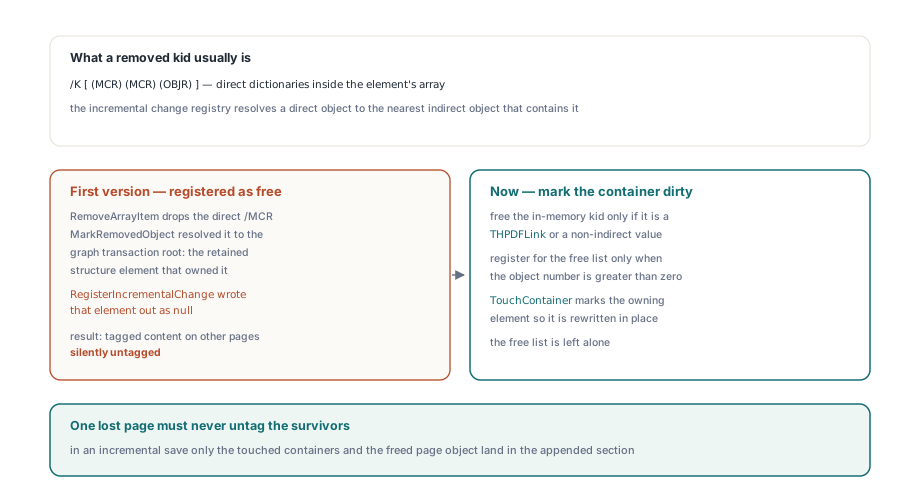
To jest miejsce, w którym ręcznie pisany pruner się potyka. Odwołania do oznaczonej zawartości (/Type /MCR) i odwołania do obiektów (/Type /OBJR) to typowo bezpośrednie słowniki siedzące w tablicy /K elementu rodzica. Obiekt bezpośredni nie ma numeru obiektu ani wpisu xref, więc nie da się go uwolnić osobno. Oczywisty ruch to mimo wszystko „uwolnienie" każdego usuniętego dziecka — i każdy writer, który mapuje obiekt bezpośredni na obiekt pośredni go trzymający, uwolni wtedy trzymacza, czyli zachowany element struktury. Ten element wychodzi jako null, a otagowana zawartość na stronach, których nikt nie ruszał, traci tagi. HotPDF wysyła usunięty obiekt na listę wolnych tylko wtedy, gdy ma własny numer obiektu; dla bezpośredniego dziecka oznacza zawierający go element jako zmieniony, więc element jest przepisywany bez dziecka, a lista wolnych zostaje czysta
Ta sama ostrożność decyduje o tym, czego DeletePage nie rusza na wczytanym dokumencie. Strumienie zawartości, XObjecty i adnotacje inne niż widgety usuwanej strony zostają jako obiekty, bo wczytany plik może dzielić każdy z nich ze stroną, która zostaje, a w momencie usuwania nie ma taniego sposobu, by udowodnić inaczej. Zrzucenie odwołania w drzewie stron wystarcza, by plik był poprawny. Ile bajtów kosztują te pozostałości, to osobny pomiar, a graf zależności obiektów i analiza zatrzymanych bajtów to narzędzie do niego
DeletePage czy DeleteLoadedPage?
Używaj DeletePage do każdego usunięcia strony, o które poprosił użytkownik. THotPDF.DeleteLoadedPage(PageIndex) to wersja lekka: stosuje te same dwa zabezpieczenia, przesuwa listę wczytanych stron, przepisuje /Kids i /Count, unieważnia cache wyrenderowanych stron i odpala OnLoadedDocumentModified. Nie dotyka drzewa nazw, konspektu, drzewa struktury ani adnotacji innych stron i nie oznacza obiektu strony jako usuniętego. ComposeLoadedPagesNUp to robota, do której pasuje: dopisuje świeżo złożone arkusze rysujące strony źródłowe jako form XObject, po czym zrzuca każdą oryginalną przez DeleteLoadedPage(0), bo arkusze odwołują się do zawartości stron, nie do obiektów stron. Przy „usuń stronę 7 z tej umowy" na pliku otagowanym, z zakładkami i łączami krzyżowymi, DeletePage to wywołanie, które zostawia każde odwołanie spójne — czy zapisujesz przez SaveLoadedDocument, czy dopisujesz przez SaveIncrementalUpdate
Obie metody, zakresowy DeletePages i użyta wyżej ścieżka aktualizacji przyrostowej, są częścią HotPDF Delphi Component, który edytuje wczytane PDF-y z kodu Delphi i C++Builder bez runtime'u przeglądarki na maszynie