Użytkownik wpisuje Müller w pole wyszukiwania, nie dostaje nic, kopiuje to samo nazwisko z PDF-a, wkleja je z powrotem w pole i nagle dostaje trafienia. Sprawdź oba ciągi w debuggerze, a Length zwróci 6 dla wpisanego i 7 dla wklejonego. Wpisane słowo niesie U+00FC, pojedynczy ü złożony z góry; dokument trzyma zwykłe u, po którym idzie U+0308 COMBINING DIAERESIS. Oba renderują się jako te same glify i porównanie po jednostkach kodowych nigdy ich nie uzna za równe
Dlaczego identycznie wyglądające ciągi porównują się jako różne?
Unicode celowo dopuszcza więcej niż jedno kodowanie tego samego abstrakcyjnego znaku i nazywa te kodowania równoważnymi kanonicznie. Unicode Standard Annex #15 definiuje dwie formy normalne istotne dla wyszukiwania: NFC, która woli punkty kodowe złożone z góry, i NFD, która rozbija każdy znak złożony na literę bazową plus jej znaki łączące w ustalonym porządku. Litery łacińskie z diakrytykami istnieją w obu postaciach. Sylaby hangul też, bo mogą wystąpić jako jedna sylaba złożona albo jako ciąg dwóch lub trzech łączących się jamo
Która postać wyląduje w PDF-ie, zależy od oprogramowania, które go wyprodukowało, platformy, na której biegało, a czasem od tego, jak zbudowano mapę ToUnicode fontu. Dokument pisany na jednej maszynie i edytowany na drugiej może mieszać obie formy na tej samej stronie. Nic z tego nie jest widoczne dla osoby szukającej. Jej klawiatura i metoda wprowadzania produkują zwykle NFC, więc każda rozłożona treść w pliku staje się z jej strony nieosiągalna dla wyszukiwania
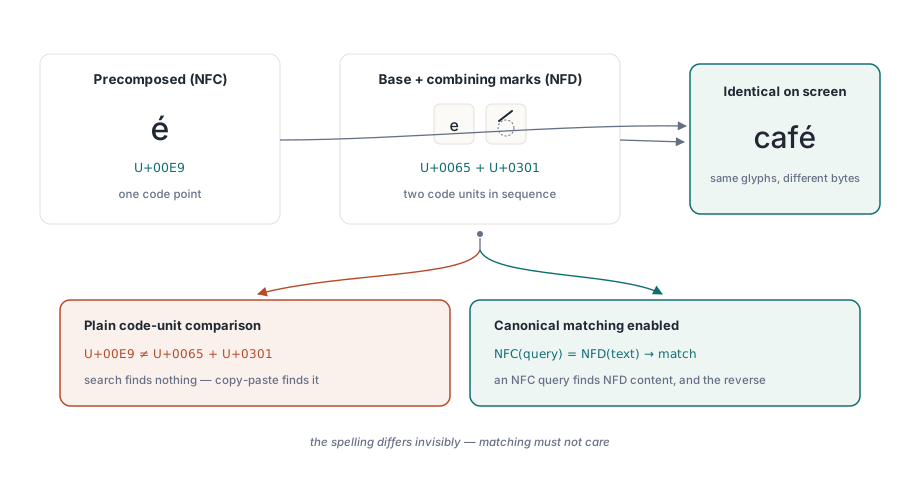
Oczywiste obejście — wrzucić problem do worka zwijania wielkości liter: zminiaturować obie strony, zedrzeć akcenty, porównać — łamie się z powodu strukturalnego. Zwijanie wielkości liter i zdrapywanie akcentów są jedno-jedno na poziomie jednostek kodowych, więc złożony tekst ma dokładnie tę samą długość co oryginał i trafienie na pozycji 17 w złożonej kopii to trafienie na pozycji 17 w wyekstrahowanym tekście. Normalizacja zmienia długości. Jedna litera złożona staje się dwiema lub trzema jednostkami kodowymi, rozłożona sekwencja zapada się z powrotem w jedną, sylaby hangul rozszerzają się w jamo, a po tej transformacji pozycje, które dostajesz z powrotem, nie wskazują już na tekst, który wyekstrahowałeś
Wyszukiwanie z soCanonicalEquivalent w PDF Library for Delphi
W PDF Library for Delphi składnik soCanonicalEquivalent zbioru TPDFlibSearchOptions każe SearchText porównywać kanoniczne rozkłady zapytania i tekstu strony, więc zapytanie w NFC znajduje treść w NFD i zapytanie w NFD znajduje treść w NFC. Opcja jest składnikiem zbioru, więc łączy się z soWholeWord, soCaseSensitive, soWildcards i soDiacriticInsensitive bez żadnego osobnego API:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // wypełnia ContextBefore / ContextAfter
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // pusty zakres stron = wszystkie strony

    // Found liczy każde trafienie; skopiowano tylko pierwsze Length(Hits)
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
Dwa szczegóły w tej pętli wywracają ludzi. SearchText zwraca całkowitą liczbę trafień nawet wtedy, gdy bufor jest mniejszy, więc iteracja po Found - 1 na dużym dokumencie wybiega za koniec 500-elementowej tablicy; zaciśnij przez Min albo przejdź na SearchTextEach, które podaje każde trafienie do callbacku i nie potrzebuje bufora wcale. A MatchText to cały blok tekstu, który zawierał trafienie, z MatchStart jako indeksem od 1 w jego obrębie, więc dopasowane słowo samo jest tym Copy pokazanym wyżej
Uruchom to na pliku, który trzyma Bäcker rozłożone, a wypisana długość wyniesie 7; na pliku NFC będzie 6. To samo zapytanie, ten sam zbiór opcji. Wycinek jest zawsze tekstem takim, jaki leży w dokumencie
Gdzie trafienie ląduje w oryginalnym tekście
Ta ostatnia własność jest tym, co czyni znormalizowane wyszukiwanie użytecznym poza odpowiedzią tak/nie. PDF Library for Delphi zapisuje, dla każdej jednostki kodowej, którą produkuje normalizator, początek i koniec oryginalnego zakresu UTF-16, z którego powstała. Rekurencyjny rozkład dziedziczy zakres swojego rodzica, kompozycja scala zakresy swoich wejść, a gdy znaleziono trafienie, wyszukiwanie skanuje zmapowany przedział w poszukiwaniu najmniejszego początku i największego końca
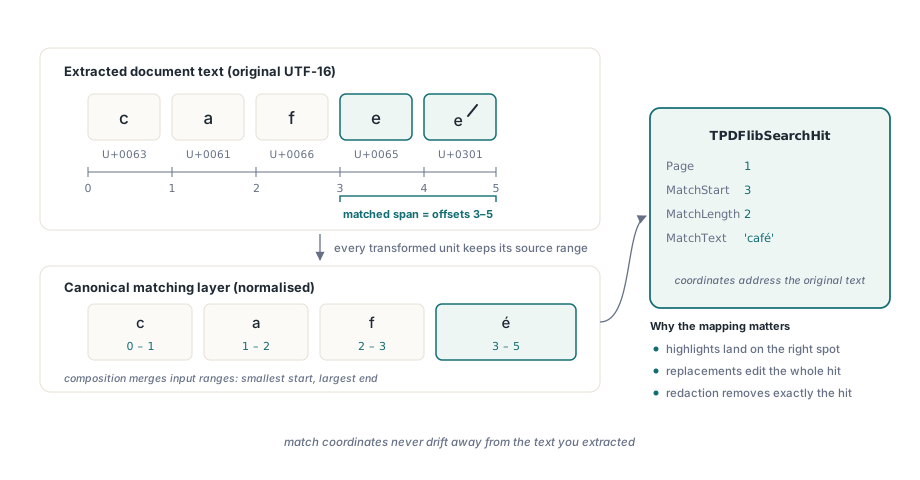
Dzięki temu MatchStart, MatchLength, ContextBefore, ContextAfter i oba punkty wejścia zastępowania adresują wyekstrahowany tekst, który wywołujący już ma. Wyszukiwanie, które potrafiłoby powiedzieć "w tym bloku jest trafienie", ale nie dokładnie gdzie, wystarczyłoby do licznika wyników i waliłoby się przy czymkolwiek innym: podświetlenia dryfowałyby o znak-dwa na każdą literę z akcentem, a zastąpienie przepisałoby zły ciąg tekstu
Normalizator jedzie w środku biblioteki. Niesie zwarte tabele rozkładu kanonicznego, kompozycji i kanonicznej klasy łączenia z Unicode 15.1, stosuje reguły algorytmiczne dla hangulu zamiast wpisów tabelarycznych i stabilnie porządkuje znaki łączące podczas NFD. Żaden zewnętrzny plik danych nie jest wczytywany i żadne wywołanie normalizacji systemowej nie jest robione, więc serwis Windows, demon Linuksa i kompilacja Free Pascal zwracają identyczne trafienia dla tego samego pliku. Wolimy to tak, choć system mógłby wykonać robotę na Windows: indeks wyszukiwania zbudowany na jednym serwerze i odpytywany na drugim nigdy nie powinien się różnić dlatego, że obie maszyny biegały na innych wersjach Unicode
Opcja jest domyślnie wyłączona i ten domyślny jest rozsądny. Budowanie tekstu NFD i jego mapy pozycji kosztuje czas, a wyszukiwanie po fakturach czysto ASCII nigdy go nie potrzebuje. Gdy soCanonicalEquivalent jest ustawione, każdy blok tekstu trzyma dwie przekształcone kopie — jedną ze znakami łączącymi i jedną bez — więc partia zapytań po tym samym bloku normalizuje go raz. Zwykłe zwijanie wielkości liter zostaje na tańszej ścieżce jedno-jedno
Co się psuje, gdy trafienie kończy się w środku znaku?
Równoważność kanoniczna odpowiada na "czy to ten sam tekst", ale nie mówi nic o tym, gdzie trafieniu wolno się skończyć. Przeszukaj rozłożone café o cafe z samym soCanonicalEquivalent, a pierwsze cztery jednostki kodowe się zgadzają; łączący akut, który idzie za nimi, zostaje poza trafieniem. soWholeWord tego nie łapie, bo jego znaki słowne idą za regułami identyfikatorów (litery ASCII, cyfry i podkreślnik), a znak łączący liczy się jako granica. Podświetlenie pokrywa cafe, a zastąpienie zostawia osierocony akcent wiszący nad tym, co przyjdzie potem
To samo dzieje się daleko poza łacińskimi akcentami. Emoji flagi to dwa punkty kodowe wskaźników regionalnych. Emoji rodziny to kilka postaci złączonych łącznikami zerowej szerokości. Devanagaryjska ligatura to spółgłoska, wirama i kolejna spółgłoska, a wietnamska samogłoska może nieść dwa nałożone znaki. Cokolwiek poza Basic Multilingual Plane jest w UTF-16 parą surogatów, a przecięcie jej na pół produkuje niesparowanego surogata, który wiele potoków tekstowych podmienia na U+FFFD
soGraphemeClusters wymaga, by oba końce każdego trafienia, literalnego i wieloznacznego, padały na granicach rozszerzonych klastrów grafemów z definicji Unicode Standard Annex #29. Segmentacja obejmuje parowanie CR/LF, znaki sterujące, typy sylab hangul, Extend i SpacingMark, Prepend, sekwencje ZWJ emoji, pary wskaźników regionalnych i podziały indyjskich ligatur, i nigdy nie stawia granicy wewnątrz pary surogatów. Z flagą cafe w ogóle nie dopasuje rozłożonego café; dołóż soDiacriticInsensitive, jeśli ślepe na akcenty dopasowanie jest tym, czego naprawdę chcesz
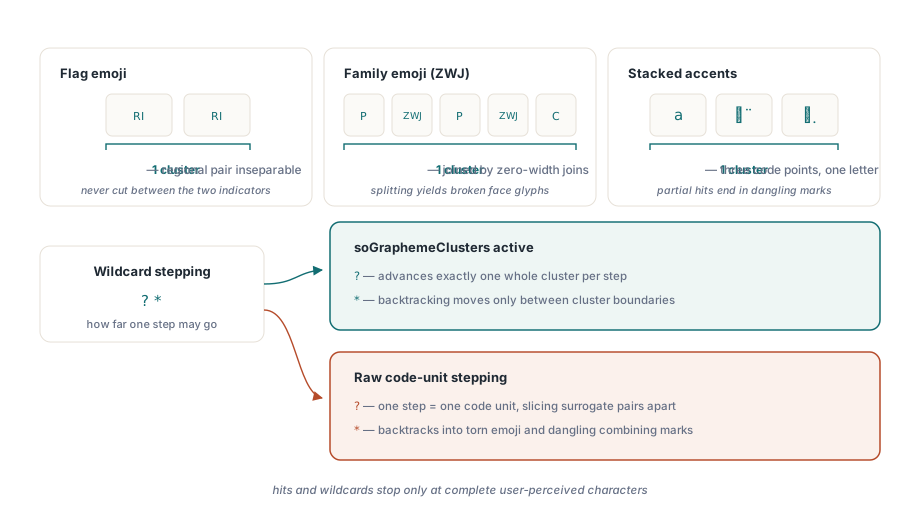
Na wildcardach flaga zmienia wyniki najbardziej widocznie. Pod soCanonicalEquivalent tekst strony jest porównywany w NFD, więc côté staje się c o U+0302 t e U+0301 niezależnie od tego, jak plik go zapisał. Bez soGraphemeClusters ? w c?té konsumuje dokładnie jedną jednostkę kodową — o — po czym oczekuje t i znajduje U+0302. Zero trafień. Z flagą ? przesuwa się o cały klaster, a backtrack dla * rusza się też wyłącznie między granicami klastrów:
// "?" kroczy po jednym znaku postrzeganym przez użytkownika, więc to dopasowuje côté
// niezależnie od tego, czy PDF trzymał je złożone, czy rozłożone
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// Zastąpienie używa tych samych zakresów bezpiecznych dla klastrów, więc nigdy
// nie rozbije emoji ani nie zostawi osieroconego akcentu
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent przepisuje tekst wewnątrz treści strony i zwraca liczbę zastąpionych trafień. Gdy zwraca zero, GetLastUnicodeReplacementDiagnostics mówi dlaczego — na przykład że trafienia nie da się zmapować z powrotem do treści, która go narysowała. Drugi punkt wejścia, SearchAndReplaceText, przyjmuje ten sam zbiór opcji i kładzie zastąpienie na dopasowanym bloku zamiast tego
Dobór zbioru opcji per obciążenie
Trzy kombinacje pokrywają większość aplikacji. Dla użytkowniczego pola wyszukiwania w przeglądarce dokumentów użyj soCanonicalEquivalent plus soDiacriticInsensitive: obie formy kodowania dopasowują się, i pisownia z akcentami, i bez, czego ludzie oczekują po latach wyszukiwania w sieci. Dla przeglądu prawnego albo zgodnościowego, gdzie fałszywe trafienie kosztuje kogoś popołudnie, użyj soCanonicalEquivalent z soCaseSensitive i soWholeWord i zostaw zwijanie akcentów wyłączone, żeby równoważność była ścisła, przy ignorowaniu tego, jak plik akurat zakodował treść
Dla wszystkiego, co zmienia dokument, dokładaj soGraphemeClusters za każdym razem. To jedyny punkt, którego nie zostawilibyśmy gustowi. Wyszukiwanie zwracające zakres krótszy o jednostkę kodową tylko wprowadza w błąd czytającego wyniki; zastąpienie albo usunięcie używające tego samego zakresu wpisuje pomyłkę do pliku, a nikt tego nie zauważy, dopóki strona nie zostanie wydrukowana albo wyekstrahowana ponownie. Usuwanie, które ma zniszczyć treść, a nie zakryć ją, to osobny temat — prawdziwa redakcja i usuwanie treści
Gdy kilka terminów biega po tym samym dokumencie, sięgaj po SearchTextBatch. Wylicza każde niepuste zapytanie, dopóki bloki tekstu strony są rezydentne, więc każda strona jest ekstrahowana raz i każdy blok normalizowany raz, a każde zapytanie niesie własny zbiór opcji:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // hangul: NFC albo jamo w pliku
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
Trafienia wracają uporządkowane po stronie, potem bloku, potem zapytaniu, a QueryIndex to pozycja od zera w tablicy, którą przekazałeś. SearchTextBatchEach to forma callbackowa dla zbiorów wyników, których z góry nie zwymiarujesz. Jak bloki tekstu są w ogóle ekstrahowane, opisuje wyszukiwanie tekstu i enumeracja elementów strony
Pisma, w których równoważność kanoniczna nie jest opcją
Dla koreańskiego równoważność kanoniczna rozstrzyga, czy nazwisko w ogóle zostanie znalezione, bo sylaby złożone i rozłożone jamo obie zdarzają się w prawdziwych dokumentach. Wietnamski nakłada znak tonu na samogłoskę, która może już nieść breve albo cyrkonia, więc jego forma kompozycji zależy wyłącznie od producenta. Dla dewanagari, bengalskiego i pozostałych pism indyjskich reguły ligatur rozstrzygają, czy granica trafienia wyląduje gdzieś, gdzie czytelnik ją rozpozna. Japoński i chiński są po stronie wyszukiwania porównawczo łatwe, choć po stronie układu już nie — temu służy artykuł o piśmie pionowym dla japońskiego i chińskiego
Nasza rekomendacja jest bez ogródek. Jeśli korpus zawiera jakikolwiek język inny niż angielski, włącz soCanonicalEquivalent najpierw i wyłącz dopiero po zmierzeniu go na własnych dokumentach i uznaniu kosztu za nieakceptowalny. Awaria, której to zapobiega, ląduje dokładnie na nazwiskach, których użytkownicy szukają najczęściej
Ten sam silnik świadomy Unicode napędza wyszukiwanie, ekstrakcję, zastępowanie i redakcję z Delphi, C++Buildera i Free Pascala; zbiory opcji, API wsadowe i reszta zestawu narzędzi tekstowych są wypisane na stronie produktu PDF Library for Delphi