Słownik enkodera LZW jest zawsze o jeden wpis przed dekoderem, który będzie czytał jego wyjście, więc obie strony nie mogą współdzielić jednego progu szerokości kodu. PDFlibPas daje TPLLZWEncoder i TPDFLZWDecompressor osobne progi wyprowadzone z tej samej flagi EarlyChange, a to jednopunktowe wyprzedzenie to cały powód, dla którego ta flaga w ogóle istnieje
Prawie każda własnoręcznie napisana implementacja LZW psuje to w tym samym miejscu. Najpierw piszesz dekoder, bo to on jest ci potrzebny do otwierania plików. Działa. Potem piszesz enkoder, odzwierciedlasz logikę dekodera linia po linii, bo LZW jest symetryczne, odpalasz test round-trip i przechodzi. Wysyłasz. Pół roku później klient otwiera twoje wyjście w przeglądarce, która nie jest twoja, i od jakiegoś miejsca w środku strumienia jest to śmieć. Lustro było bugiem: dwie połówki LZW nie są symetryczne, a udawanie, że są, produkuje strumienie czytelne tylko dla twojego własnego kodu
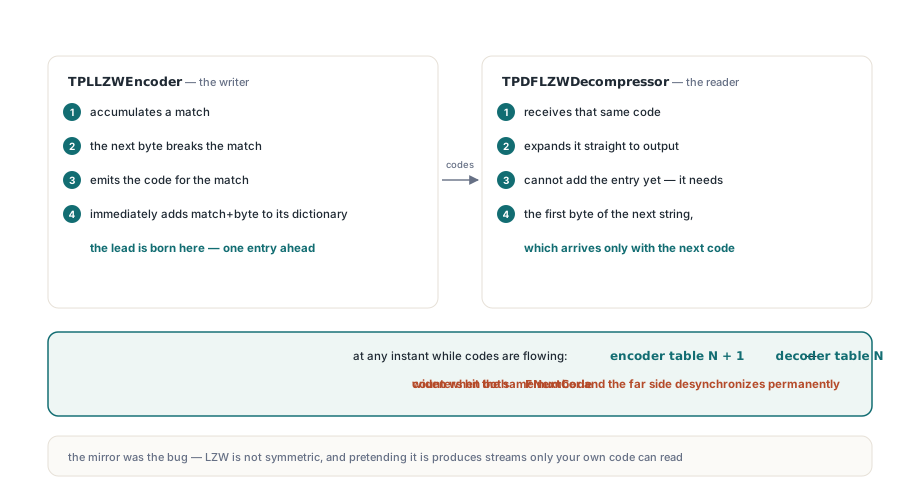
Dlaczego enkoder potrzebuje innego progu niż dekoder?
Bo enkoder poznaje każdy wpis słownika o jeden krok wcześniej, niż może to zrobić dekoder. To nie jest decyzja projektowa w PDFlibPas; to wynika z tego, jak działa LZW, i każda poprawna implementacja musi to gdzieś skompensować. Przejdź pętlę, a zobaczysz, skąd bierze się wyprzedzenie. Enkoder gromadzi dopasowanie, odkrywa, że następny bajt je przerywa, emituje kod dopasowania i natychmiast dodaje dopasowanie-plus-bajt do swojego słownika. Dekoder odbiera ten sam kod i go rozwija, ale nie może jeszcze dodać odpowiadającego wpisu, bo nowy wpis potrzebuje pierwszego bajtu następnego stringa, który przychodzi dopiero z kolejnym kodem. Tak więc w każdej chwili, gdy płyną kody, tablica enkodera trzyma o jeden wpis więcej niż tablica dekodera. Jeśli obie strony poszerzają kod z 9 do 10 bitów, gdy ich własne FNextCode trafi na tę samą liczbę, poszerzają w odstępie jednego kodu i czytnik bitów po drugiej stronie trwale się rozsynchronizowuje. W TPDFLZWDecompressor.ResetDictionary próg dekodera jest liczony raz i przechowywany w FChangeCode:
// TPDFLZWDecompressor.ResetDictionary: strona dekodera progu
FCodeSize := FInitialCodeSize;                 // 9 dla PDF LZWDecode
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // poszerzaj, gdy FNextCode osiągnie 511
else
  FChangeCode := FBitMask + 1;                 // poszerzaj, gdy FNextCode osiągnie 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
Pętla dekodowania poszerza zaraz po dopięciu wpisu, testując (FNextCode = FChangeCode) and (FCodeSize < 12) oraz przeliczając zarówno FBitMask, jak i FChangeCode dla nowej szerokości. Dziewięć bitów wywala się przy 511 albo 512, dziesięć przy 1023 albo 1024, jedenaście przy 2047 albo 2048, a dwanaście bitów to sufit, przy którym słownik trzeba opróżnić ClearCode zamiast rozrastać. Enkoder nie może użyć żadnej z tych liczb. Jego GrowCodeSize dodaje jedynkę, żeby skompensować wyprzedzenie, więc przy ustawionym EarlyChange poszerza przy 512, podczas gdy dekoder poszerza przy 511:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 przy 9 bitach
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 przy 9 bitach
  // Dekoder dodaje swój ostatni oczekujący wpis, zanim przeczyta EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;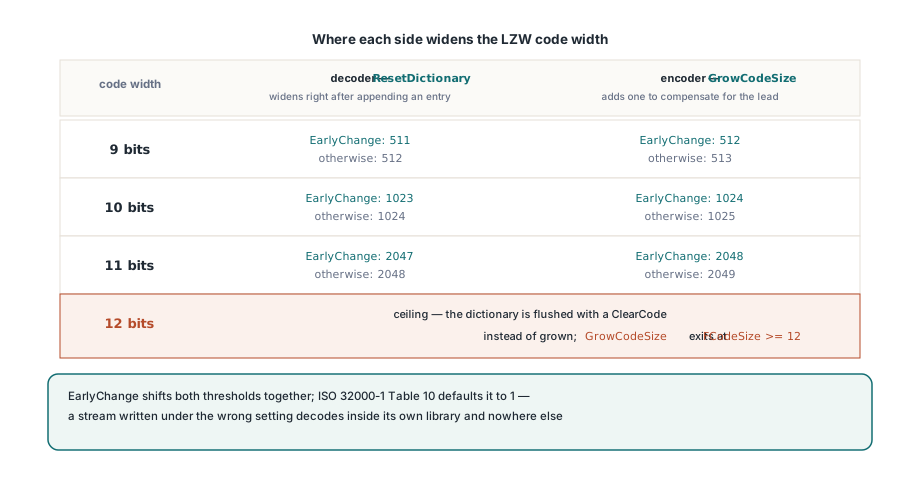
Ostatni kod danych to miejsce, w którym obie strony w końcu się spotykają
Koniec strumienia to jedyne miejsce, w którym enkoder musi przestać prowadzić i myśleć jak dekoder — po to jest parametr FinalDataCode w GrowCodeSize. Wyemituj kod EOI przy złej szerokości, a wszystko przed nim nadal jest w pełni poprawne, więc defekt chowa się za tysiącami poprawnych bajtów. Sekwencja wygląda tak. Enkoder emituje swój ostatni kod danych i, inaczej niż w każdej wcześniejszej iteracji, niczego potem nie dodaje do swojego słownika, bo nie zostało żadnego następnego bajtu, którym mógłby przedłużyć dopasowanie. Dekoder robi odwrotnie: odbiera ten ostatni kod i dopiero teraz może dokończyć wpis, który trzymał od poprzedniego. Na ostatnim kroku dekoder go dogania, wyprzedzenie spada do zera, a szerokość, której użyje do odczytu EOI, jest rozstrzygana przez wpis, którego enkoder nigdy nie zrobił. Dec(ChangeCode) to enkoder udający, przez dokładnie jedno wywołanie, że jest dekoderem:
// TPLLZWEncoder.Compress, ogon strumienia
EmitCode(CurCode);      // ostatni kod danych, przy aktualnej szerokości
GrowCodeSize(True);     // może poszerzyć, używając zdekremetowanego progu
EmitCode(FEOICode);     // EOI przy szerokości, którą dekoder faktycznie odczyta
FlushBits;
FlushOutput;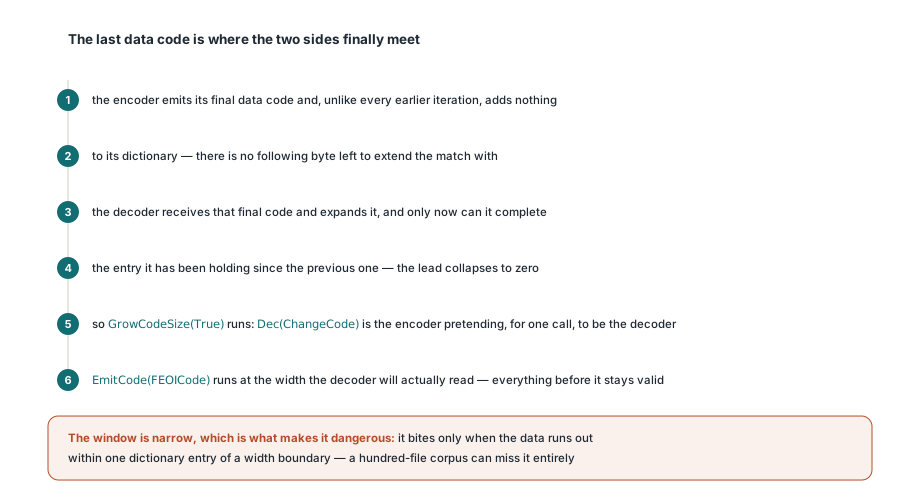
Okno, w którym to ma znaczenie, jest wąskie i właśnie to czyni je groźnym. Gryzie tylko wtedy, gdy dane przypadkiem kończą się w obrębie jednego wpisu słownika od granicy szerokości, więc korpus stu plików testowych może je całkowicie przegapić, podczas gdy jeden plik klienta trafia w nie za każdym razem. Przypadki graniczne w Compress trzeba wymuszać celowo: spreparuj dane wejściowe, których słownik ląduje na 510, 511 i 512 wpisach, a potem odczytaj wyemitowaną szerokość bitów EOI ze strumienia ręcznie, zamiast wnioskować ją z udanego dekodowania
Dlaczego przechodzący test round-trip nadal może ukrywać zepsuty strumień?
Bo dwie implementacje popełniające ten sam błąd zgadzają się ze sobą. Jeśli twój enkoder i twój dekoder oba poszerzają o jeden kod za wcześnie albo oba o jeden kod za późno, zostają w kroku, round trip odtwarza wejście bajt po bajcie, a suite jest zielony, podczas gdy strumień, który wyprodukowałeś, jest nieczytelny dla czegokolwiek innego. To najcenniejsza rzecz do wyniesienia z całego tego ćwiczenia: w LZW samospójność jako dowód jest warta nic. Więc samodzielny round-trip nie może być głównym testem, a PDFlibPas waliduje ścieżkę LZW na trzy inne sposoby. Ręcznie budowane strumienie kodów z oczekiwanym wzorcem bitowym wypisanym ręcznie, tak że asercja dotyczy bajtów, a nie wyniku ich dekodowania. Dwukierunkowa interoperacyjność z niezależnymi implementacjami, gdzie strumienie wyprodukowane przez ten enkoder dekodowane są gdzie indziej, a strumienie wyprodukowane gdzie indziej dekoduje TPDFLZWDecompressor. I dekodowanie różnicowe, czytające te same bajty dwa razy z EarlyChange ustawionym w obie strony, tak że strumień, który dekoduje się czysto przy złym ustawieniu, mówi ci, że granice szerokości nigdy nie zostały przećwiczone:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // celowo zła reguła dla PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A musi zgadzać się ze źródłem; B NIE może. Jeśli B też się zgadza,
// wejście było za krótkie, żeby przekroczyć granicę szerokości kodu.
Zewnętrzne dane wejściowe to to, co faktycznie daje to pokrycie. Aktualny materiał testowy przekracza szerokości 9, 10, 11 i 12 bitów i wymusza 34 resety słownika w jednym strumieniu, co jest jedynym realistycznym sposobem udowodnienia, że ścieżka ClearCode przy suficie 4095 w ogóle działa. Jeśli twoje fixtures nigdy nie przekraczają kilku kilobajtów, żaden z tego kodu nigdy nie został uruchomiony. A gdy poprawka zmienia to, co produkuje twój enkoder, traktuj stare wyjście jako zepsute, a nie jako linię bazową kompatybilności wartą zachowania; strumień mieszający szerokości kodów nieprawidłowo to nie format legacy, to bug, który akurat został zapisany na dysk
PDF mówi 1, TIFF mówi: to zależy
PDFlibPas domyślnie ustawia EarlyChange na True zarówno w TPLLZWEncoder, jak i w TPDFLZWDecompressor, bo Tabela 10 w ISO 32000-1 definiuje EarlyChange jako parametr dekodowania LZWDecode z domyślną wartością 1, co znaczy, że długość kodu zwiększa się o jeden kod wcześniej. To jest określone w sekcji 7.4.4.2 ISO 32000-1 obok parametrów predyktora, a PDF chcący innego zachowania musi powiedzieć /EarlyChange 0 jawnie w swoim słowniku /DecodeParms. TIFF to powód, dla którego flaga jest właściwością, a nie stałą: sekcja 13 TIFF 6.0 opisuje kompresję LZW bez tego samego jednoznacznego stwierdzenia, a enkodery w terenie historycznie się na tym dzieliły, co najpewniej jest powodem, dla którego specyfikacja PDF w ogóle poczuła potrzebę nazwania parametru. W pipeline TIFF-to-PDF ustawienie nie jest więc czymś, co możesz zahardkodować na którymkolwiek końcu. Cokolwiek strona TIFF okazała się potrzebować, musi zostać jawnie przeniesione do PDF-owego /DecodeParms, bo inaczej przekonwertujesz plik, który otwierał się dobrze, na taki, który się nie otwiera. Ta sama ostrożność dotyczy FillOrder, gdzie foTop i foBottom wybierają, z którego końca bajtu czytnik bitów wypełnia, oraz poziomego różnicowania TIFF Predictor 2, które TPDFLZWParms przenosi przez Predictor, Colors, BitsPerComponent i Columns. Nasze notatki o hartowaniu wbudowanego dekodera TIFF dla BigTIFF i układów tiled pokrywają resztę tej ścieżki
Dwie mniejsze pułapki warte wymienienia
Obie łatwo podpiąć źle, gdy masz obiekty enkodera i dekodera otwarte obok siebie i zakładasz, że symetria trzyma się też tutaj:
InitialCodeSizenie znaczy tego samego w obu klasach.TPLLZWEncoder.InitialCodeSizeto szerokość symbolu źródłowego, walidowana od 2 do 8, zInitDictionarywyprowadzającymFClearCodejako1 shl FInitialCodeSizei ustawiającymFCodeSizenaFInitialCodeSize + 1.TPDFLZWDecompressor.InitialCodeSizeto pierwsza szerokość kodu, walidowana od 2 do 9, zResetDictionarywyprowadzającymFClearCodejako1 shl (FCodeSize - 1). Dla zwykłych 8-bitowych danych PDF domyślne wartości to odpowiednio 8 i 9 i nigdy tego nie zauważysz; ustaw oba ręcznie na tę samą liczbę, a zbudowałeś niedopasowaną parę- Dekodowanie niezaufanego LZW to problem bezpieczeństwa pamięci, zanim stanie się problemem poprawności, bo indeksy słownika pochodzą wprost z pliku.
TPDFLZWDecompressorodrzuca każdy kod powyżej 4095 albo równy lub wyższy odFNextCode, odmawia dodawania wpisów poza 4095, sprawdza pozostałe wejście w bitach przed każdymGetNextCodei wystawiaSawExplicitEOI, żeby wywołujący mógł odróżnić poprawnie zakończony strumień od takiego, któremu po prostu skończyły się bajty. Ucięty strumień to nie częściowy sukces. Szerszy przegląd w hartowaniu parsera PDF w Pascalu przed złośliwymi plikami pokrywa klasę defektów, które te strażniki zamykają
Co ci z tego zostaje
LZW wygląda symetrycznie, a nie jest. Słownik enkodera prowadzi o jeden wpis przez cały korpus strumienia, a wyprzedzenie znika na ostatnim kodzie, więc poprawna implementacja niesie dwa progi plus jeden przypadek szczególny, a flaga EarlyChange przesuwa oba progi razem. Spudłuj którykolwiek o jeden kod, a wyprodukujesz wyjście poprawne aż do momentu, w którym nie jest, bez żadnego błędu i wyjątku, tylko gdzieś przeglądarka renderująca szum. Uczciwa granica jest taka, że nic z tego nie da się przetestować od środka: nic w twoim własnym suite nie odróżni poprawnego strumienia od konsekwentnie złego, więc sprawdzenie interoperacyjności to nie opcjonalny dodatkowy przebieg — to jedyny prawdziwy dowód, jaki kiedykolwiek dostaniesz. Obie klasy są w PDF Library for Delphi, która obsługuje też otaczającą strukturę opisaną w naszych notatkach o strumieniach obiektów i strumieniach xref, dla Delphi i C++Builder we wszystkich wersjach kompilatorów wspieranych przez bibliotekę