Uczciwy benchmark load/save dla PDF Library for Delphi mierzy LoadFromFile i SaveToFile przez QueryPerformanceCounter, zachowuje surowe tyknięcia i częstotliwość licznika, puszcza baseline i kandydata w naprzeminych parach A/B, B/A, A/B, odmawia startu, dopóki obciążenie CPU siedzi powyżej 25%, odrzuca każdy wynik, którego rozrzut zakres-do-mediany przekracza 15%, i wyrzuca każdy pomiar, którego zapisany PDF nie przejdzie walidacji strukturalnej, renderującej albo semantycznej. Ta lista brzmi jak biurokracja, dopóki pierwszy raz nie wyparuje obietnica „20% szybciej” przy powtórce. Poniżej jest to, jak dedykowana sonda korpusowa i jej runner porównawczy do tego doszły, łącznie z przebiegiem, w którym maszyna była po prostu zbyt zajęta, by cokolwiek zmierzyć, a harness trafnie to powiedział
Dlaczego benchmark PDF w Delphi raportuje zero sekund?
Benchmark wczytywania PDF raportuje zero sekund, gdy jego zegar tyka grubiej niż operacja, którą mierzy, a GetTickCount64 to dokładnie taki zegar: zwraca milisekundy, ale na Windows posuwa się dopiero, gdy odpali przerwanie timera systemowego, zwykle co 15,6 ms. Port FPC dema benchmarkowania wielkich plików w PDF Library for Delphi go używał, bo TStopwatch nie jest dostępny w tym toolchainie, i zapisywał czas do trzech miejsc po przecinku. Wczytanie małego rysunku CAD albo krótkiego dokumentu z tagami kończy się z zapasem wewnątrz jednego kroku timera, więc demo czasem drukowało 0.000 dla wczytania, które ewidentnie zrobiło robotę
function ElapsedSeconds(StartTick: QWord): Double;
begin
  Result:= (GetTickCount64- StartTick)/ 1000.0;
end;

// wewnątrz pętli operacji
Lib:= TPDFlib.Create;
try
  Lib.OnProgress:= Reporter.Progress;
  Started:= GetTickCount64;
  LoadCode:= Lib.LoadFromFile(InputFile, Password);
  ...
Zero jest gorsze niż niedokładna liczba, bo każdy pomiar, który na nim zbudujesz, dzieli przez nie. Runner porównania parami traktuje każdą gałąź z zerowym minimum jako nierozstrzygniętą z uzasadnieniem „Zero duration prevents a meaningful ratio” — to poprawna odmowa, ale oznacza też, że pomiary dema zostawiały lukę pomiarową dokładnie tam, gdzie żyją krótkie pliki. To samo demo instaluje też callback OnProgress, więc jego czasy obejmują narzut callbacka, którego czysty pomiar load/save nie powinien nieść, a zarchiwizowane liczby z dema nie są wymienne z niczym zmierzonym później
Pomiar LoadFromFile i SaveToFile przez QueryPerformanceCounter
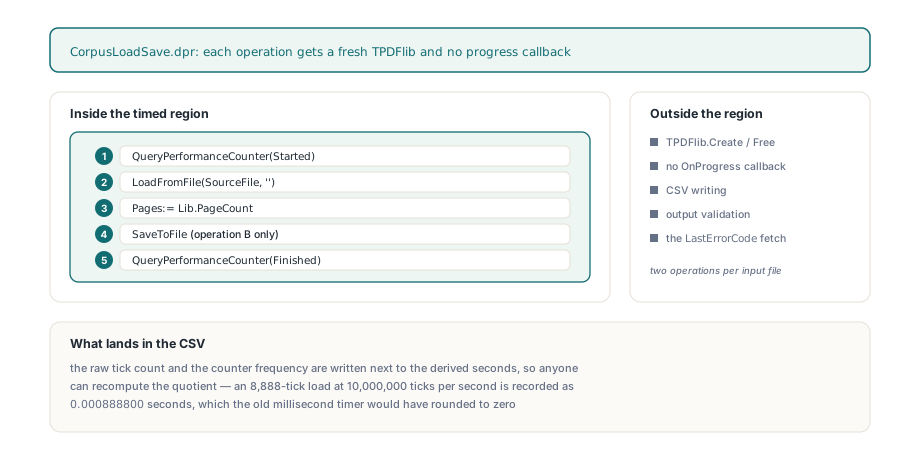
Dedykowana sonda konsolowa, Tests/CorpusLoadSave.dpr, mierzy z QueryPerformanceCounter dwie operacje na plik wejściowy: LoadFromFile plus odczyt PageCount oraz LoadFromFile plus PageCount plus SaveToFile. Każda operacja dostaje świeżą instancję TPDFlib i żaden callback postępu, a konstruktor i destruktor instancji siedzą poza mierzonym regionem, podobnie jak zapis CSV i cała walidacja wyjścia. Licznik jest odczytywany tuż przed wczytaniem i tuż po ostatnim wywołaniu biblioteki, a LastErrorCode pobierany jest dopiero po drugim odczycie
Lib:= TPDFlib.Create;
try
  if not QueryPerformanceCounter(Started) then
    raise Exception.Create('Performance counter unavailable');
  Code:= Lib.LoadFromFile(WideString(SourceFile), '');
  if Code= 1 then
  begin
    Pages:= Lib.PageCount;
    if Save then Code:= Lib.SaveToFile(WideString(SavedFile));
  end;
  if not QueryPerformanceCounter(Finished) then
    raise Exception.Create('Performance counter unavailable');
  ErrorCode:= Lib.LastErrorCode;
finally
  Lib.Free;
end;
Ticks:= Finished- Started;
if Ticks< 0 then
  raise Exception.Create('Performance counter moved backwards');
Sonda zapisuje surową liczbę tyknięć i częstotliwość licznika obok wyliczonych sekund, formatowanych z dziewięcioma miejscami po przecinku i stałym separatorem dziesiętnym ., więc każdy może przeliczyć iloraz z CSV, zamiast mu wierzyć. Na budowie FPC Win64 próbka CAD wczytywała się w 8 888 tyknięciach przy 10 000 000 tyknięć na sekundę, zapisanych jako 0.000888800 sekundy — obserwacja, którą stary timer zaokrągliłby do zera. Sonda celowo nie ucina krótkich wartości, nie podstawia minimalnego czasu ani nie odejmuje szacowanego narzutu timera, i przy nieudanym wywołaniu biblioteki nadal zapisuje oba wiersze z niezerowym kodem wyjścia. Dziewięć cyfr to jednak nie dokładność: większa zapisana precyzja nie mówi nic o powtarzalności, a zaszumione albo zerowe obserwacje i tak trzeba odrzucać dalej
if not QueryPerformanceFrequency(Frequency) or (Frequency<= 0) then
  raise Exception.Create('Performance counter frequency unavailable');
NumberFormat:= TFormatSettings.Create;
NumberFormat.DecimalSeparator:= '.';
...
Rows.Add(CSV(ExtractFileName(SourceFile))+ ','+ CSV(Operation)+ ','+
  FormatFloat('0.000000000', Ticks/ Frequency, NumberFormat)+ ','+
  IntToStr(Code)+ ','+ IntToStr(ErrorCode)+ ','+ IntToStr(Pages)+ ','+
  IntToStr(Ticks)+ ','+ IntToStr(Frequency));
Co czyni porównanie czasów load/save PDF wiarygodnym?
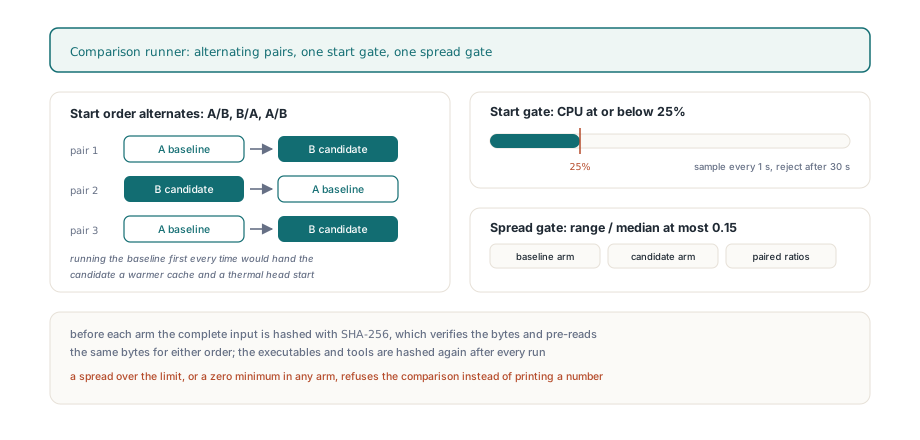
Porównanie czasów między dwiema budowami PDF Library for Delphi jest wiarygodne tylko wtedy, gdy kolejność startu, warunki startu i rozrzut są kontrolowane i rejestrowane, więc runner porównania planuje co najmniej trzy pary w kolejności A/B, B/A, A/B. Zawsze pierwsze puszczenie baseline po cichu podsuwa kandydatowi cieplejszy cache plików i inny stan termiczny; naprzemienna kolejność rozlewa ten bias na obie gałęzie, zamiast dopisywać go jednej. Przed każdą gałęzią runner liczy hash SHA-256 kompletnego pliku wejściowego, co zarazem weryfikuje, że nic się nie zmieniło, i wczytuje z wyprzedzeniem te same bajty dla każdej gałęzi, a po każdym przebiegu liczy hashe ponownie dla obu plików wykonywalnych i narzędzi walidacji, żeby przebudowany binarnik nie przemknął w środku serii
Następnie runner próbkuje obciążenie CPU całej maszyny raz na sekundę i startuje gałąź dopiero, gdy próbka spadnie do 25% lub niżej, czekając najwyżej 30 sekund, zanim zapisze próbę jako odrzuconą. Ta bramka kontroluje warunek startu i nic ponadto: nie izoluje maszyny w trakcie przebiegu, a stan zasilania, throttling termiczny, praca w tle i cache systemu operacyjnego nadal mogą ruszać liczby. Dlatego drugi filtr jest statystyczny w najprostszym sensie. Dla każdej operacji runner liczy zakres przez medianę dla gałęzi baseline, gałęzi kandydata i rozkładu parami branych ilorazów kandydat/baseline, a gdy którakolwiek z tych trzech wartości przekroczy 0.15, wynik dostaje etykietę noisy zamiast trafić do raportu jako finding
Dlaczego kontrola same-binary dowodzi powtarzalności, a nie szybkości?
Kontrola same-binary puszcza identyczne pliki wykonywalne jako baseline i kandydata, więc iloraz bliski 1.0 może jedynie udowodnić, że układ pomiarowy powtarza sam siebie; nigdy nie pokaże, że implementacja zrobiła się szybsza. Pierwsza rygorystyczna kontrola 2026-09-21 użyła sondy FPC Win64 o wysokiej rozdzielczości na przyjętym tagged guide o 70 stronach, a wszystkie sześć startów zostało odrzuconych, bo próbki CPU wahały się od 26.5% do 93.8%. Raport zawierał same porażki i żadnych agregatów, co jest dokładnie takim wynikiem, jakiego chcesz, gdy maszyna jest zajęta. Ponowna próba tego samego dnia z bajt w bajt identycznymi wejściami, tym samym plikiem wykonywalnym sondy i bez zmian progów przyjęła wszystkie sześć startów w ciągu 3 sekund; każdy rozrzut zakres-do-mediany wylądował między 0.019 a 0.054, a mediany ilorazów wyniosły 1.0084 dla LoadFromFile i 0.9872 dla LoadFromFile + SaveToFile
Ta para liczb ustanawia kwalifikowane okno obserwacji i nic ponadto. Gdy dwa pliki wykonywalne się różnią, stabilny przebieg dostaje etykietę porównania opisowego, z jawną adnotacją, że ilorazy są obserwacjami, a nie istotnością statystyczną czy obietnicą przyspieszenia. Dyscyplina jest najważniejsza, gdy walidujesz celowane optymalizacje, jak te opisane w artykule o profilowaniu PDF Library for Delphi i zastępowaniu gorących ścieżek indeksami hash: profiler mówi ci, gdzie ucieka czas, ale dopiero kontrolowany przebieg parami na prawdziwych dokumentach mówi, czy zmiana przeżyła kontakt z całym pipeline'em. Jeszcze jedna granica warta powiedzenia wprost — normal-save obejmuje wczytywanie, a szczytowy working set rejestrowany przez runnera dotyczy całego procesu, więc nic z tego nie jest pamięcią, którą można przypisać samemu zapisowi
Trzy bramki wyjścia i macierz czterech kompilatorów
Żaden pomiar PDF Library for Delphi się nie liczy, dopóki wyprodukowany przez niego plik nie przejdzie trzech niezależnych bramek, bo zapis, który szybko tworzy zepsuty PDF, nie jest szybszym zapisem. Benchmark najpierw sprawdza, że obie operacje zwróciły 1 i zgłosiły przyjętą liczbę stron, a potem waliduje jedyny zapisany PDF w tej kolejności:
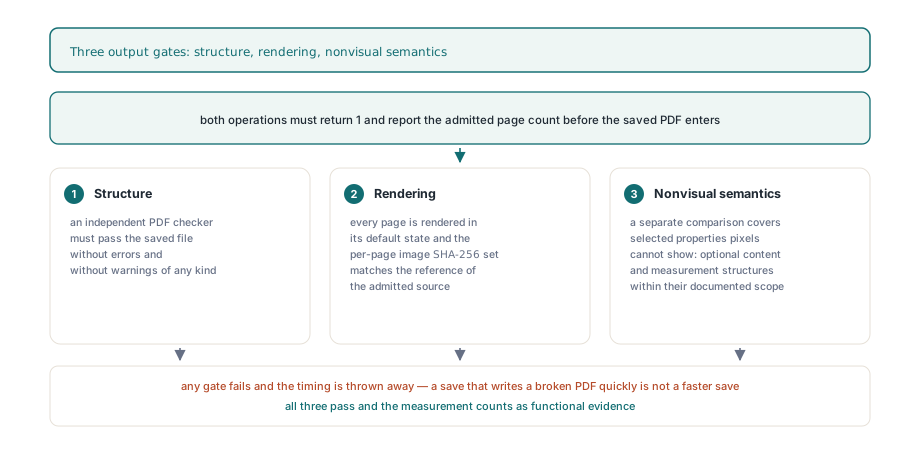
- Struktura: niezależny checker PDF musi przyjąć zapisany plik bez błędów i ostrzeżeń
- Rendering: każda strona jest renderowana w stanie domyślnym, a zbiór SHA-256 obrazów per strona musi dokładnie zgadzać się z referencyjnym renderingiem przyjętego źródła
- Semantyka niewizualna: osobne porównanie semantyczne ze źródłem obejmuje wybrane właściwości, których piksele nie pokażą, w tym struktury optional-content i pomiarowe w ramach ich udokumentowanego zakresu
Z tymi bramkami na miejscu pełna lokalna macierz korpusu puściła sondę na FPC Win32, FPC Win64, Delphi Win32 i Delphi Win64 przez 12 przyjętych PDF-ów o 1 612 stronach źródłowych, dając 48 par próbka/cel i 6 448 zwalidowanych stron wyjściowych bez żadnych wybranych różnic semantycznych. Wszystkie 96 pomiarów operacji zachowało dodatnie surowe wartości licznika spójne z raportowanymi sekundami, a tych wartości celowo nie agreguje się do tabeli szybkości międzykompilatorowej, bo macierz jest dowodem funkcjonalnym, a nie kontrolowanym porównaniem. Ścieżka load/save nie rości też sobie prawa do dekodowania każdego osadzonego obrazu, walidacji podpisów, wykonywania XFA ani certyfikacji PDF/UA; jeśli musisz ocenić przepustowość renderingu, a nie koszt load/save, lepszym punktem wyjścia są ograniczenia współbieżności z artykułu o równoległym renderowaniu stron i bezpieczeństwie wątkowym w PDF Library for Delphi
Praktyczny wniosek jest krótki: trzymaj surowe liczniki, naprzemiennie ustalaj kolejność, bramkuj start, odrzucaj zaszumione rozrzuty i nigdy nie mierz wyjścia, którego nie zwalidowałeś. Te reguły pozwalają PDF Library for Delphi mówić „brak mierzalnej zmiany” z tą samą pewnością, co „szybciej”, a to samo źródło sondy kompiluje się bez zmian na Delphi i FPC dla Win32 i Win64. Bibliotekę, jej API load/save i obsługiwane kompilatory możesz przejrzeć na stronie produktu PDF Library for Delphi