Importer adnotacji FDF potrafi zwrócić liczbę wpisów, które sparsował, nie dodając żadnego do dokumentu: każdy wpis liczony, każdy wyrzucony. TPDFlib.ImportAnnotationsFromFDFString w losLab PDF Library czyta klucze w dowolnej kolejności, parsuje /Rect poprawnie i niezależnie od locale i zwraca liczbę faktycznie dodanych adnotacji, a pasujący eksporter zapisuje prawdziwy /Rect adnotacji, więc eksport, import i drugi eksport dają bajt w bajt identyczne FDF. Reszta tej notatki wyjaśnia, jak jeden zły offset startowy produkuje wzorcową cichą awarię, które trzy pułapki kryją się za nim i jak sprawdzić import samodzielnie, zamiast ufać wartości zwracanej
Scenariusz jest zwyczajny. Recenzent komentuje umowę, komentarze podróżują jako plik FDF (Acrobat nazywa to Export Comments), a twoja usługa w Delphi scala je z czystą kopią wołaniem importu FDF. Wywołanie zwraca 7, log mówi „zaimportowano 7 komentarzy”, job świeci na zielono, a wyjściowy PDF nie ma komentarzy wcale. Nic nie rzuciło wyjątku, nic nie ostrzegło, a liczba wyglądała wiarygodnie, bo była prawdziwym licznikiem wpisów w pliku. To najgorszy kształt, jaki może przyjąć błąd: funkcja, której jedynym sygnałem sukcesu jest licznik liczony niezależnie od pracy, o którą rzekomo raportuje
Dlaczego import FDF może raportować sukces, a nic nie dodawać?
Bo czytnik nazw może zacząć w złym miejscu, a licznik może mieszkać poza kodem, który wykonuje robotę. Wyszukiwarka klucza zwracająca pozycję natychmiast za /Subtype ląduje na białym znaku przed wartością. ReadName, który zaczyna na tej spacji i zatrzymuje się na pierwszym białym znaku, kończy, zanim cokolwiek przeczyta, więc każdy subtyp wraca pusty. Helper taki jak AddAnnotationToPage, który odmawia budowy adnotacji bez subtypu, podejmuje w izolacji poprawny defensywny wybór, ale jeśli jest procedurą bez wartości zwracanej, a Inc(Result) wołającego siedzi na zewnątrz, dwa strażniki razem zamieniają „nic nie działało” w „wszystko działało”. Poprawny czytnik nazw pomija białe znaki, wymaga wiodącego / obiektu nazwy PDF i zatrzymuje się na dowolnym delimiterze, łącznie z [, ( i ), więc /Subtype/Text i /Subtype /Text dają oba Text; tak czyta nazwy losLab PDF Library
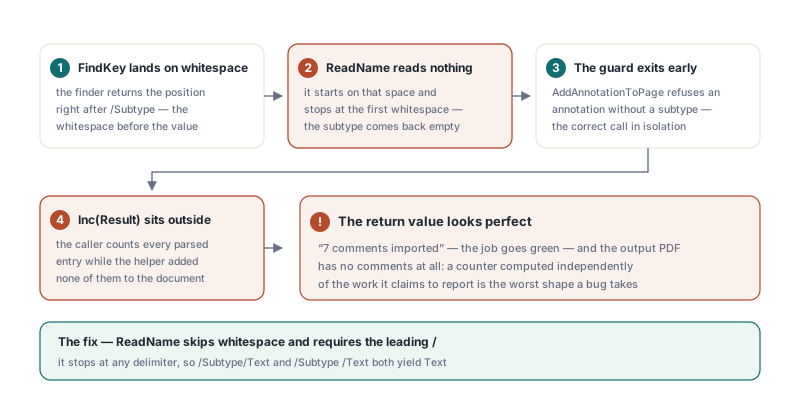
Wartość zwracana zasługuje na uwagę także poza tym. Importer inkrementujący dla każdego dobrze uformowanego słownika w tablicy /Annots wciąż zgłasza za dużo, gdy wpis ma 0-bazowy /Page poza zakresem albo brakujący /Subtype — oba przypadki są pomijane. W losLab PDF Library ImportAnnotationsFromFDFString i ImportAnnotationsFromFDF zwracają liczbę faktycznie dodanych adnotacji, jak import XFDF: helper FDF AddAnnotationToPage zwraca Boolean, a licznik rusza tylko przy sukcesie. Pomiar dokumentu pozostaje mocniejszym sprawdzeniem, bo działa niezależnie od tego, który kod wyprodukował liczbę, więc szkic poniżej porównuje AnnotationCount na każdej stronie przed importem i po nim
function TotalAnnotations(Lib: TPDFlib): Integer;
var
  Page, Saved: Integer;
begin
  Result := 0;
  Saved := Lib.SelectedPage;
  for Page := 1 to Lib.PageCount do
    if Lib.SelectPage(Page) = 1 then
      Inc(Result, Lib.AnnotationCount);   // na każdej wybranej stronie, widżety wliczone
  Lib.SelectPage(Saved);
end;

var
  Lib: TPDFlib;
  Before, Reported, Added: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contract.pdf', '');
    Before := TotalAnnotations(Lib);
    Reported := Lib.ImportAnnotationsFromFDF('review-comments.fdf');
    Added := TotalAnnotations(Lib) - Before;
    if Added <> Reported then   // równe, gdy każdy wpis trafił na stronę
      Writeln(Format('Importer reported %d, %d landed on a page', [Reported, Added]));
    Lib.SaveToFile('contract-reviewed.pdf');
  finally
    Lib.Free;
  end;
end;
Trzy kolejne pułapki za pierwszą
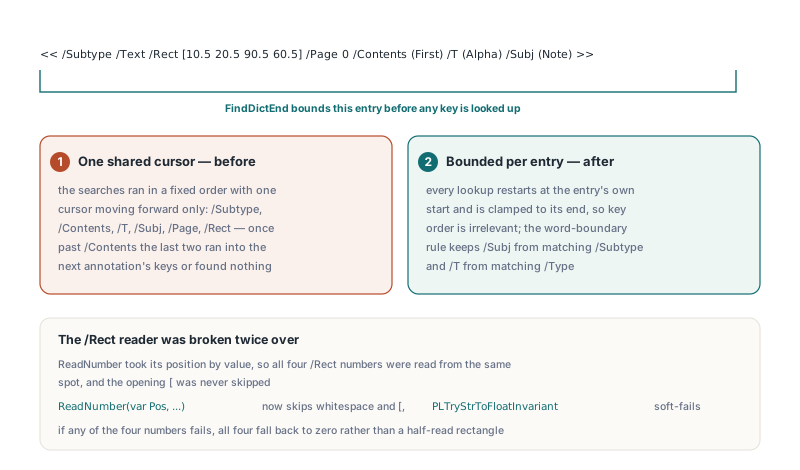
Sama naprawa subtypu obnażyłaby trzy dalsze pułapki tego samego rodzaju parsera, każdy niewidoczny dopóki żadna adnotacja nie dotrze na stronę. Po pierwsze, ReadNumber, który bierze pozycję jako parametr wartości, czyta to samo miejsce cztery razy, gdy jest wołany dla czterech liczb /Rect po kolei, a jeśli nie pomija otwierającego [, w praktyce nie czyta niczego wcale. Po drugie, FindKey, który dzieli jeden przesuwający się naprzód kursor między wszystkie wyszukiwania, zależy od kolejności kluczy. Eksporter może zapisywać /Subtype, /Rect, /Page, /Contents, /T, /Subj, podczas gdy importer szuka w kolejności /Subtype, /Contents, /T, /Subj, /Page, /Rect; gdy kursor minie /Contents, szukanie /Page i /Rect biegnie za koniec bieżącego wpisu i albo nie znajdzie nic, albo złapie klucze następnej adnotacji, więc importer nie potrafi przeczytać nawet wyjścia własnego eksportera. Po trzecie, liczby parsowane przez procedurę stosującą systemowy separator dziesiętny, jak PLStrToFloat, łamią się na maszynach z locale przecinkowym. ISO 32000-1 §12.7.7 definiuje FDF jako składnię obiektów PDF, a klucze słowników w PDF są nieuporządkowane (§7.3.7), więc każdy parser FDF zakładający kolejność kluczy jest zły z konstrukcji, jakiekolwiek narzędzie wyprodukowało plik
losLab PDF Library najpierw wyznacza granice każdego wpisu. FindDictEnd idzie od otwierającego << do pasującego >>, śledząc zagnieżdżone słowniki i pomijając ciała łańcuchów literalnych z ich ucieczkami po ukośniku, więc >> wewnątrz komentarza takiego jak (see section >> 4) nie skończy wpisu za wcześnie. Każde wyszukiwanie klucza startuje potem na własnym początku wpisu i jest ograniczone jego końcem, co czyni kolejność kluczy bez znaczenia i nie pozwala jednej adnotacji pożyczyć /Page drugiej. Dopasowanie klucza akceptuje też delimiter bezpośrednio po nazwie, bo /Contents(Hi) jest równie poprawne jak /Contents (Hi), a reguła granicy słowa pilnuje, by /Subj nie złapało początku /Subtype, a /T — /Type. ReadNumber bierze teraz pozycję jako parametr var, pomija białe znaki i [ i parsuje przez PLTryStrToFloatInvariant, który miękko zawodzi na zdeformowanym tokenie, zamiast rzucać wyjątek. Gdy któraś z czterech liczb prostokąta zawiedzie, wszystkie cztery wracają do zera, zamiast produkować półprzeczytany prostokąt
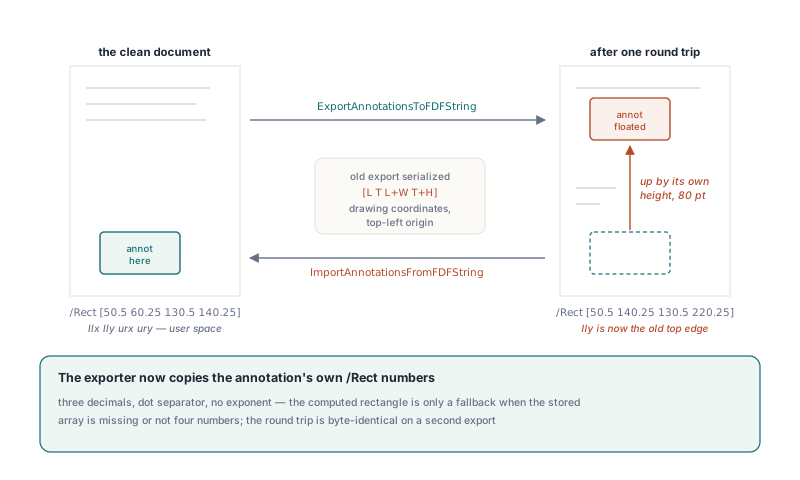
Dlaczego pełne cykle FDF mogą przesunąć każdą adnotację o jej własną wysokość?
Bo łatwo zapisać prostokąt w złym modelu współrzędnych. /Rect adnotacji to [llx lly urx ury] w domyślnej przestrzeni użytkownika (ISO 32000-1 §12.5.2, prostokąty zdefiniowane w §7.9.5), a FDF wozi tę samą tablicę. GetAnnotRectEx raportuje jednak Left, Top, Width i Height w rysunkowych współrzędnych biblioteki, tej przestrzeni, którą steruje SetOrigin. Eksporter serializujący je jako [L T L+W T+H] podaje importerowi cztery wartości, które, wpisane z powrotem dosłownie jako prostokąt PDF, lądują górną krawędzią tam, gdzie należy się lewy dolny róg, więc każdy pełny cykl przesuwa adnotację w górę o jej własną wysokość. Eksporter losLab PDF Library kopiuje własne liczby /Rect adnotacji — trzy miejsca dziesiętne, separator kropka, bez wykładnika — i schodzi do prostokąta policzonego tylko wtedy, gdy zapisana tablica nie istnieje albo nie ma czterech liczb
Test regresji, który warto skopiować, asertuje na dokumencie i na drugim eksporcie, a nie na wartości zwróconej przez importera. Zauważ oczekiwaną liczbę 2: AddNoteAnnotation tworzy adnotację Text plus jej Popup, i obie podróżują. Test puszcza też eksport i import przy separatorze dziesiętnym przecinek — i tu mieszka druga połowa tej historii
var
  Source, Target: TPDFlib;
  FDF: AnsiString;
  OldSep: Char;
begin
  Source := TPDFlib.Create;
  Target := TPDFlib.Create;
  try
    Source.NewPages(1);                     // teraz dwie strony
    Source.SelectPage(2);
    Source.AddNoteAnnotation(50.5, 60.25, 0, 80, 80, 120, 60,
      'Reviewer', 'Check this', 0.25, 0.5, 0.75, 0);
    Target.NewPages(1);

    OldSep := FormatSettings.DecimalSeparator;
    FormatSettings.DecimalSeparator := ',';   // symulacja niemieckiego albo francuskiego pulpitu
    try
      FDF := Source.ExportAnnotationsToFDFString;   // nadal pisze /Rect [50.5 ...
      Target.ImportAnnotationsFromFDFString(FDF);
    finally
      FormatSettings.DecimalSeparator := OldSep;
    end;

    Target.SelectPage(2);
    Assert(Target.AnnotationCount = 2);           // notatka i jej popup
    Assert(Target.GetAnnotType(1) = 'Text');
    Assert(Target.ExportAnnotationsToFDFString = Source.ExportAnnotationsToFDFString);
  finally
    Target.Free;
    Source.Free;
  end;
end;
Ścieżka FDF jest zbudowana wokół słownika rdzeniowego adnotacji. Importer przebudowuje każdy wpis z /Type, /Subtype, /Rect, /Contents, /T i /Subj, a eksporter zostawia adnotacje Widget metodom danych formularza, gdzie pola formularza mają swoje miejsce. Zanim zaufasz FDF dla koloru, flag, stylu obramowania, łączy popup albo strumieni wyglądu, sprawdź szerszą mapę, które dane podróżują którą metodą, w przeglądzie wymiany danych formularzy FDF, XFDF i XFA, a jeśli musisz obejrzeć, co faktycznie dotarło, czytniki per indeks, takie jak GetAnnotType, GetAnnotTitle i GetAnnotContentsEx, są omówione w artykule o introspekcji konspektów, adnotacji i akcji
Jak czytać pliki FDF i XFDF z przecinkiem dziesiętnym?
Dla FDF odpowiedź jest jednoznaczna: przecinek nie jest delimiterem w składni PDF, więc token liczbowy zawierający dokładnie jeden przecinek i żadnej kropki może być tylko dziesiętnym zapisanym na maszynie z locale przecinkowym. Takie pliki istnieją, na przykład /Rect [10,500 20,250 40,750 60,125] od eksportera formatującego liczby systemowym locale, a ReadNumber zamienia ten pojedynczy przecinek na kropkę przed parsowaniem. Token z dwoma przecinkami albo z przecinkiem i kropką jest odrzucany, a nie zgadywany. Czytnik nie konsumuje też notacji wykładniczej, co zgadza się z ISO 32000-1 §7.3.3: liczby PDF nigdy jej nie używają
XFDF jest trudniejszy, bo w atrybutach XML przecinek jest separatorem. Standardowy XFDF (ISO 19444-1) pisze rect="50.5,80.25,70.75,100.125" i dashes="4,2", podczas gdy zapisujący zależny od locale na systemie z locale przecinkowym produkuje rect="50,500 80,250 70,750 100,125" i opacity="0,600". losLab PDF Library czyta i zapisuje liczby XFDF niezmiennie w obu kierunkach, a starszy kształt rozpoznaje XFDFNormalizeLegacyDecimals tylko wtedy, gdy atrybut dzieli się białymi znakami na dokładnie oczekiwaną liczbę tokenów (cztery dla rect, jeden dla opacity i width) i każdy token ma postać cyfra-przecinek-cyfra. Standardowy rect nigdy nie pasuje: to albo jeden token z trzema przecinkami, albo tokeny kończące się przecinkiem. dashes zostawiono z premedytacją w spokoju, bo 4,2 może być dwiema długościami kresek albo starszym 4.2 i żadna reguła tego nie odróżni
const
  // Klucze poza kolejnością eksportera plus dziesiętne z przecinkiem z eksportu w locale przecinkowym
  LegacyFDF: AnsiString = '%FDF-1.2'#10'1 0 obj'#10'<< /FDF << /Annots ['#10 +
    '<< /Rect [10,500 20,250 40,750 60,125] /Page 0 /Contents (First) ' +
    '/Subtype /Text /T (Alpha) /Type /Annot >>'#10 +
    '] >> >>'#10'endobj'#10'trailer'#10'<< /Root 1 0 R >>'#10'%%EOF'#10;
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;               // świeży dokument ma jedną stronę
  try
    Lib.ImportAnnotationsFromFDFString(LegacyFDF);
    Assert(Lib.AnnotationCount = 1);
    Assert(Lib.GetAnnotTitle(1) = 'Alpha');
    // Reeksport jako XFDF z kropkowymi dziesiętnymi: rect="10.500 20.250 40.750 60.125"
    Writeln(Lib.ExportAnnotationsToXFDFString);
  finally
    Lib.Free;
  end;
end;
Co test importu adnotacji powinien naprawdę asertować?
Przydatny test importu asertuje stan dokumentu docelowego, nigdy tylko to, co importer mówi o sobie samym; w cichym zerze wartość zwracana jest tą jedyną liczbą, która zostaje nietknięta. Trzy asercje łapią każdą pułapkę opisaną tutaj: liczbę adnotacji na oczekiwanej stronie, jedno pole przeczytane z powrotem przez GetAnnotType albo GetAnnotContentsEx i drugi eksport porównany bajt w bajt z pierwszym. Ta sama dyscyplina dotyczy każdego API, które hurtowo przepisuje strukturę dokumentu, łącznie z konsolidacją pól opisaną w artykule o scalaniu duplikatów pól formularza: sprawdzaj powstałe drzewo, nie zwróconą sumę. Metody adnotacji FDF i XFDF, z wariantami plikowymi i łańcuchowymi, są częścią losLab PDF Library for Delphi and C++Builder