Weź plik, którego słownik informacji mówi /Title (Annual Maintenance Report), podczas gdy jego pakiet XMP nie ma dc:title w ogóle. Przeglądarki pokazują tytuł bez skargi, a jednak walidator PDF/A odrzuca plik, bo dwie kopie metadanych się nie zgadzają. Drugi plik wygląda równie zdrowo, ale nie ma wpisu pdfaid:part w swoim XMP, i walidator odpowiada dziesiątkami błędów: sądzi plik jako zwykły PDF i raportuje każdą regułę rozczonej części jako niespełnioną, wszystko z jednej brakującej linii
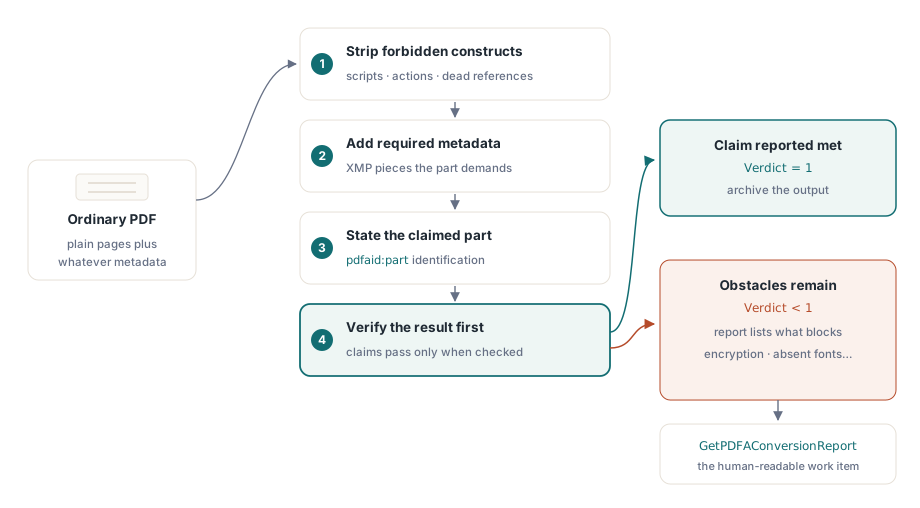
Te dwa problemy potrzebują bardzo różnych ilości roboty. Uzgodnienie metadanych to wąska poprawka, którą możesz puścić na każdym pliku. Zamiana dowolnego PDF w archiwalny znaczy obcięcie tego, czego zabrania część docelowa, dodanie tego, czego wymaga, zadeklarowanie roszczenia, a potem walidację bajtów, które faktycznie wyszły. Konwersję zbudowaliśmy wokół tego ostatniego kroku celowo. ConvertToPDFA, które płynie z edycją Enterprise (TPDFlibEnterprise) razem z GetPDFAConversionReport, zapisuje skonwertowany dokument do pamięci, puszcza sprawdzenie PDF/A na tych bajtach i zwraca 1 tylko, gdy to sprawdzenie przechodzi
Dlaczego poprawnie wyglądający PDF nie przechodzi sprawdzenia PDF/A?
Obie porażki pochodzą z reguł metadanych. PDF zapisuje tytuł, autora, producenta i daty w słowniku informacji o dokumencie, a PDF/A wymaga też tych samych faktów w pakiecie metadanych XMP; ISO 19005-1 §6.7.3 każe tym dwóm być równoważnymi, a PDF/A-2 i PDF/A-3 trzymają regułę. Wśród plików zawodzących na tej regule zwykły wzorzec to producent, który wypełnił słownik informacji i nigdy nie napisał połowy XMP, więc walidator znajduje tytuł w jednym miejscu i nic w drugim
Brakująca identyfikacja jest cichsza. Wpisy pdfaid:part i pdfaid:conformance to to, co znaczy plik jako PDF/A, a plik może być doskonale poprawny bez nich. Przypadek, który widzimy najczęściej, to aplikacja podająca własny pakiet XMP, zastępujący ten wygenerowany przez pisarza PDF; własny pakiet niesie pola aplikacji i żadnych wpisów pdfaid, więc lista błędów wskazuje daleko od prawdziwej przyczyny
RepairDocumentMetadata obsługuje oba przypadki i zwraca liczbę wpisów, które zmienił. Jest dostępny w każdej edycji, jak SetPDFAMode i SanitizeDocument. Naprawa przechodzi Title, Author, Subject, Keywords, Creator, Producer, CreationDate i ModDate. Gdy tylko XMP niesie wartość, słownik informacji jest z niego wypełniany, więc nic już zapisanego nie zostaje wyrzucone. Gdy oba niosą wartości i się różnią, słownik informacji wygrywa. Podjęliśmy tę decyzję, bo słownik informacji to połowa, którą producenci ustawiają najczęściej, co czyni ją bardziej prawdopodobnym zapisem intencji autora
Jeśli twoje XMP jest kopią rozstrzygającą (powiedzmy, że było pielęgnowane w systemie zarządzania dokumentami), wepchnij wartości, których chcesz, do słownika informacji przez SetInformation i dopiero potem puść naprawę. Zrobienie tego na odwrót nadpisze twój pielęgnowany tytuł XMP tym, cokolwiek napisał pierwotny producent
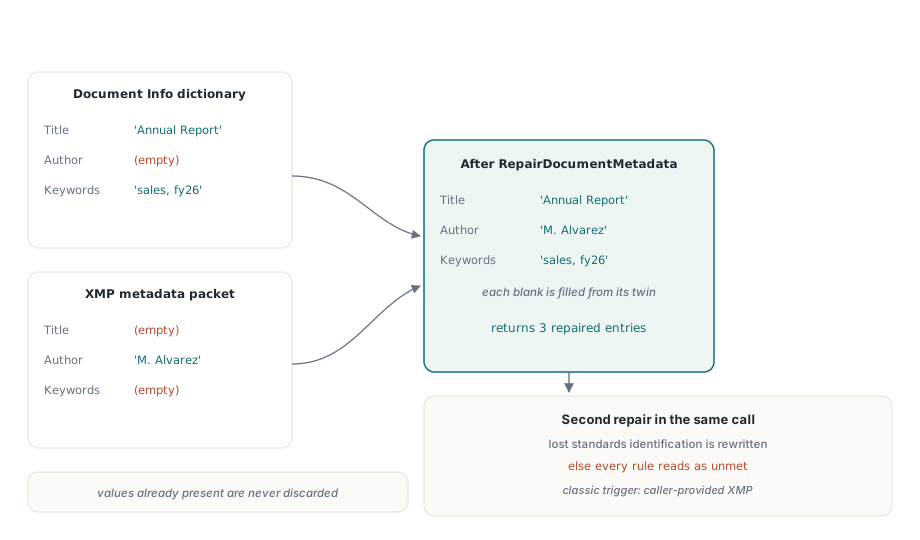
Naprawa identyfikacji potrzebuje od ciebie jednej rzeczy: dokument musi wiedzieć, na jaką część celuje. Świeżo wczytany plik nie ma ustawionego trybu PDF/A, więc wołaj SetPDFAMode przed naprawą. Z trybem na miejscu RepairDocumentMetadata zapisuje pasujące wpisy pdfaid, dodaje pdfaid:rev z rokiem 2020 dla trybów części 4 i ustawia dc:format na application/pdf, co walidatory też sprawdzają
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // Pielęgnowany tytuł idzie do słownika informacji najpierw,
    // bo ta kopia wygrywa, gdy obie połowy się różnią
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b, patrz tabela niżej
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
Wybór części docelowej i jej numeru trybu
Wybierz część z tego, co dokument ma nieść, i dopiero potem odszukaj numer. SetPDFAMode i ConvertToPDFA dzielą jeden schemat numeracji, i nie biegnie on w kolejności, którą sugerują nazwy części
| Tryb | Część i poziom | Uwagi |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4, otagowany |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7, otagowany |
| 5, 6, 7 | PDF/A-3b, 3a, 3u | Osadzone pliki dowolnego typu dozwolone |
| 8 | PDF/A-2u | PDF 1.7, wymagany tekst Unicode |
| 9, 10, 11 | PDF/A-4, 4e, 4f | PDF 2.0; 4e dodaje 3D i rich media, 4f pozwala na osadzone pliki |
Tryb 3 to PDF/A-2b, a tryb 4 to PDF/A-2a. Ta inwersja łapie ludzi, którzy liczą od 1a w górę i zakładają, że poziom a zawsze prowadzi. PDF/A-2u wypada na 8, po trybach części 3
Wybór z realnymi konsekwencjami dotyczy załączników. Części 1 i 2 zabraniają osadzonych plików, więc ConvertToPDFA usuwa je dla trybów 1 do 4 i trybu 8. Skonwertuj fakturę Factur-X albo ZUGFeRD do trybu 3, a ustrukturyzowana faktura XML znika z wyjścia, razem z powodem istnienia pliku. Dla wszystkiego, co niesie załącznik, celuj w tryb 5 (PDF/A-3b), który jest też częścią, na której te formaty faktur są zdefiniowane, albo tryb 11, jeśli potrzebujesz PDF 2.0. Każdy załącznik w pliku części 3 albo części 4 musi podać, jak się odnosi do dokumentu, przez /AFRelationship, i PDF Library for Delphi zapisuje ten wpis dla każdego osadzonego pliku, który zapisuje w tych trybach
Część 4 identyfikuje się inaczej. Nie ma litery zgodności dla czystego PDF/A-4, używa E albo F dla dwóch rozszerzeń i wymaga pdfaid:rev z rokiem publikacji swojej części. ConvertToPDFA podnosi plik do PDF 2.0 dla trybów 9 do 11, bo ISO 19005-4 §6.1.2 buduje część na PDF 2.0, a sprawdzenie sądzi takie pliki względem PDF 2.0 zamiast 1.7
Co ConvertToPDFA zmienia w pliku
ConvertToPDFA wykonuje stałą sekwencję napraw, odnotowuje każdą w tekstowym raporcie, zapisuje wynik do pamięci i waliduje te bajty. Niezaliczone sprawdzenie zwraca 0, i tryb poza 1 do 11 też, który wraca, zanim jakikolwiek raport zostanie napisany. Sekwencja jest warta znajomości, bo każdy krok to coś, co wyjście straci albo zyska:
- Zaszyfrowany dokument o nieznanym haśle zatrzymuje konwersję od razu linią
blocked:; niczego w środku nie da się odczytać, nic dopiero naprawić - JavaScript na poziomie dokumentu i akcja otwarcia, która go uruchamia, są usuwane, razem z każdym wpisem additional-actions i typami akcji, których żadna część nie pozwala, wśród nich Launch, Sound, Movie, ResetForm, ImportData, Hide, SetOCGState, Rendition i Trans. Łącza GoTo i URI zostają, więc nawigacja dalej działa
- Osadzone pliki są usuwane dla części, które ich zabraniają, jak opisano wyżej
- Adnotacje ukryte albo ustawione na nigdy-nie-wyświetlaj są usuwane. PDF/A wymaga, by adnotacje były widoczne i drukowalne, a ujawnienie ich zmieniłoby wygląd strony, więc wybraliśmy usunięcie
- Wyglądy pól formularza są odtwarzane, zanim flaga
/NeedAppearanceszostanie wyczyszczona, więc wypełnione wartości pozostają widoczne - Czcionki używane, a nieosadzone, są osadzane z czcionek zainstalowanych na maszynie
- Obiekty, do których nic już się nie odnosi, są zrzucane, i intencja wyjścia sRGB jest dodawana, jeśli plik jej nie ma
- Na koniec część i poziom są deklarowane w XMP, a bajty są sprawdzane
Na serwerze krok czcionek jest tym, który najprawdopodobniej zatnie konwersję. Dokument używający czcionki, która nigdzie nie istnieje na hoście konwersji, nie da się naprawić od środka pliku, i raport to powie. Zainstaluj czcionki, których twoje dokumenty faktycznie używają, na maszynie konwersji; przewodnik po osadzaniu brakujących czcionek w istniejącym PDF pokrywa ten krok osobno
Jak zadanie wsadowe powinno obchodzić się z konwersją, która zawodzi?
Traktuj wartość zwracaną jako bramkę, a raport jako zlecenie robocze. Archiwizuj pliki zwracające 1, a resztę kieruj do człowieka z raportem przyczepionym. Nie zapisuj wyjścia nieudanej konwersji do archiwum tylko dlatego, że wygląda czyściej niż wejście. Ten plik niesie teraz roszczenie PDF/A, którego sprawdzenie odmówiło potwierdzić, i to jest dokładnie sytuacja, której istnienie kroku weryfikacji ma zapobiec
Raport z GetPDFAConversionReport to jedna linia na akcję, każda zaczynająca się od czasownika: removed:, regenerated:, repaired:, embedded:, added:, stated:, plus blocked:, jeśli coś zatrzymało przebieg, i zamykająca linia result:. Sprawdzenie za werdyktem staje na pierwszej porażce, więc gdy plik zawodzi, konwersja puszcza sprawdzenie jeszcze raz w całości, a raport pokazuje każdy problem naraz. Kierowanie na prefiksach zajmuje kilka linii
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b, zachowuje załączniki
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // Zostaw oryginał nietkniętym; tylko raport podróżuje z nim
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;
Linia blocked: zwykle znaczy, że poprawka leży poza PDF: hasło, inny plik źródłowy albo ponowny przebieg tego, co wytworzyło dokument. Zwykłe problemy walidacyjne po pełnej konwersji częściej są treścią niosącą znaczenie, której nie da się po prostu usunąć, i to są przypadki, gdzie człowiek musi zdecydować
Odczytywanie znacznika PDF/A, jaki plik już niesie
Przed konwersją sprawdź, co dokument już o sobie rości. Pliki przychodzące ze skanerów, pakietów biurowych i innych narzędzi PDF często niosą znacznik PDF/A już, i przekonwertowanie poprawnego pliku PDF/A-3 na część 2 kosztowałoby go załączniki na darmo
Pułapka jest taka, że XMP pozwala zapisać tę samą właściwość na dwa sposoby. Niektórzy producenci zapisują część jako element potomny, <pdfaid:part>2</pdfaid:part>; inni zapisują ją jako atrybut na rdf:Description, pdfaid:part="2". Oba to zwykły, poprawny XMP. Detektor szukający tylko jednej formy rozstrzyga, że pliki od drugiej rodziny producentów nie niosą znacznika, a sprawdzacz zbudowany tak kończy z sądzeniem poprawnego pliku PDF/A-2 względem części 1 i raportowaniem go jako nieoznaczonego i zbyt wysokiej wersji PDF, dokładnej odwrotności prawdy. Walidator w PDF Library for Delphi czyta obie formy. Jeśli węszysz znacznik sam, rób to samo:
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // forma elementu
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // forma atrybutu, podwójne cudzysłowy
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // forma atrybutu, pojedyncze cudzysłowy
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
Pusty wynik znaczy brak znacznika w obu formach. Cyfra mówi ci, którą część miał na myśli producent, i ta liczba jest tą do porównania z twoim celem, zanim zdecydujesz, czy konwertować w ogóle
Sanityzacja skryptów, zanim plik trafi do archiwum
Konwersja archiwalna i sanityzacja bezpieczeństwa zwykle biegną razem, bo treść, którą polityka bezpieczeństwa chce usunięta, mocno pokrywa się z tą, której PDF/A zabrania. SanitizeDocument biera bitmaskę flag SANITIZE_* i zwraca, ile usunięć zastosowała. ConvertToPDFA samo woła ją z SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION jako swoim pierwszym krokiem
Jeden szczegół ma znaczenie dla walidatorów. Skrypty poziomu dokumentu mieszkają w drzewie nazw /JavaScript pod słownikiem /Names katalogu, i gdy ostatni skrypt zostaje usunięty, teraz już puste drzewo jest usuwane z nim. Puste drzewo nadal ogłasza, że dokument ma skrypty, a niektóre sprawdzacze reagują na sam klucz bez liczenia, co pod nim siedzi
Cokolwiek dokonało sanityzacji, zweryfikuj zapisany plik świeżym wczytaniem zamiast ufać stanowi w pamięci. Ponowne otwarcie jest tanie:
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;
W sprawie sąsiednich kroków potoku archiwalnego zobacz przewodniki po preflighcie PDF/A i PDF/UA, prawdziwym zaczernieniu i usuwaniu treści oraz schematach rozszerzeń XMP PDF/A-3 dla Factur-X, który podejmuje stronę metadanych, gdy archiwizowany dokument niesie także ustrukturyzowane dane faktury
Cała konwersja, naprawa metadanych i walidacja pokazane tu biegą wewnątrz twojego własnego procesu Delphi, C++Buildera albo Lazarusa, bez zewnętrznego konwertera albo walidatora z linii poleceń w łańcuchu. Strona produktu PDF Library for Delphi wylicza części PDF/A, edycje i platformy docelowe