Zakoduj OID 2.999.3 tak, jak często robi to pośpieszny helper DER — z dwoma pierwszymi łukami spakowanymi w jeden bajt — a dekoder odda ci 1.15.3. Dwa inne błędy w czytaniu CMS zachowują się tak samo: licznik certyfikatów połykający bajty sąsiada i podpisujący dopasowany na numerze seryjnym odczytanym ze złego pola. W PDF Library for Delphi (PDFlibPas) czytnik podpisów przechodzi CMS w /Contents jako czysty DER, ogranicza każdy zagnieżdżony odczyt elementem rodzica, ucina padding na długości deklarowanej przez CMS i koduje w base-128 scalony pierwszy łuk OID
Sporo kodu potrzebuje strony odczytu podpisu. Walidacja długoterminowa musi najpierw wyciągnąć z istniejącego podpisu certyfikat podpisującego i jego wystawców, zanim pobierze jakiekolwiek dane o unieważnieniach. Raport audytowy musi powiedzieć, kto podpisał. Budowa Lazarusa na Linuksie nie ma do sięgnięcia funkcji komunikatów Windows, bo wywołania platformowego CMS poza Windows są zaślepkami zwracającymi porażkę — i właśnie dlatego PDFlibPas robi ten spacer w czystym Pascalu i w ogóle nie używa CryptoAPI
Wyciąganie certyfikatów podpisującego z podpisanego PDF-a
Pięć metod TPDFlib pokrywa całą stronę odczytu, a każda przyjmuje InputFile, Password, FieldName. Każde wywołanie otwiera plik tylko do odczytu, odpowiada i zamyka go z powrotem, więc nie ma żadnego stanu dokumentu do pilnowania. GetSignatureEmbeddedCertificateCount i GetSignatureEmbeddedCertificateDER wyliczają zbiór certyfikatów CMS w kolejności zapisu. GetSignatureSignerCertificateDER zwraca certyfikat, który wyprodukował dany SignerInfo. GetSignatureCertificateChainLength i GetSignatureCertificateChainDER idą od tego podpisującego w stronę najdalszego wystawcy, jakiego podpis przy sobie wozi. Wszystkie indeksy liczą się od zera
Wyniki wracają jako AnsiString i właśnie takie je trzymaj. Blob DER przepchnięty przez string albo TStrings przechodzi przez konwersję zestawu znaków, a bajty wychodzące z drugiej strony nie parsują się już. Dlatego też biblioteka trzyma listy certyfikatów jako tablice AnsiString, a listy URL-i zwraca jako tekst po jednym w wierszu: adresy to czysty ASCII i konwersję przechodzą, bajty certyfikatów — nie
uses
  SysUtils, Classes, PDFlibrary, PDFlibEnterprise;

procedure SaveDer(const FileName: string; const Der: AnsiString);
var
  Fs: TFileStream;
begin
  Fs := TFileStream.Create(FileName, fmCreate);
  try
    if Der <> '' then
      Fs.WriteBuffer(Der[1], Length(Der));
  finally
    Fs.Free;
  end;
end;

const
  Src = 'contract-signed.pdf';
  Field = 'Signature1';
var
  Pdf: TPDFlibEnterprise;
  Count, ChainLen, I: Integer;
  SignerDer, LastDer: AnsiString;
begin
  Pdf := TPDFlibEnterprise.Create;
  try
    Count := Pdf.GetSignatureEmbeddedCertificateCount(Src, '', Field);
    WriteLn(Field, ': ', Count, ' certificate(s) in the CMS');
    for I := 0 to Count - 1 do
      SaveDer(Format('embedded-%d.cer', [I]),
        Pdf.GetSignatureEmbeddedCertificateDER(Src, '', Field, I));

    SignerDer := Pdf.GetSignatureSignerCertificateDER(Src, '', Field, 0);
    if SignerDer = '' then
      raise Exception.CreateFmt('%s: signer certificate missing or not matched', [Field]);
    SaveDer('signer.cer', SignerDer);

    ChainLen := Pdf.GetSignatureCertificateChainLength(Src, '', Field, 0);
    for I := 0 to ChainLen - 1 do
      SaveDer(Format('chain-%d.cer', [I]),
        Pdf.GetSignatureCertificateChainDER(Src, '', Field, 0, I));
    if ChainLen > 0 then
    begin
      // ostatnie ogniwo może wciąż mieć wystawcę, którego podpis nie osadził
      LastDer := Pdf.GetSignatureCertificateChainDER(Src, '', Field, 0, ChainLen - 1);
      WriteLn('Issuer locations: ', Pdf.GetCertificateIssuerURLs(LastDer));
    end;
  finally
    Pdf.Free;
  end;
end;
Dwa wyniki tego programu łatwo źle odczytać. Licznik 0 sam w sobie mówi bardzo mało: brakujące pole, złe hasło, blob, który nie jest DER, i SignedData po prostu pomijające opcjonalny zbiór certyfikatów — wszystko wraca jako 0 albo pusty łańcuch. Loguj nazwę pola obok tej liczby, jak robi to przykład, bo inaczej skończysz z debugowaniem niewłaściwego pliku. Drugi to długość łańcucha. Budowniczy łańcucha korzysta wyłącznie z certyfikatów osadzonych w podpisie, więc łańcuch kończący się przed korzeniem samowystawionym to norma. Podpisz plik naszym certyfikatem demo, którego wystawia testowy root, a GetSignatureCertificateChainLength zwróci 1, bo tego roota w CMS nie ma. Następny skok przychodzi z adresów, które raportuje GetCertificateIssuerURLs — wywołanie należące do edycji Enterprise razem z resztą API walidacji długoterminowej
Samo dopasowanie podpisującego obsługuje obie postaci SignerIdentifier dozwolone przez RFC 5652 §5.3. issuerAndSerialNumber to ta, którą testuje każdy. Postać [0] subjectKeyIdentifier, niejawnie otagowany OCTET STRING ze znacznikiem $80, to gałąź, którą czytniki pisane ręcznie zapominają najczęściej, a podpisujący identyfikujący się identyfikatorem klucza faktycznie ją emitują. Gdy użyta jest forma issuer-and-serial, obie połówki muszą się zgadzać: numer seryjny jest unikalny tylko w obrębie jednego wystawcy, więc dopasowanie na samym numerze może wylądować na certyfikacie od innego CA
Ile z /Contents to właściwie CMS?
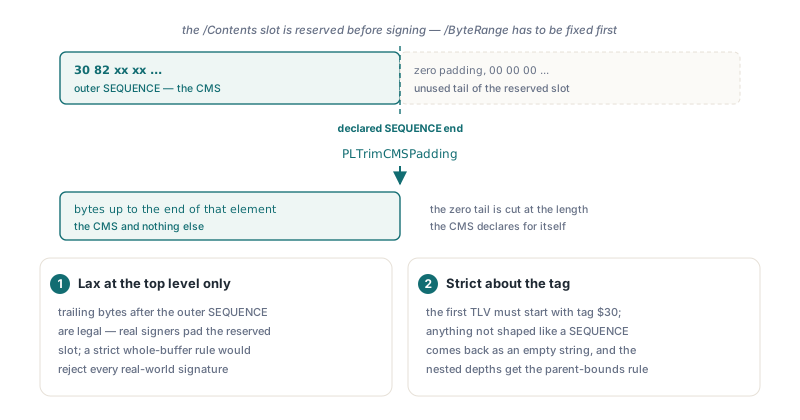
Wyłącznie prefiks pokryty przez zewnętrzny SEQUENCE, a PLTrimCMSPadding w jednostce PDFlibCMSRead ucina wszystko, co jest za nim. Powodem jest kolejność działań. ISO 32000-1 §12.8.1 wymaga, by /ByteRange był ustalony, zanim wartość podpisu w ogóle powstanie, więc podpisujący rezerwuje szesnastkowy ciąg /Contents z góry, daje mu hojny rozmiar i wypełnia niewykorzystany ogon zerami, gdy CMS jest już znany. Typowy podpisany plik wozi więc za CMS-em pas zer końcowych — tak długi, jak hojnie podpisujący zarezerwował slot
PLTrimCMSPadding czyta pierwszy TLV, wymaga znacznika $30 i zwraca bajty aż do końca tego elementu. Podaj 30 03 02 01 00 00 00 00, a odzyskasz pierwsze pięć bajtów; podaj 'not der', a dostaniesz pusty łańcuch. Ten szczytowy poziom to jedyne miejsce, gdzie bajty na końcu są legalne. Restrykcyjna reguła „element musi zużyć cały bufor" odrzuciłaby zwykłe podpisane pliki, podczas gdy pobłażliwa reguła „cokolwiek zostaje, jest w porządku" stosowana na każdej głębokości to dokładnie ten sposób, w jaki zagnieżdżone pola kończą z czytaniem bajtów, które nie są ich
Po co czytnikowi DER offset końca rodzica?
Bo zagnieżdżony element jest poprawny tylko wtedy, gdy kończy się wewnątrz rodzica, a sprawdzenie go wobec końca bufora tego nie dowodzi. DERReadTLV w PDFlibASN1 ogranicza każdy element całym łańcuchem, odrzuca długości, które przebiegłyby za koniec, i robi arytmetykę jako odejmowanie, więc wykraftowana czterobajtowa długość $7FFFFFFF nie zawinie sprawdzianu na ujemny. To bezpieczeństwo pamięci. Nie mówi nic o tym, czy element należy w miejscu, w którym go znaleziono
Wyobraź sobie SignerInfo, którego issuerAndSerialNumber deklaruje 40 bajtów, podczas gdy leżąca w środku nazwa wystawcy rości sobie 60. Każdy bajt jest wciąż w buforze, więc czytnik ograniczony buforem przyjmie nazwę, potem odczyta „numer seryjny" z następującego za nią algorytmu skrótu, a następnie porówna tę parę z osadzonymi certyfikatami. Nic nie zawodzi. Czasem porównanie nawet kończy się sukcesem — na złym certyfikacie
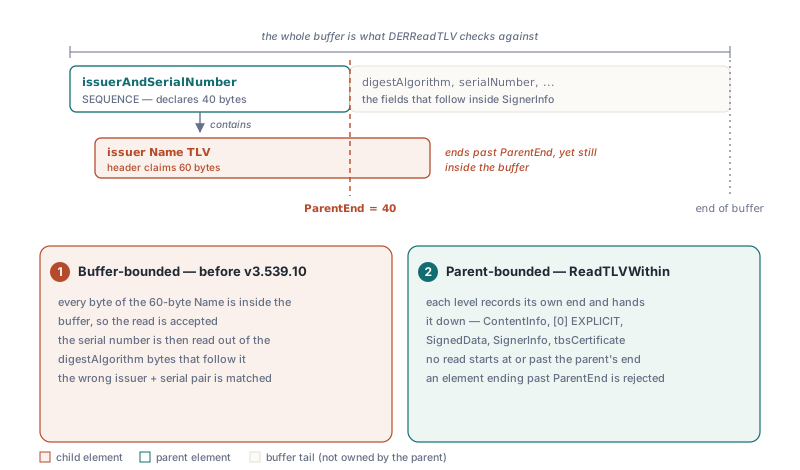
Walker CMS w PDFlibPas wnosi pozycję końca rodzica do każdego odczytu: od ContentInfo (RFC 5652 §3) przez wrapper [0] EXPLICIT i pola SignedData (§5.1), każdy SignerInfo i jego identyfikator, aż po pola tbsCertificate czytane przy dopasowywaniu podpisującego. Jeśli piszesz własnego walkera na publicznym DERReadTLV — dla tokena znacznika czasu albo odpowiedzi OCSP — ten sam wzorzec to kilkanaście linijek:
uses
  PDFlibASN1;

// Jeden odczyt dziecka, odrzucony, gdy kończyłoby się za rodzicem.
function ReadChild(const Data: AnsiString; ParentEnd: Integer;
  var Offset: Integer; out Tag: Byte; out Start, Len: Integer): Boolean;
begin
  Result := False;
  if (Offset < 1) or (Offset >= ParentEnd) then
    Exit;                          // w rodzicu nic nie zostało
  if not DERReadTLV(Data, Offset, Tag, Start, Len) then
    Exit;
  Result := Offset <= ParentEnd;  // Offset stoi teraz za dzieckiem
end;

// Zlicza człony SEQUENCE w SET OF, którego zawartość obejmuje
// Data[SetStart .. SetEnd - 1]. Zatrzymuje się na pierwszym członie, który przestrzeliwuje.
function CountSequences(const Data: AnsiString; SetStart, SetEnd: Integer): Integer;
var
  Offset, Start, Len: Integer;
  Tag: Byte;
begin
  Result := 0;
  Offset := SetStart;
  while Offset < SetEnd do
  begin
    if not ReadChild(Data, SetEnd, Offset, Tag, Start, Len) then
      Break;                       // bez resynchronizacji: wyrównanie przepadło
    if Tag = $30 then
      Inc(Result);
  end;
end;
Zwróć uwagę na Break. Wewnątrz zbioru certificates i zbioru signerInfos PLExtractCMSCertificates robi dokładnie to samo: element, który przestrzeliwuje koniec zbioru, zatrzymuje pętlę, a funkcja zwraca certyfikaty, które już przyjęła. Nigdy nie dokleja następnych bajtów crls ani signerInfos do ostatniego certyfikatu. Pominięcie złego elementu i jazda dalej jest kuszące i to jest zła decyzja. Gdy jedna zadeklarowana długość jest zła, czytnik nie wie już, gdzie zaczyna się następny element, a każde „ratowanie" to zgadywanie, który bajt wygląda jak znacznik. Przy zatrzymanej pętli zbiór, którego drugi certyfikat przestrzeliwuje o jeden bajt, daje licznik 1 i bajty pierwszego certyfikatu dokładnie tak, jak zostały zakodowane
Jak 2.999.3 może wyjść jako 1.15.3?
Dwa pierwsze łuki OID scalają się w jeden subidentyfikator, a ten subidentyfikator jest kodowany w base-128 jak każdy inny łuk — nie jest to jeden bajt. X.690 §8.19.4 definiuje tę wartość jako 40 * arc1 + arc2. Koder zapisujący ją przez Byte(...) jest poprawny do 127, czyli do 2.47. Dla 2.999 suma wynosi 1079, rzutowanie na bajt zostawia 55, a 55 dekoduje się jako 1.15. Identyfikator wskazuje teraz inną gałąź drzewa i nic nie narzeka. Wartości od 128 do 255 psują się inaczej: rzutowanie emituje jeden bajt z ustawionym bitem kontynuacji, a dekoder połyka w niego następny łuk
Skrót przetrwał w prawdziwym kodzie tak długo, bo większość identyfikatorów PKI nigdy nie dochodzi do granicy. Wszystko pod 1.2.840, 2.5.29 i 0.4.0 ma scaloną pierwszą wartość głęboko poniżej 128, więc zestaw testów zbudowany wyłącznie z pospolitych OID-ów podpisów nigdy nie ćwiczy drugiego bajtu. Tylko łuki joint-iso-itu-t od 2.48 wzwyż przekraczają tę linię. W PDFlibPas jedna funkcja, DER_OID, obsługuje kodera podpisanych atrybutów, wyszukiwanie wewnątrz DERFindExtensionByOID i sprawdzanie content-type SignedData, więc zapis i dopasowywanie nie mogą się rozjechać. Wektory testowe należą po obu stronach granicy:
uses
  SysUtils, PDFlibASN1;

function Hex(const S: AnsiString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + IntToHex(Byte(S[I]), 2) + ' ';
  Result := Trim(Result);
end;

procedure Check(const Oid, Expected: AnsiString);
begin
  if Hex(DER_OID(Oid)) <> Expected then
    WriteLn('MISMATCH ', Oid, ': ', Hex(DER_OID(Oid)), ' expected ', Expected)
  else
    WriteLn('ok       ', Oid);
end;

begin
  Check('2.47.1',               '06 02 7F 01');     // ostatnia wartość jednobajtowa
  Check('2.48.1',               '06 03 81 00 01');  // pierwsza wartość dwubajtowa
  Check('2.999.3',              '06 03 88 37 03');  // rzutowanie na Byte daje 1.15.3
  Check('2.5.29.14',            '06 03 55 1D 0E');
  Check('1.2.840.113549.1.7.2', '06 09 2A 86 48 86 F7 0D 01 07 02');
end.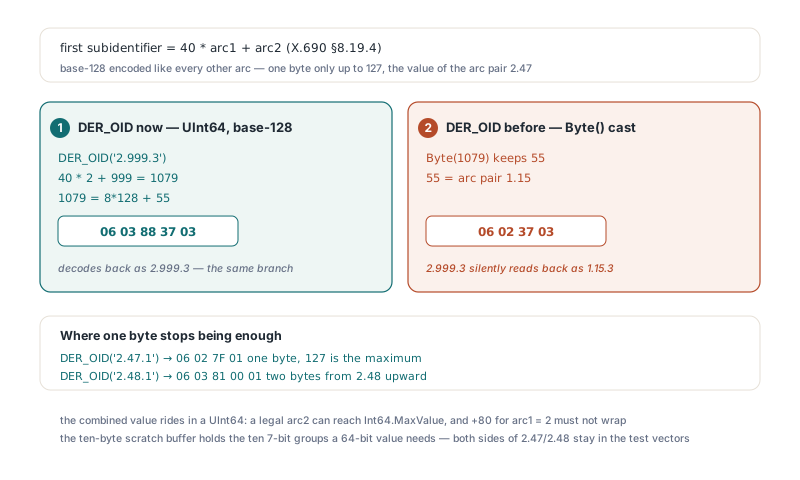
W tej samej linijce arytmetyki ukrywa się jeszcze jedno przepełnienie. DER_OID parsuje łuki do Int64, więc legalny drugi łuk może być tak duży jak Int64.MaxValue, a dodanie 80 dla arc1 = 2 przepełnia 64-bitową liczbę ze znakiem. Scalona wartość siedzi dlatego w UInt64, który unosi Int64.MaxValue + 80 bez zawinięcia — nikt nie wystawia tak wielkich OID-ów, ale wykraftowany łańcuch nadal może o taki poprosić. Dziesięciobajtowy bufor roboczy w DER_OID mieści dziesięć grup po 7 bitów, jakich wartość 64-bitowa może potrzebować, więc nawet 2.9223372036854775807 koduje się do dziesięciobajtowego subidentyfikatora zamiast zawinąć
Co przyjmuje walker CMS i gdzie mieszka weryfikacja
PDFlibCMSRead zwraca bajty leżące tam, gdzie każe je RFC 5652, i to jest cała jego robota. Nie sprawdza ani wartości podpisu, ani skrótu, ani okresu ważności. Walker przyjmuje wyłącznie DER: DERReadTLV odmawia długości niedookreślonych i wielobajtowych numerów znaczników, więc CMS zakodowany w BER przez nie trzymany się norm podpisujący raportuje zero certyfikatów. Wolimy to niż częściowy pars BER. W praktyce zdradza go bajt długości $80 tuż za zewnętrznym znacznikiem $30 — tak zaczyna się SEQUENCE o długości niedookreślonej
Certyfikaty atrybutowe i pozostałe warianty CertificateChoices są pomijane podczas przechodzenia zbioru certificates, bo tylko zwykły wariant Certificate jest certyfikatem X.509, którego budowa łańcucha i wyszukiwania unieważnień umieją użyć. Wszystko kryptograficzne zostaje przy kodzie, do którego należy: zaczyna się od sprawdzania pokrycia bajtów opisanego w podpisywaniu PAdES i walidacji ByteRange w Delphi, a kontynuuje klasyfikowaniem tego, co zmieniło się po podpisaniu PDF-a. To samo nawyk nieufności wobec deklarowanych długości przewija się przez hartowanie parsera PDF w Pascalu przeciw złośliwym plikom
Ekstrakcja certyfikatów, budowa łańcuchów i wywołania walidacji długoterminowej pokazane wyżej są częścią losLab PDF Library for Delphi, która działa na Delphi, C++Builderze i Lazarusie, więc ten sam kod czytający podpisy działa w usłudze Windows i w budowie linuksowej