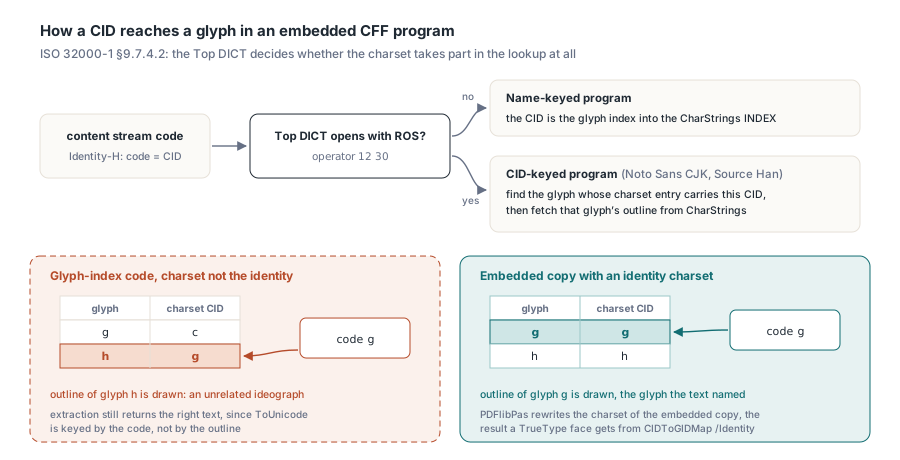
Chińska faktura złożona krojem Noto Sans SC z jego pliku .otf potrafi otworzyć się w mutool z obcymi ideogramami tam, gdzie powinna być nazwa klienta, choć krój TrueType renderuje tę samą stronę poprawnie. Winne jest charset CFF fontu; PDFlibPas przepisuje go w osadzonej kopii na identity, więc kody będące indeksami glifów trafiają na właściwe glify
Czy font pokaże ten problem, zależy od tego, jak został zbudowany. Program TrueType osadzony jako font CIDFontType2 dostaje CIDToGIDMap o wartości Identity i kod ze strumienia zawartości trafia na właściwy glif. Większość łacińskich fontów OpenType z zarysami CFF to programy name-keyed, a program CFF name-keyed używa przychodzącego CID wprost jako indeksu glifu. ISO 32000-1 w §9.7.4.2 wprost zauważa, że CID i GID pokrywają się w wielu fontach. Nie we wszystkich. Duże rodziny CJK zbudowane jako fonty CID-keyed — wśród nich Noto Sans CJK i spokrewnione z nim Source Han — niosą własną numerację CID, i writer, który wysyła indeksy glifów prosto w tę numerację, dostaje dowolny glif, akurat dzierżący pasujący CID
Co program CID-keyed CFF robi z CID
ISO 32000-1 §9.7.4.2 dzieli osadzone programy CFF na dwa przypadki, patrząc na Top DICT. Jeśli Top DICT używa operatorów CIDFont — w praktyce otwiera się operatorem ROS (operator 12 30: registry, ordering, supplement) — czytnik bierze CID ze strumienia zawartości, znajduje glif, którego wpis w charset niesie ten CID, i dopiero wtedy pobiera zarys z INDEX-u CharStrings. Bez operatorów CIDFont CID jest sam w sobie indeksem glifu, a charset nie odgrywa żadnej roli. Każdy czytnik stosujący §9.7.4.2 dosłownie narysuje więc zły glif dla kodu będącego indeksem glifu, ilekroć charset nie jest identity — na jakąkolwiek przeglądarkę się przestawisz. Sam charset, zdefiniowany w Adobe Technical Note #5176, występuje w trzech układach i ma dwa przypadki specjalne:
- Format 0 przechowuje jeden 2-bajtowy SID lub CID na glif, w kolejności glifów
- Format 1 przechowuje zakresy: pierwszy CID, za nim 1-bajtowa liczba glifów następujących po nim z kolejnymi CID-ami
- Format 2 to ten sam układ zakresów z 2-bajtową liczbą, co pasuje fontom o długich nieprzerwanych ciągach
- Glif 0 to
.notdefi nie ma wpisu w żadnym z formatów; offset charset 0, 1 albo 2 oznacza jeden z predefiniowanych charsetów zamiast wskazywać dane
Zacznij więc od ustalenia, z jakim typem fontu masz do czynienia. Identity-H po stronie PDF mówi tylko tyle, że kod 2-bajtowy równa się CID. Jak ten CID dochodzi do glifu, rozstrzyga się całkowicie wewnątrz programu fontu. Poniższa funkcja wyczytuje tabelę CFF z pliku .otf, przechodzi przez Top DICT w poszukiwaniu ROS i sprawdza, czy charset mapuje każdy glif na CID o tym samym numerze. Potrzebuje wyłącznie RTL
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // ucięty plik podniesie ERangeError zamiast błędnie odczytać dane
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Zwraca koniec INDEX-u spod Pos i wyznacza granice jego pierwszego obiektu
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // offsety liczone są od 1 od tego miejsca
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // Name INDEX
  SkipIndex(P, Dict, DictEnd);                           // Top DICT INDEX
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // liczba rzeczywista
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // bajt zarezerwowany
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef nie ma wpisu
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
Raport z CIDKeyed = True i IdentityCharset = False opisuje dokładnie ten font, o którym jest ten artykuł: każdy writer, który wrzuca indeksy glifów do strumienia zawartości bez uwzględnienia tego charsetu, narysuje nim złe glify. Wynik name-keyed albo font CID-keyed, którego charset akurat już jest identity, renderuje się poprawnie u tego samego writera. Dlatego jeden krój CJK w produkcie działa, a następny nie. Pętla porównuje wyłącznie pierwszy CID każdego zakresu. To wystarcza: zakres obejmuje kolejne glify niosące kolejne CID-y, więc zakres startujący na własnym indeksie glifu pozostaje na nim aż do końca
Indeksy glifów przechodzą przez cały słownik fontu
Writer PDF rzadko ma CID-y w ręku. Tabela cmap i silnik shapingu zwracają oba indeksy glifów, więc naturalny projekt zapisuje te indeksy jako 2-bajtowe kody Identity-H i kluczuje na nich wszystko pozostałe: tablicę szerokości /W, bitmapę /CIDSet, o którą prosi PDF/A, oraz CMap ToUnicode, dzięki której ekstrakcja odzyskuje tekst źródłowy. TrueType ma tu furtkę. Tabela 117 oferuje CIDToGIDMap, ale tylko dla CIDFonts typu 2; program CFF mieszka w foncie CIDFontType0, który nie ma żadnego sposobu, by przekierować CID po stronie PDF. To wyklucza przy okazji trik, jaki niektórzy writerzy stosują z TrueType — drugi "aliasowy" CID dla ponownie użytego glifu, poza końcem fontu, żeby ToUnicode mogło przypiąć inny tekst do każdego użycia. W foncie CFF taki alias nie wybiera żadnego glifu, a mutool zgłasza, że nie da się go zrenderować. Fonty mapujące U+4E00 i U+2F00 (KANGXI RADICAL ONE) na jeden zarys to przypadek typowy. Jeśli twój dokument potrzebuje, by te dwa znaki ekstrahowały się różnie, owiń dane wystąpienie w span marked-content z /ActualText (ISO 32000-1 §14.9.4), którego czytnik użyje zamiast mapowania fontu
Przepisywanie charsetu w miejscu
Są dwa sposoby pogodzenia kodów będących indeksami glifów z programem CID-keyed. Pierwszy tłumaczy każdy indeks glifu na CID fontu przed zapisaniem, co dotyka kodów strumienia zawartości, kluczy tablicy /W, pozycji bitów w /CIDSet, kodów źródłowych w ToUnicode i każdego subsetu powstającego przy zapisie. Drugi zmienia tę jedną niezgodną strukturę, czyli charset, tak że font odpowiada na indeksy glifów tak, jak odpowiadałby na nie program name-keyed. Druga droga jest bezpieczniejsza. Shaper, tabela szerokości, subseter i builder ToUnicode dalej pracują w przestrzeni glifów, a jedyny kod, który musi rozumieć CID-y, to krótka procedura uruchamiana raz na osadzonej kopii fontu. PDFlibPas wybiera właśnie tę drogę
Przepisanie zachowuje format charsetu i jego długość w bajtach. W formacie 0 każdy wpis jest nadpisywany własnym indeksem glifu. W formatach 1 i 2 zmienia się tylko pierwszy CID każdego zakresu, a liczby zostają bez zmian. Nic nie rośnie ani nie maleje. Offsety Top DICT do CharStrings, Private DICT-ów, FDArray i FDSelect pozostają ważne bez rekodowania czegokolwiek, a FDSelect — który przydziela słowniki hintingu według indeksu glifu — trzyma każdy glif w jego pierwotnym FD. Programy name-keyed, predefiniowane charsety, tabele CFF2 (te nie mają charsetu) i programy, które nie dają się sparsować, zostają nietknięte. Przepisanie uruchamiają trzy ścieżki kodu:
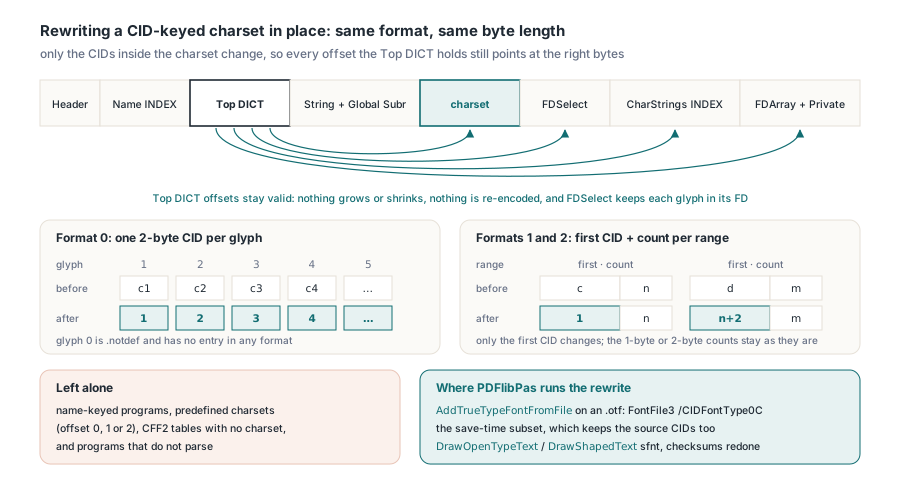
AddTrueTypeFontFromFilena pliku.otfosadza gołą tabelęCFFjakoFontFile3z podtypemCIDFontType0C, z charsetem już przepisanym- Subset tworzony przy zapisie zachowuje oryginalne indeksy glifów, ale i źródłowe CID-y, więc jego charset jest przepisywany drugi raz
- Towarzysz shapingu stojący za
DrawOpenTypeTextiDrawShapedTexttrzyma cały sfnt; po przepisaniu suma kontrolna tabeliCFFjest liczona od nowa, acheckSumAdjustmenttabeliheadprzyjmuje wartość0xB1B0AFBAminus suma pliku - Ta korekta jest zdefiniowana wyłącznie dla pojedynczego fontu, więc krój wyjęty z kolekcji dostaje samą sumę kontrolną tabeli
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // Plik .otf o zarysach CFF jest osadzany jako FontFile3 /CIDFontType0C;
    // osadzona kopia dostaje identity charset, gdy jest CID-keyed
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;
Sprawdź wynik przez renderowanie. Ekstrakcja problemu nie pokaże. pdftotext i każdy inny ekstraktor czytają ToUnicode, które jest kluczowane kodem ze strumienia zawartości i nie wie nic o tym, który zarys font dla niego wybiera, więc strona pokazująca złe ideogramy nadal ekstrahuje właściwy napis. mutool draw -r 150 -o page%d.png noto-sc.pdf pokazuje, jak strona wygląda naprawdę, a dla tej ścieżki DrawText popplerowy pdffonts noto-sc.pdf powinien wypisać font jako CID Type 0C. Wynik oczekiwany: oba wiersze renderują się w Noto Sans SC z glifami, które nazywa tekst źródłowy, i ten sam obraz pojawia się w Ghostscript
Która forma osadzenia wymaga PDF 1.6?
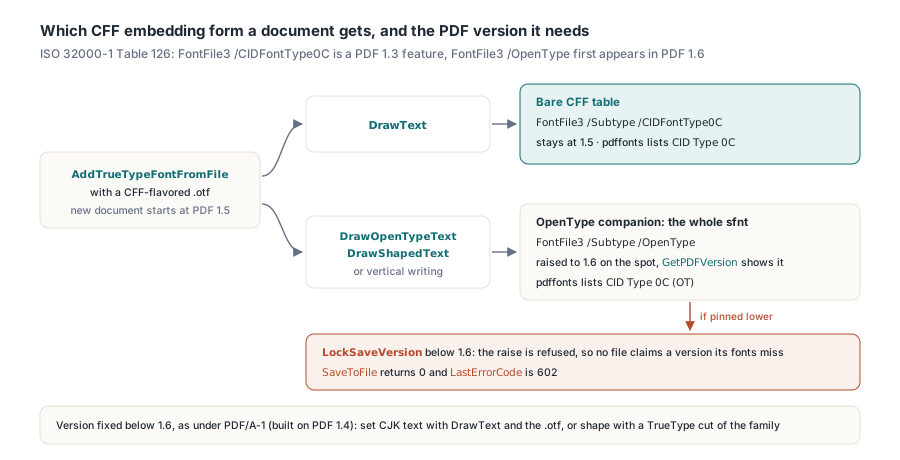
Forma OpenType. Tabela 126 ISO 32000-1 wymienia strumień FontFile3 o podtypie CIDFontType0C jako cechę PDF 1.3, podczas gdy podtyp OpenType — cały sfnt ze swoją tabelą CFF — pojawia się pierwszy raz w PDF 1.6. Nowe dokumenty PDFlibPas startują od wersji 1.5, w którą mieści się ścieżka gołego CFF przez DrawText. Pierwsze wołanie DrawOpenTypeText, DrawShapedText albo pionowego składania z krojem CFF tworzy towarzysza OpenType i podnosi dokument do 1.6 na miejscu, co GetPDFVersion zgłasza od razu. Blokada wersji zmienia te zasady. Jeśli LockSaveVersion przypiął dokument niżej, podniesienie zostaje odmówione, a SaveToFile zwraca 0 z LastErrorCode 602, więc żaden plik nie podaje wersji, której jego fonty nie spełniają. Gdy profil dostawy sztywno ustala wersję poniżej 1.6 — PDF/A-1 to częsty przypadek, bo jest zbudowany na PDF 1.4 — składaj tekst CJK przez DrawText z plikiem .otf albo weź cięcie TrueType tej rodziny do wszystkiego, co wymaga shapingu
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // Oczekiwane: 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // Oczekiwane: 1.6
    Lib.SaveToFile('shaped.pdf');  // Oczekiwane w pdffonts: CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // Oczekiwane: 602
  finally
    Lib.Free;
  end;
end;
Szerokości i ToUnicode kluczowane tymi samymi liczbami
Skoro charset jest identity, CID, indeks glifu i kod strumienia zawartości to jedna i ta sama liczba. Szerokości podążają za nią. ISO 32000-1 §9.7.4.3 indeksuje /W samym CID, w grupach będących albo CID-em startowym z tablicą szerokości, albo pierwszym CID, ostatnim CID i jedną wspólną szerokością — bez offsetu /FirstChar znanego z fontów prostych. Każdy CID pominięty przez tablicę dostaje /DW, a tabela 117 ustawia domyślną wartość /DW na 1000. Zero jest złe. Czytnik, który dla niewypisanych CID-ów cofa się do 0, zwija linię ideogramów w samą siebie. Dla pliku .otf ładowanego przez AddTrueTypeFontFromFile PDFlibPas zapisuje tablicę /W startującą od CID 0 i wypisującą advance każdego glifu, obok jawnego /DW 1000. Po stronie odczytu tekst CJK ekstrahujący się jako śmieci zwykle psuje się w połowie codespace tego samego potoku, a audyt fontów PDF/UA pod kątem szerokości, CharSet i CIDSet zestawia te tablice z osadzonym programem
ToUnicode ma własną zasadę numeracji. Wpis bfrange przechowuje tylko pierwszy napis docelowy, a §9.10.3 wymaga, by jego ostatni bajt nie został przez długość zakresu wypchnięty ponad 255, bo czytnik generuje kolejne napisy docelowe inkrementując wyłącznie ten ostatni bajt. Kolejne glify mapowane na U+4EFE, U+4EFF, U+4F00 i U+4F01 wyglądają jak jeden zakres. Nie są nim: czytnik zdekodowałby trzeci jako U+4E00. Writer PDFlibPas scala sąsiednie pary glif-Unicode w jeden bfrange tylko wtedy, gdy i kody źródłowe, i napisy docelowe mieszczą się w jednym bloku 256, a w przeciwnym razie dzieli ten ciąg. Pionowe składanie CJK idzie przez te same fonty-towarzysze, więc pionowy tekst japoński i chiński dziedziczy identity charset i te zakresy ToUnicode bez dodatkowych wołań
Każdy krój, który InspectOtfCharset zgłasza jako CID-keyed z charsetem różnym od identity, to przypadek, w którym kody będące indeksami glifów i font się rozjeżdżają. Osadzony przez PDFlibPas dla Delphi, taki krój zachowuje zarysy, offsety i długość charsetu, a zmieniają się CID-y w tej jednej tabeli, plus sumy kontrolne, gdy cały sfnt zostaje zachowany