Otwórz wygenerowany raport w czytniku ekranu, a typowe usterki pokażą się w ciągu minuty: „Strona 3 z 40” jest czytana na każdej stronie, logo firmy jest ogłaszane jako „grafika” i nic po tym, a tabela wychodzi jako jeden długi ciąg liczb bez nazw kolumn. PDF Library for Delphi omija wszystkie trzy dzięki automatycznemu tagowaniu struktury: zawołaj SetAutoTagMode raz, a zwykłe wywołania rysujące produkują akapity, nagłówki, ilustracje, tabele i pomijalne elementy oprawy strony w miarę rysowania dokumentu
Ręczna droga nadal istnieje. Możesz owijać każde wywołanie rysujące w BeginTag i EndTag, i dla dokumentów o nietypowej strukturze to właściwe narzędzie. Dla zwykłego raportu, faktury albo wyciągu ręczne tagowanie uzależnia jednak dostępność od tego, że nikt nigdy nie zapomni pary tagów — w każdej ścieżce kodu, która cokolwiek rysuje, przez cały czas życia produktu. Nie obstawalibyśmy na tym wymogu zgodności
Co włącza SetAutoTagMode
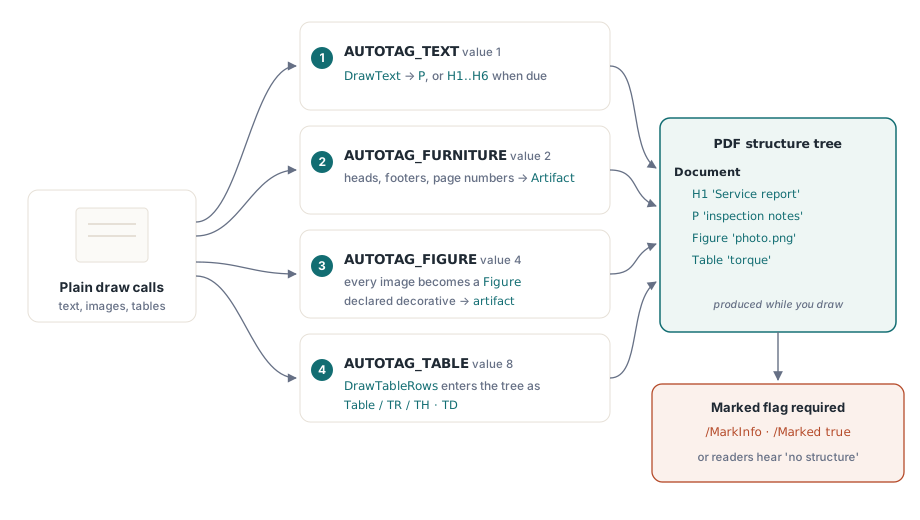
SetAutoTagMode przyjmuje maskę bitową i zwraca tryb obowiązujący przed wywołaniem. Każdy bit obejmuje jeden rodzaj treści:
AUTOTAG_TEXT(1): tekst staje się akapitem, albo nagłówkiem, gdy jeden został zarejestrowanyAUTOTAG_FURNITURE(2): bieżące nagłówki, stopki i numery stron stają się artefaktami, które czytnik pomijaAUTOTAG_FIGURE(4): narysowany obraz staje się ilustracją, albo artefaktem, gdy zadeklarowałeś go jako dekoracyjnyAUTOTAG_TABLE(8): narysowane tabele przenoszą swoje wiersze i komórki do drzewa strukturyAUTOTAG_DEFAULT(15): wszystkie cztery i wartość, którą rekomendujemy dla każdego nowego kodu raportów
Włączenie trybu oznacza też dokument jako otagowany i ten krok znaczy więcej, niż wygląda. Zgodnie z ISO 32000-1 §14.7.1 czytnik traktuje plik jako nieotagowany, chyba że słownik /MarkInfo w katalogu mówi /Marked true. Plik może nieść kompletne, poprawne drzewo struktury i mimo to być ogłaszany jako pozbawiony struktury w ogóle, bo brakuje jednej flagi, która każe technologii wspomagającej tego szukać. Drzewo tam jest. Nic go nie czyta
Tagowanie tekstu działa per wywołanie. Każde wywołanie DrawText, DrawWrappedText albo DrawTextBox staje się jednym elementem, więc akapit rysowany linia po linii pięcioma wywołaniami DrawText dociera do czytnika jako pięć jednolinijkowych akapitów. Jeśli twój kod układu sam łamie linie, warto to zmienić: przekaż cały akapit do DrawWrappedText i pozwól, by jedno wywołanie produkowało jeden akapit
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetOrigin(1);                          // początek w lewym górnym rogu, y rośnie w dół
    Lib.SetDocumentLanguage('en-US');
    Lib.SetAutoTagMode(AUTOTAG_DEFAULT);       // przed jakimkolwiek wywołaniem RegisterHeading
    Lib.AddStandardFont(4);

    Lib.SetTextSize(18);
    Lib.RegisterHeading(1, 'Annual service report');
    Lib.DrawText(72, 96, 'Annual service report');        // tagowane jako H1

    Lib.SetTextSize(11);
    Lib.DrawWrappedText(72, 130, 450,
      'Every unit installed before 2024 was inspected. ' +
      'Units that failed the torque check were serviced on site.');  // jeden P

    // ... pozostałe strony ...

    // Przechodzi po każdej istniejącej stronie, więc zawołaj raz, gdy strony są narysowane
    Lib.AddPageFooter('', 'Page &P of &N', 36, 1.0, 1);  // artefakt paginacji
    Lib.SaveToFile('report.pdf');
  finally
    Lib.Free;
  end;
end;
Komentarz w trzeciej linii jest tam nie bez powodu. RegisterHeading kolejkuje poziom nagłówka tylko wtedy, gdy tagowanie tekstu już działa, a SetAutoTagMode kasuje każdy skolejkowany poziom w chwili wykonania. Zarejestruj nagłówek najpierw, a tryb włącz potem, i tytuł wyjdzie jako zwykły akapit, bez żadnego błędu, który by ci to powiedział
Dlaczego nagłówek czeka przez obraz narysowany przed nim?
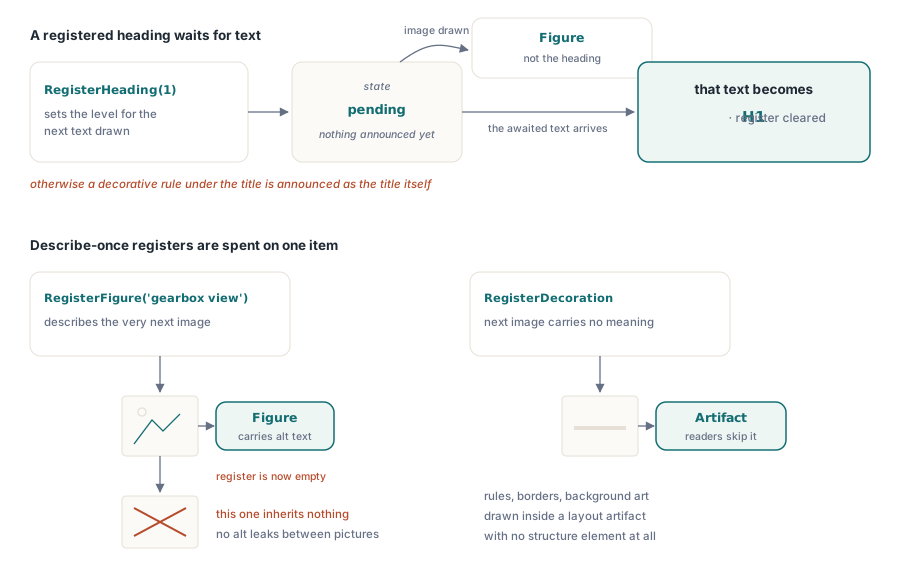
RegisterHeading nazywa poziom dla następnego kawałka tekstu i tylko tekst może go zużyć. Jeśli w międzyczasie zostanie narysowany obraz, obraz staje się ilustracją, a nagłówek czeka w kolejce na tekst, który przyjdzie potem. Oczywista implementacja pozwala każdemu tagowi skonsumować skolejkowany poziom, i wtedy typowa sekwencja — zarejestrowanie nagłówka sekcji, narysowanie obrazu banera i narysowanie tytułu — daje baner otagowany jako H2 i prawdziwy tytuł zdegradowany do akapitu. Czytelnik nawigujący po nagłówkach ląduje na obrazku
Z działania kolejki wynikają jeszcze dwie rzeczy. Poziom nagłówka przyczepia się do tekstu, który przyjdzie następny, niezależnie od łańcucha podanego do RegisterHeading: jeśli twój układ rysuje mały nadtytuł „Sekcja 3” nad tytułem, nadtytuł staje się nagłówkiem. I poziomy głębsze niż sześć są zapisywane jako H6, bo czytnik niczego poza tym nie zna. Argument Title nadal robi swoją robotę, zasilając konspekt, który DrawTOC zamienia potem w spis treści
Obrazy dostają tej samej obsługi „zużyte na jeden element”. RegisterFigure dostarcza opis, który poniesie następny obraz, a RegisterDecoration deklaruje następny obraz jako linię, obramowanie albo tło bez znaczenia, co jest potem zapisywane jako artefakt Layout (ISO 32000-1 §14.8.2.2). Każdą deklarację konsumuje dokładnie jeden obraz, więc późniejszy obraz nigdy nie odziedziczy opisu pisanego dla wcześniejszego. Tekst alt przyczepiony do niewłaściwego obrazka jest gorszy niż żaden, bo czytnik stwierdza coś fałszywego z pełnym przekonaniem
Celowo nie próbowaliśmy wnioskować, które obrazy są dekoracyjne. Obraz to albo treść, którą czytnik powinien opisać, albo treść, którą powinien pominąć, i tylko wołający kod wie, które. Przypadku trzeciego trzeba unikać: obraz narysowany bez żadnej deklaracji staje się ilustracją bez opisu, co wywala PDF/UA i każe czytnikowi ekranu zatrzymać się, powiedzieć „grafika” i potem nic. Jeśli przeszukasz kod raportu greppem za DrawImage, każde trafienie powinno mieć RegisterFigure albo RegisterDecoration tuż nad sobą
Lib.RegisterHeading(2, 'Gearbox inspection');   // skolejkowany na następny tekst

Lib.RegisterFigure('Exploded view of the gearbox assembly');
Lib.AddImageFromFile('gearbox.png', 0);       // wczytuje i zaznacza obraz
Lib.DrawImage(72, 160, 360, 270);             // staje się otagowaną ilustracją Figure

Lib.RegisterDecoration;                       // bezsensowna linia
Lib.AddImageFromFile('divider.png', 0);
Lib.DrawImage(72, 450, 360, 4);               // rysowany wewnątrz artefaktu układu

Lib.DrawText(72, 480, 'Gearbox inspection');  // dopiero teraz pojawia się H2
Opis zasługuje na więcej starania niż jakikolwiek inny łańcuch w dokumencie. Czytelnik niewidzący dostaje go w miejsce obrazka i to wszystko, co dostaje. „Wykres” nie mówi mu nic; „Przychody kwartalne wg regionów, z regionem wschodnim najwyższym w Q3” mówi mu to, co widzący czytelnik wyciąga z obrazu w dwie sekundy
Tabele: wiersze nagłówka są deklarowane, nigdy zgadywane
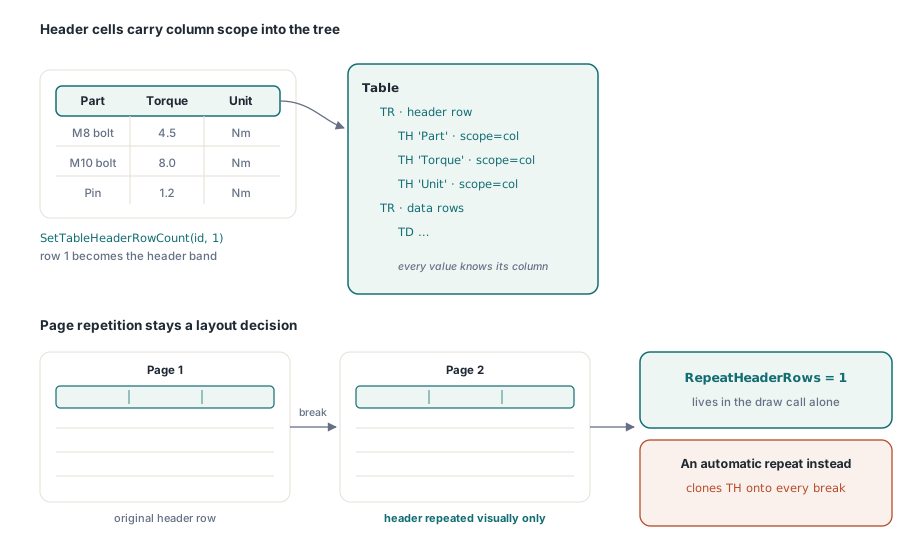
Z włączonym bitem tabeli DrawTableRows zapisuje tabelę, jej wiersze i komórki do drzewa struktury, więc czytnik potrafi powiedzieć, w której kolumnie leży wartość, zamiast wykrzykiwać siatkę jako niezwiązany tekst. SetTableHeaderRowCount mówi, ile wiodących wierszy to nagłówki. Te wiersze są zapisywane jako komórki TH z zakresem kolumnowym, co pozwala czytnikowi ogłosić „Torque” przed wartością, do której użytkownik przeszedł
Liczba wierszy nagłówka domyślnie wynosi zero i to był świadomy wybór. Pierwszy wiersz tabeli zwykle jest nagłówkiem, więc zgadywanie byłoby trafne większością czasu. Koszt złego zgadnięcia jest jednak asymetryczny: wiersz danych wzięty za nagłówek jest czytany na głos przed każdą wartością w swojej kolumnie, co o wiele bardziej miesza niż tabela bez nagłówków w ogóle. Jedna linijka kodu od ciebie jest tańsza niż ten tryb awarii
Deklarowanie wierszy nagłówka i powtarzanie ich na każdej stronie to osobne decyzje. SetTableHeaderRowCount jest semantyczne i nie zmienia na stronie niczego. Powtarzanie to układ i należy do argumentu RepeatHeaderRows wywołania DrawTaggedTableRows. Gdyby obie rzeczy były jednym ustawieniem, żądanie poprawnych tagów nagłówkowych zaczęłoby też rysować powtarzane pasy nagłówkowe, o które nie prosiłeś, i układ sprawdzany strona po stronie by się przesunął. Wiersze podane jako RepeatHeaderRows też są tagowane jako nagłówki, więc nie musisz mówić tego samego dwa razy
var
  TableID: Integer;
begin
  TableID := Lib.CreateTable(40, 3);
  Lib.SetTableHeaderRowCount(TableID, 1);       // wiersz 1 to pas nagłówka
  Lib.SetTableCellContent(TableID, 1, 1, 'Part');
  Lib.SetTableCellContent(TableID, 1, 2, 'Torque');
  Lib.SetTableCellContent(TableID, 1, 3, 'Unit');
  // ... wypełnij wiersze danych ...
  // Narysuj wiersze 1..40 w paśmie 600pt, powtarzając jeden wiersz nagłówka na stronę
  Lib.DrawTaggedTableRows(TableID, 72, 150, 600, 1, 40, 1);
end;
Ręcznie tagowane sekcje wewnątrz automatycznego dokumentu
Tagowanie automatyczne schodzi na bok, dopóki tag otwarty ręcznie jest wciąż otwarty. Pozwala to twemu kodowi samemu opisać część dokumentu i zostawić resztę bibliotece bez wzajemnego zagnieżdżania się obu, co jest układem, jakiego chcą większość prawdziwych dokumentów. Strona tytułowa i blok podpisów mają strukturę, którą rozumie tylko twój kod. Dwieście stron tekstu głównego między nimi — już nie
Trzy reguły utrzymują wynik poprawnym niezależnie od miksu, którego użyjesz. Nic nie jest tagowane wewnątrz artefaktu, bo sekwencja marked-content dla artefaktu nie może jednocześnie nieść elementu struktury, a plik, który spróbuje, wywala walidację PDF/UA. Pusty tekst nie otwiera żadnego elementu, więc zabłąkane DrawText z pustym łańcuchem nie zostawi po sobie elementu, który czytnik ogłaszałby jako pustkę. I wywołanie biblioteczne, które wewnątrz rysuje przez inne wywołania rysujące, otwiera jeden tag na zewnętrznym poziomie, więc jego kawałki nigdy nie lądują zagnieżdżone we własnym, drugim elemencie
Po zapisie przeczytaj drzewo z powrotem, zanim mu zaufasz. API odczytu jest indeksowane od 1, co nas zaskoczyło: nasza pierwsza pętla kontrolna chodziła od 0 do StructTreeItemCount - 1, dostała pusty rekord na starcie, nigdy nie dosięgła ostatniego elementu, i przez chwilę byliśmy przekonani, że jakiś akapit zniknął. Nic nie znikło. Pętla była po prostu o jeden off na obu końcach
var
  I: Integer;
begin
  // Cytat blokowy otagowany ręcznie; tagowanie automatyczne trzyma się od niego z dala
  Lib.BeginTag('BlockQuote', '', '');
  Lib.DrawWrappedText(72, 520, 450,
    'All readings were taken with the unit at operating temperature.');
  Lib.EndTag;
  Lib.SaveToFile('report.pdf');

  // Przeczytaj drzewo z powrotem: indeksy biegną od 1 do StructTreeItemCount
  if Lib.LoadFromFile('report.pdf', '') = 1 then
    for I := 1 to Lib.StructTreeItemCount do
      Writeln(Lib.GetStructTreeItemText(I, 2), '  ',    // typ po rozwiązaniu
              Lib.GetStructTreeItemText(I, 4));         // /Alt, jeśli jest
end;
Taki wypis to szybka kontrola sensowności, nie werdykt. Chcesz zobaczyć H1 przed pierwszym akapitem, każdą ilustrację niosącą swój opis i żadną ilustrację z pustym /Alt
Gdy kolejność rysowania i kolejność czytania się rozchodzą
Tagowanie automatyczne zapisuje elementy w kolejności rysowania treści. Jeśli twój kod układu rysuje pasek boczny przed treścią główną, to jest kolejność, którą trzyma drzewo, i to jest kolejność, którą czyta czytnik ekranu. Dla dokumentów, gdzie kolejność wizualna i kolejność czytania naprawdę się różnią, albo które potrzebują innych typów struktury albo języka per element, lepszym dopasowaniem jest API tagowania ręcznego, a przewodnik po tagowanym PDF i strukturze dostępności omawia role, zakresy i powiązania nagłówków w szczegółach
Dla stron, których sam nie rysowałeś — na przykład importowanych bez marked content — AutoTagPages działa po fakcie: bierze medianę rozmiaru tekstu na podanych stronach jako tekst główny, traktuje wyraźnie większe biegi jako nagłówki i oznacza pozostałe malowanie jako artefakty. To właściwe narzędzie dla treści, których nie da się wygenerować od nowa. Dla wszystkiego, co rysuje twój własny kod, wolimy tagowanie w czasie rysowania, bo tam bibliotece mówi się, czym jest nagłówek, zamiast zgadywać z rozmiaru fontu
Gdy dokument jest gotowy, przepuść go przez checker zamiast zakładać: notatki o preflight PDF/A i PDF/UA pokazują, jak dostać werdykt o strukturze, którą wyprodukowałeś, a artykuł o eksporcie raportów napędzanym datasetem pokazuje, gdzie te wywołania siedzą w silniku raportów budującym układ z danych
Ponieważ PDF Library for Delphi jest napisana w natywnym Pascalu dla Delphi, C++Buildera i Lazarusa, bez zewnętrznego runtime'u PDF, który trzeba dołączać, otagowany wynik pochodzi z tego samego kodu, który rysuje stronę. Kompletne API i listę platform znajdziesz na stronie produktu PDF Library for Delphi