PDFium Component versjon 3.117.0 kobler en tabell som brytes over en sidegrense når enten begge fragmentene berører sidekantene, eller ingen brødtekst ligger under det første fragmentet og over det andre, med løpende topp- og bunntekster ignorert. ExtractDocumentTables bruker den innholdsbaserte testen som et alternativ til den eldre sidemargtesten, avviser et fragment på neste side der den første raden er én enkelt bildetekstcelle i full bredde, og beholder en enkelt rad som renner over på den følgende siden, som en del av fortsettelseskjeden sin
Artikkelen om tabellgjenkjenning og -uttrekk presenterte fortsettelse som fire strenge porter og behandlet «berører sidekanten» som én av dem. Den beskrivelsen var korrekt for utgivelsen den dekket, og den var også feil for de fleste tabellene folk faktisk mater komponenten med. Denne artikkelen er korreksjonen: hvilke dokumenter margtesten ikke klarer, hva som erstattet den, og de to sidetilfellene rettelsen dro med seg
Hvorfor feiler sidemargtesten på Word-eksporter?
Sidemargtesten feiler fordi et tekstbehandlingsprogram slutter å legge ut rader ved den nederste margen, ikke ved papirkanten. Med standardverdien ContinuationMargin på 36 punkter krevde den opprinnelige regelen at underkanten til det tidligere fragmentet lå innenfor 36 punkter fra sidebunnen, og overkanten til det senere fragmentet innenfor 36 punkter fra sidetoppen. Et dokument eksportert fra Word med standardmargene på én tomme legger den siste raden minst 72 punkter over sidebunnen, enda lenger opp hvis en bunntekst finnes, så betingelsen holdt aldri. Hver lang tabell i et slikt dokument kom tilbake som uavhengige fragmenter med ContinuationGroup på null, og kalleren var tilbake til å sy sammen for hånd. Testen gir fortsatt mening for det den var laget rundt: rapporter generert av layoutmotorer som fyller en side til en fast innholdsramme og starter neste side helt øverst. Det er ikke en dårlig regel, det er en ufullstendig en, og derfor beholdt versjon 3.117.0 den og la til en andre vei i stedet for å erstatte den
Hva sjekker den innholdsbaserte testen i stedet?
Den innholdsbaserte testen sjekker om noe annet enn tabellen opptar plassen mellom de to fragmentene, ved hjelp av ordboksene på hver side og ikke sidegeometrien. Mens ExtractDocumentTables går gjennom dokumentet, registrerer den per side den laveste underkanten av et ord hvis topp ligger over bunntekstsonen, og den høyeste overkanten av et ord hvis bunn ligger under topptekstsonen. Begge sonene er ContinuationMargin punkter dype, så det samme alternativet gjør nå dobbel tjeneste som slakk ved sidekanten og som høyden på sonene for løpende topp- og bunntekst. Et par fragmenter passerer når underkanten til det tidligere ligger på eller under den laveste brødteksten på siden sin, og overkanten til det senere ligger på eller over den høyeste brødteksten på neste side, hver av dem innenfor AlignmentTolerance. I klartekst: tabellen var det siste på side N og det første på side N+1, og et sidetall eller en dokumenttittel i marginsonen teller ikke. Den utelatelsen er ikke vilkårlig. ISO 32000-1 §14.8.2.2 klassifiserer løpende topp- og bunntekster som pagineringsartefakter, innhold som finnes på grunn av sideskiftet og ikke på tross av det, og den samme tanken som lar en tagget leser hoppe over dem, er det som lar en tabell fortsette forbi dem. Artikkelen om markert innhold dekker hvordan taggede filer deklarerer slike artefakter eksplisitt; her utledes klassifiseringen fra posisjon, fordi de fleste eksporterte tabeller ikke har noen tagger i det hele tatt
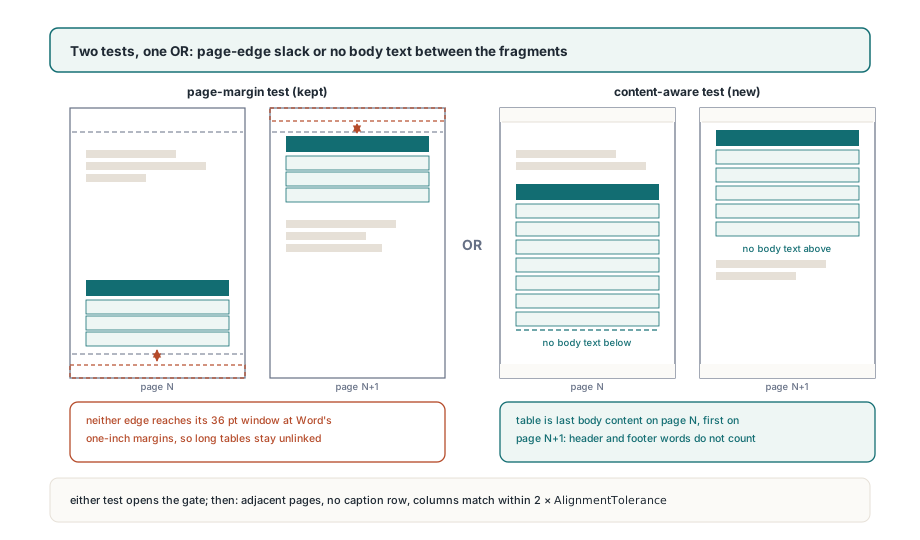
De to testene kombineres med OR. En rapport fra en layoutmotor der tabellene går helt ut til papirkanten, passerer den første; en Word-eksport der tabellene stopper ved margen, passerer den andre; et dokument som gjør begge, passerer to ganger. Først etter at én av dem lykkes, kjører de resterende portene, og de kjører i fast rekkefølge: sidetallene må være tilstøtende, det senere fragmentet må ikke åpne med en bildetekstrad, og kolonnegrensene må stemme innenfor to ganger AlignmentTolerance, som er 6 punkter med standardverdiene. Oppramsingen er TPdfTableContinuation med verdiene ptcNone, ptcStart, ptcMiddle og ptcEnd. Et fragment som ble merket ptcEnd og deretter kobles videre til enda en side, oppgraderes til ptcMiddle, så en tabell over tre sider leses som start, middle, end i siderekkefølge. Gruppetall starter på 1, og 0 betyr ukoblet, og ToJson sender ut den samme informasjonen som medlemmene continuation og continuationGroup, som er formen å foretrekke hvis en tjeneste nedstrøms gjør sammensyingen
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectContinuations := True;     // standard; tatt med for tydelighetens skyld
    Options.ContinuationMargin := 54;        // bunntekst på to linjer, ca. 50 pt dyp

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d (%d rows)',
          [Tables[I].PageNumber, Tables[I].RowCount]));
      end;
  finally
    Pdf.Free;
  end;
end;
Hvordan hindrer en bildetekstrad at to tabeller smelter sammen?
Et fragment på neste side der den første raden er én celle som spenner over alle kolonnene, behandles som en ny tabell, aldri som resten av den forrige. Denne regelen finnes fordi den innholdsbaserte testen kobler for ivrig på egen hånd. Tilfellet som avslørte det, var et skjema i utskriftsstil: en tabell slutter nær bunnen av side 1, en andre tabell med identiske kolonnebredder starter nær toppen av side 2, ingenting annet enn bunnteksten ligger mellom dem, og kolonnene stemmer på punktet. Under margtesten møttes de aldri, fordi ingen av dem berørte en kant; under innholdstesten koblet de seg umiddelbart, og et skjema med seksjoner ble ett usammenhengende rutenett. Det som skiller dem, er synlig i cellestrukturen. Den andre tabellen åpner med en seksjonsoverskrift som «RECIPIENT INFORMATION», lagt ut som én sammenslått celle over hele bredden, og en ekte fortsettelse gjør aldri det, fordi overskriften hører til tabellen som allerede startet på forrige side. TableStartsWithCaptionRow uttrykker nøyaktig det: fragmentet har minst to kolonner og inneholder en celle med RowIndex = 0, ColumnIndex = 0 og ColumnSpan = ColumnCount. Sjekken kjører bare på det senere fragmentet, så en tabell der dens egen bildetekstrad ligger på den første siden, er upåvirket; bildeteksten er på side N, og bare fragmentet på side N+1 inspiseres
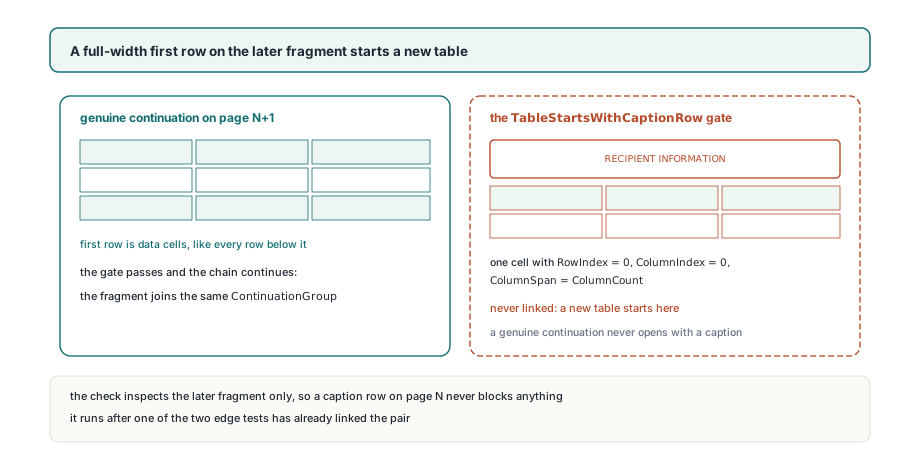
Kolonnesammenligningen som følger, TablesHaveMatchingColumns, er strengere enn «samme antall kolonner». Den bygger grensestillingene til hvert fragment på nytt fra cellerektanglene, interpolerer grenser som sammenslåtte celler skjuler, og avviser paret når noen grense avviker mer enn toleransen. To tabeller med fire kolonner og ulike proporsjoner holder seg derfor fra hverandre selv når alt annet stemmer
Hva skjer med en enkelt rad som renner over på neste side?
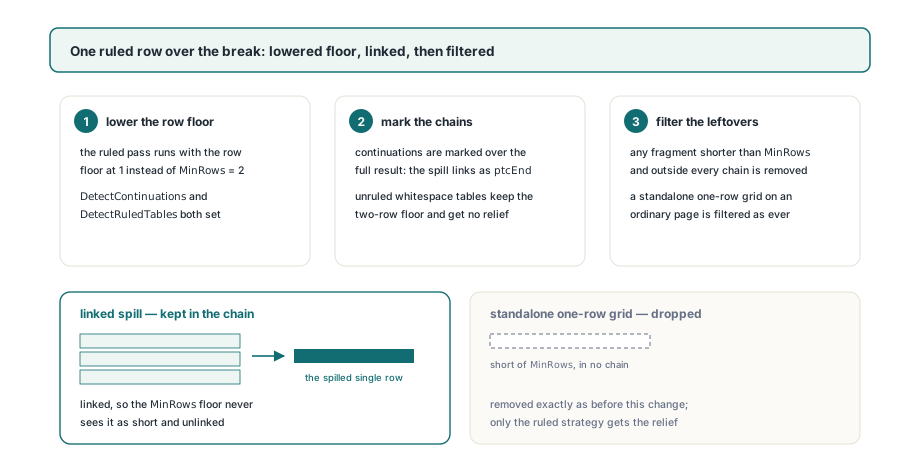
Et linjenett som bærer én rad over på den følgende siden, oppdages nå og kobles, forutsatt at den havner i en fortsettelseskjede; alene forkastes den. Standardverdien MinRows på 2 finnes for å hindre at et par løse linjer rapporteres som en tabell, men en siste rad som er dyttet over sideskiftet, er en ekte rad som en hard grense på 2 stille droppet, og resten av tabellen så komplett ut når den ikke var det. Dokumentgjennomgangen håndterer det i tre trinn. Når både DetectContinuations og DetectRuledTables er satt, kjører gjennomgangen per side detektoren for linjenett med radgrensen midlertidig senket til 1, og derfor godtar ExtractTables nå MinRows på 1 for linjenett, mens mellomromsdeteksjonen beholder en intern grense på 2. Fortsettelser merkes over hele resultatet. Deretter fjernes hver tabell som er kortere enn kallerens MinRows og ikke er del av noen kjede. Fragmentet på én rad overlever bare fordi det ble koblet, og et rutenett på én rad midt på en ellers vanlig side filtreres bort nøyaktig som før
// Bygg hver kjede på nytt som én CSV, og dropp gjentatte overskriftsrader
// på fortsettelsesfragmentene
procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R: Integer;
  Lines: TStringList;
  Csv: TStringList;
begin
  Csv := TStringList.Create;
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      if Tables[I].Continuation in [ptcNone, ptcStart] then
        Csv.Clear;
      Lines.Text := string(Tables[I].ToCsv);
      if (Tables[I].Continuation in [ptcMiddle, ptcEnd]) and
         (Lines.Count > 1) and (Tables[I].RowCount > 1) then
        Lines.Delete(0);            // overskrift gjentatt av tekstbehandleren
      for R := 0 to Lines.Count - 1 do
        Csv.Add(Lines[R]);
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Csv.SaveToFile(Format('%s\page%d-group%d.csv',
          [Folder, Tables[I].PageNumber, Tables[I].ContinuationGroup]));
    end;
  finally
    Lines.Free;
    Csv.Free;
  end;
end;
To detaljer i den rutinen er bevisste. Raden som renner over alene, strippes aldri, fordi vakten på RowCount beholder den, og en tekstbehandler som gjentar overskriftsraden på hver side, lager et fragment der første linje er overskriften igjen, så å droppe linje null på middle- og end-fragmenter er riktig for det tilfellet og galt for en generator som ikke gjentar overskrifter. Sjekk ett dokument før du slipper rutinen løs på en mappe
Hvor reglene fortsatt stopper
Den innholdsbaserte testen er ikke bedre enn tekstlaget den leser. På en skannet side helt uten tekst faller de registrerte ytterpunktene for brødtekst tilbake på sidegrensene, betingelsen «ingenting mellom» oppfylles tomt, og bare portene for bildetekstrad og kolonner gjenstår; et linjenett på en slik side finnes fortsatt som et tomt skjelett, så kjeden kan kobles riktig, men ingenting ved den omkringliggende teksten ble faktisk verifisert. Legg til et tekstlag først hvis det betyr noe. Bunntekster som er gjengitt som bilder og ikke som tekst, er usynlige for sonelogikken og harmløse av samme grunn
Sonene er ett tall. En bunntekst som er dypere enn ContinuationMargin, lar de nederste linjene sine ligge inne i brødtekstsonen, noe som får det tidligere fragmentet til å se ut som om det følges av tekst, og blokkerer koblingen; øk alternativet til den virkelige sonedybden, slik det første eksemplet gjør. Øker du det for mye, glir et kort avsluttende avsnitt nær bunnen av siden inn i sonen og ignoreres, noe som kobler en tabell til hva som helst som følger etter den. Bildetekstregelen har en speilvendt feilmodus: en generator som skriver et sammenslått «continued»-banner som første rad i hvert fortsettelsesfragment, vil få de fragmentene avvist som nye tabeller, og det eneste botemidlet i dag er å sy sammen selv etter ContinuationGroup, uten å løsne på noe, fordi regelen ikke har noen bryter
Tabeller funnet via mellomrom får ingen av lempningene for enkeltrader. Mellomromsstrategien trenger to justerte rader for i det hele tatt å se en tabell, så en tabell uten linjenett som renner over med én rad, rapporteres fortsatt én rad for kort. Når du treffer det, gir ordboksene bak strukturerte tekstblokker og leserekkefølge deg råposisjonene du kan gjenopprette den med. På utvalget som drev dette arbeidet, tretten eksporter fra tekstbehandlere og nettlesere, koblet de fem dokumentene med ekte flersidige tabeller seg til enkeltkjeder, og skjemaet i utskriftsstil som tidligere smeltet sammen, holdt seg atskilt, og det er listen utgivelsen ble målt mot, ikke et løfte om enhver utforming
Fortsettelsesmerking, bildetekstregelen og gjennomgangen for enkeltrader ligger alle i veien på dokumentnivå som deles av Delphi-, C++Builder- og Lazarus-bygg; hele API-et for tabelluttrekk er beskrevet på siden for PDFium Component for Delphi