HotXLS Delphi Excel Component beholder OpenDocument-datapilottabeller gjennom en åpne- og lagre-syklus for ODS ved å fange <table:data-pilot-tables>-deltreet i content.xml ordrett ved åpning og spille det av ved lagring, fra og med v2.382.0. Fra og med v2.382.1 bærer fragmentet også hver XML-navneromsbinding som forgjengerne deklarererte, så den lagrede pivotdefinisjonen forblir velformet for enhver konsument, ikke bare for HotXLS
Feilen som tvang fram begge endringene, kom ut av en streng korpuskjøring. Eksemplet official-pivot.ods, skrevet av et LibreOffice 6.1-utviklingsbygg, inneholder én pivot med navnet DataPilot1 som leser Sheet1.A2:E30 og legger resultatet i Sheet1.G6:J18. Åpne den med HotXLS, lagre den uendret, tell <table:data-pilot-table>-elementer i utdataene: én inn, null ut, på Win32 og Win64 likt. Ingenting i testen rørte pivoten. Den første runden med undersøkelser hadde bare sammenlignet cellekonstanter og gikk gjennom; den strukturelle asserten er det som avslørte tapet, og det minner om at «verdiene stemmer» er en svak definisjon av troskap ved tur-retur
Hvorfor forsvinner en ODS-pivottabell etter en lagring med biblioteket?
En ODS-pivottabell forsvinner fordi HotXLS ikke har noen modell i minnet for OpenDocument-datapilottabeller, og ODS-skriveren bygger content.xml utelukkende fra modellen. Skriveren setter sammen automatiske stiler, én <table:table> per regnearkark, <table:content-validations>, <table:named-expressions> og <table:database-ranges>, alle generert fra objekter arbeidsboken faktisk har. En pivotdefinisjon — ODF 1.3 Part 3 §9.6, en <table:data-pilot-tables>-beholder med én <table:data-pilot-table> per pivot, som bærer sin table:source-cell-range, sine table:data-pilot-field-barn, sin table:target-range-address og table:buttons — har ingen objekter å bo i, så den regenererte delen utelater den rett og slett
Kontrasten til XLSX er bevisst. HotXLS parser SpreadsheetML-pivotcacher og pivottabeller inn i en ekte modell som du kan bygge, utvide med beregnede felt og oppdatere fra Delphi, så de overlever en lagring fordi de skrives på nytt og ikke kopieres. ODS-pivoter er en mye sjeldnere forespørsel, og å modellere ODF-ordforrådet for datapiloter bare for tur-returens skyld ville være mye kode som ingen redigerer. Det pragmatiske svaret er det samme som HotXLS allerede bruker på ukjente extLst-blokker i XLSX: behold det du ikke modellerer, byte for byte hvis du kan, hendelse for hendelse hvis du ikke kan
Hva gjorde den første Pos-baserte fangsten feil?
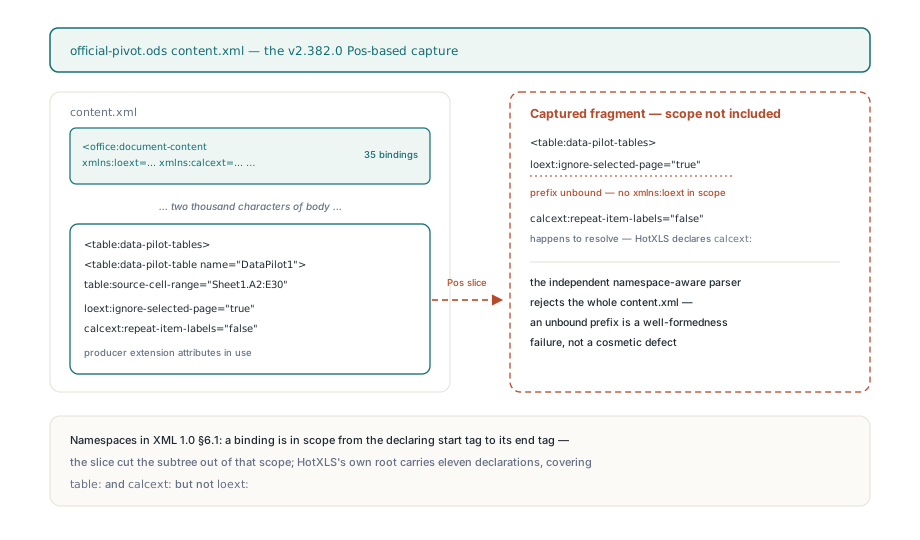
Fangsten i v2.382.0 skar pivotdefinisjonen ut av content.xml som en ren streng, og utsnittet manglet navneromsdeklarasjonene som gjorde den meningsfull. Implementasjonen var så kort som den høres ut — dekod delen til en WideString, finn åpningstaggen med Pos, finn lukketaggen etter den, og kopier spennet inn i FRawOdsDataPilotTablesXml på arbeidsboken:
// HotXLS v2.382.0 -- erstattet én utgivelse senere
function OdsCaptureDataPilotTablesXml(Stream: TStream): WideString;
const
  OpenTag: WideString = '<table:data-pilot-tables';
  CloseTag: WideString = '</table:data-pilot-tables>';
var
  Text: WideString;
  StartPos, ClosePos: Integer;
begin
  Result := '';
  Text := LoadPartAsWideString(Stream);   // hele content.xml i minnet
  StartPos := Pos(OpenTag, Text);
  if StartPos = 0 then Exit;
  ClosePos := Pos(CloseTag, Copy(Text, StartPos, MaxInt));
  if ClosePos = 0 then Exit;
  Result := Copy(Text, StartPos, ClosePos + Length(CloseTag) - 1);
end;
Tellepåstanden ble grønn, og rettelsen ble levert. Det som fanget den opp, var en andre og strengere sjekk som ble lagt til samme dag: hver XML-del i den lagrede pakken mates til en uavhengig navneromsbevisst parser utenfor HotXLS, og den parseren avviste den nye content.xml med en feil for ubundet prefiks. Pivoten fra LibreOffice bærer produsentens utvidelsesattributter — loext:ignore-selected-page="true" på et sidefelt, calcext:repeat-item-labels="false" på hvert nivå — og den utskårne strengen inneholdt de attributtene, men ikke deklarasjonene xmlns:loext og xmlns:calcext som bandt dem. De deklarasjonene lå på kildefilens <office:document-content>-rot, trettifem av dem, to tusen tegn unna pivoten
W3C Namespaces in XML 1.0 §6.1 definerer regelen som gjør dette til en hard feil og ikke en kosmetisk en: en navneromsdeklarasjon er i gyldighetsområde fra starttaggen til elementet den står på, til elementets sluttagg, og hvert prefiksnævn innenfor det området løses mot den. Skjær et deltre ut av dokumentet, og du skjærer det ut av gyldighetsområdet. HotXLS skriver sin egen <office:document-content>-rot med elleve deklarasjoner — office, table, text, style, number, fo, draw, svg, xlink, calcext, tableooo — så calcext: tilfeldigvis løste seg, table: tilfeldigvis løste seg, og loext: gjorde det ikke. En navneromsbevisst parser behandler et ubundet prefiks som et brudd på velformethet, noe som betyr at hele delen er uleselig, ikke bare ett attributt
Hvordan får HotXLS med foreldrenes xmlns-bindinger på fragmentet?
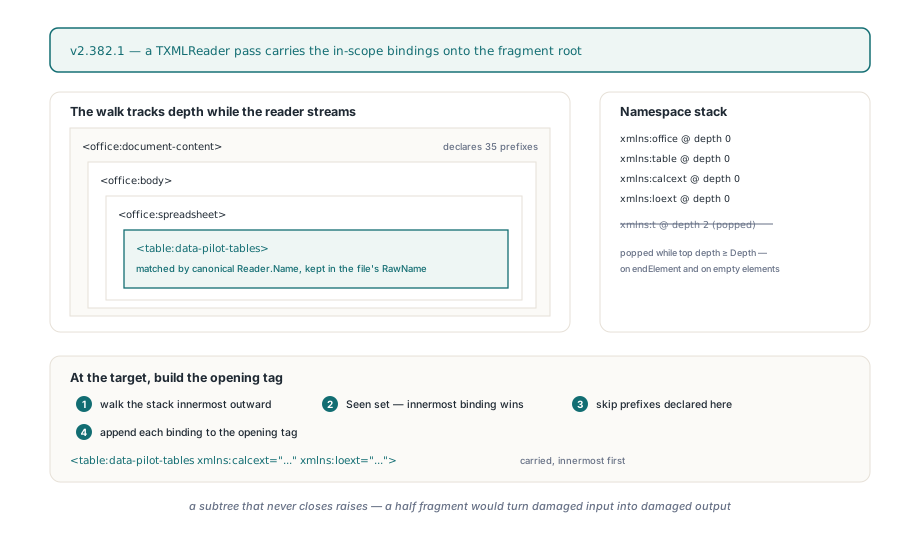
HotXLS v2.382.1 byttet ut strengutsnittet med en gjennomgang av content.xml gjennom sin egen strømmende TXMLReader, holder en stabel med navneromsbindinger merket med dybden der hver av dem ble deklarert, og kopierer bindingene som fortsatt gjelder, over på fragmentets rotelement i det øyeblikket målet nås. Leseren kjører med PreserveWhitespaceText slått på, slik at tekstnoder kommer tilbake nøyaktig som skrevet, og de gjenoppbygde taggene bruker TXMLReader.RawName og TXMLReader.Attribute[I].RawName — prefiksstavemåten fra filen — i stedet for de kanoniske navnene leseren normalt gir delparserne. Her er kjernen i løkken:
// Namespaces: TStringList med 'xmlns:p=uri' og deklareringsdybden i Objects[]
while Reader.Read do
begin
  if CaptureDepth >= 0 then
    XlsxAppendRawXmlReaderNode(Result, Reader);   // element, tekst, CDATA, kommentar
  if Reader.NodeType = xmlntElement then
  begin
    for I := 0 to Reader.AttributeCount - 1 do
    begin
      AttrName := Reader.Attribute[I].RawName;
      if (AttrName = 'xmlns') or (Pos(WideString('xmlns:'), AttrName) = 1) then
        Namespaces.AddObject(String(AttrName) + '=' + String(Reader.Attribute[I].Value),
          TObject(NativeInt(Depth)));
    end;
    if (CaptureDepth < 0) and (Reader.Name = 'table:data-pilot-tables') then
    begin
      Opening := XlsxRawXmlReaderOpenTag(Reader);   // fjern den avsluttende '>' eller '/>' først
      ...
      // Før de gyldige foreldrebindingene over på fragmentroten.
      for I := Namespaces.Count - 1 downto 0 do
      begin
        AttrName := WideString(Namespaces.Names[I]);
        if Seen.IndexOf(String(AttrName)) >= 0 then Continue;   // innerste binding vinner
        Seen.Add(String(AttrName));
        if not Reader.HasAttribute(AttrName) then               // allerede deklarert her? hopp over
          Opening := Opening + ' ' + AttrName + '="' +
            XlsxEscapeAttr(WideString(Namespaces.ValueFromIndex[I])) + '"';
      end;
      ...
      CaptureDepth := Depth;
    end;
    if not Reader.IsEmptyElement then Inc(Depth);
  end
  else if Reader.NodeType = xmlntEndElement then
  begin
    Dec(Depth);
    if Depth = CaptureDepth then Exit;                           // deltreet lukket
  end;
  if (Reader.NodeType = xmlntEndElement) or
     ((Reader.NodeType = xmlntElement) and Reader.IsEmptyElement) then
    while (Namespaces.Count > 0) and
          (NativeInt(Namespaces.Objects[Namespaces.Count - 1]) >= Depth) do
      Namespaces.Delete(Namespaces.Count - 1);                   // forlat området
end;
if CaptureDepth >= 0 then
  raise Exception.Create('OpenDocument pivot definition ended inside an element');
Tre detaljer i den løkken bærer korrektheten. Å gå gjennom stabelen fra den innerste bindingen og utover og huske hvert prefiks i Seen implementerer skyggelegging: hvis en nærmere forgjenger binder xmlns:table på nytt, vinner den nærmere verdien, nøyaktig slik §6.1 sier den skal. Å hoppe over prefikser elementet allerede deklarerer selv, unngår å skrive ut det samme attributtet to ganger, noe som ville være en annen velformethetsfeil. Og poppregelen utløses på sluttagger og på tomme elementer, fordi <x/> aldri gir en EndElement-hendelse — den samme selvlukkende fellen som XLSX-fangsten av extLst måtte lære seg. Å matche målet på Reader.Name og ikke RawName er en stillere gevinst: leseren kanoniserer ODF-tabellnavnerommets URI til prefikset table, så en produsent som staver det t:data-pilot-tables, matcher fortsatt, mens det utsendte fragmentet beholder hvilket prefiks produsenten enn brukte
Løkken nekter også å gjette. Hvis delen tar slutt mens fangsten fortsatt er åpen — en avkuttet eller ødelagt content.xml — kaster OdsCaptureDataPilotTablesXml unntak i stedet for å returnere et halvt fragment, fordi et halvt fragment ville bli skrevet tilbake ved lagring og gjøre et skadet inndata til et skadet utdata med bibliotekets navn på
Hvor havner fragmentet i den lagrede content.xml?
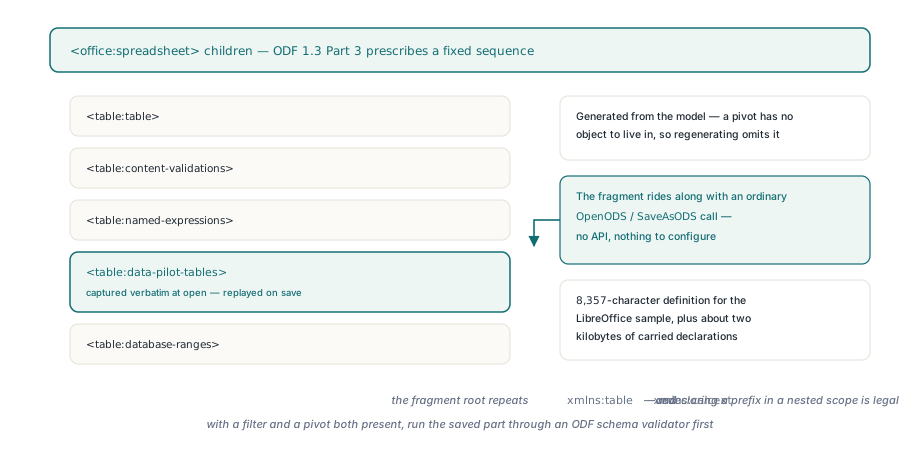
HotXLS skriver det fangede fragmentet inn i <office:spreadsheet> rett etter <table:named-expressions> som den genererer, og foran <table:database-ranges>. Innholdsmodellen for <office:spreadsheet> i ODF 1.3 Part 3 foreskriver en fast rekkefølge for disse avsluttende barna, så en ordrett blokk kan ikke bare legges til der skriveren tilfeldigvis befinner seg; den må slippes ned i en bestemt luke. Fra kallerens side finnes det ingen API og ingenting å konfigurere; definisjonen blir med på en helt vanlig åpning og lagring:
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS('official-pivot.ods') <> 1 then
      raise Exception.Create('open failed');
    Book.Sheets[0].Cells[2, 5].Value := 1250.0;   // rediger inne i pivotens kildeområde
    Book.SaveAsODS('official-pivot-out.ods');
    // content.xml i utdataene bærer fortsatt DataPilot1 med sitt
    // kildeområde, felt, målområde, knapper og loext:/calcext:-attributter
  finally
    Book.Free;
  end;
end;
Redundansen er med vilje og verdt å kjenne til. Fragmentroten gjentar nå xmlns:table og xmlns:calcext selv om det lagrede dokumentets rot også deklarerer dem; Namespaces in XML tillater å deklarere et prefiks på nytt i et nestet område, så duplikatene er harmløse. For LibreOffice-eksemplet er settet som følger med, alle trettifem rotdeklarasjonene, omtrent to kilobyte på toppen av den 8357 tegn lange definisjonen, fordi fangsten ikke analyserer hvilke prefikser deltreet faktisk bruker. En skanning over brukte prefikser ville trimme det, og den kommer kanskje senere; korrekthet først, kompakthet etterpå
En regel for å skjære deltrær ut av XML for ordrett avspilling
Den generelle lærdommen er at et deltre bare er selvstendig når du har gjort det selvstendig, og navneromsområdet er det første som brekker når du glemmer det. Sjekklisten HotXLS nå bruker på enhver fangst av typen «behold det vi ikke modellerer»:
- Gå gjennom dokumentet med en ekte leser og spor bindingene i gyldighetsområde. Strengsøk med
Poskan ikke se gyldighetsområde i det hele tatt, og det gir også feilmatch på nestede elementer med samme navn, på en matchende streng inne i en kommentar eller enCDATA-seksjon, og på attributtverdier som tilfeldigvis inneholder taggteksten - Kopier de gjeldende bindingene over på fragmentroten, innerst først, én gang per prefiks, og hopp over det roten allerede deklarerer
- Behold prefiksets rå stavemåte i de utsendte taggene; match målet på oppløst navnerom, ikke på bokstavelig prefiks
- Bevar tekstnoder med bare mellomrom, og husk at et tomt element lukker sitt eget område uten en sluttagg-hendelse
- Valider den lagrede delen med en parser som ikke er biblioteket du tester. Biblioteket leser gjerne sin egen utdata på nytt gjennom den samme ettergivende kodeveien som skrev den
Det siste punktet er det som faktisk fant HXLS-003 andre gang. Akseptansesjekken i v2.382.0 var et regulært uttrykk som telte data-pilot-table-starttagger i den lagrede content.xml, og et regulært uttrykk ser en tagg, ikke et dokument — det er blindt for om prefiksene på den taggen er bundet. Den strenge korpuskjøreren som ble lagt til i v2.382.1, parser hver XML- og .rels-del i den lagrede pakken med en navneromsbevisst parser og sammenligner deretter pivottreet — tagg, sorterte attributter, tekst, barn, rekursivt — mot originalen. Den sammenligningen er navneromsutvidet, så en annen stavemåte for et prefiks ville fortsatt gå gjennom, mens et ubundet prefiks ikke kan det
Hvor den ordrette garantien slutter
Ordrett avspilling bevarer en definisjon; den forstår den ikke, og grensene følger av det. HotXLS eksponerer ingen API for å lese, redigere eller oppdatere en ODS-pivot, så FRawOdsDataPilotTablesXml er et internt felt, og den eneste observerbare oppførselen er at definisjonen overlever. Fragmentet serialiseres på nytt fra leserhendelser og kopieres ikke som byte: attributtsitering og selvlukkende former normaliseres, mens tekst og mellomrom beholdes. Den fangede XML-en sendes bare ut av innholdsskriveren for ODS, så en arbeidsbok åpnet fra .ods og lagret som .xlsx mister pivoten, og en arbeidsbok åpnet fra .xlsx har ingenting å spille av inn i en .ods-lagring — asymmetriene i import- og eksportveiene for ODS gjelder her som overalt ellers. Og fordi definisjonen er ugjennomsiktig, kan den ikke følge redigeringene dine: døp om Sheet1 eller flytt kildedataene i HotXLS, og den lagrede pivoten peker fortsatt på Sheet1.A2:E30, slik at konsumenten får rapportert et ødelagt område neste gang den oppdateres. Et forbehold om rekkefølge hører også med her: HotXLS sender ut AutoFilter-områder som <table:database-ranges> etter pivotfragmentet, og korpuseksemplet inneholder ingen databaserekkevidde, så en arbeidsbok med både et filter og en pivot bør kjøres gjennom en ODF-skjemavalidator før du stoler på den innbyrdes rekkefølgen mellom de to elementene
Test med filer fra din egen produsent, ikke bare korpuseksemplet. Overføringen av navnerom håndterer ethvert prefiks en produsent deklarerer på en forgjenger, men et dokument som deklarerer et prefiks på pivotelementet selv, eller som bruker et standardnavnerom for tabellordforrådet, utøver grenene for hopp over og skyggelegging som LibreOffice-eksemplet ikke gjør. Begge er implementert; ingen av dem har et eksempel i korpuset ennå, og den forskjellen er nøyaktig den typen ting en changelog-oppføring har en tendens til å viske ut
Den ordrette datapilot-fangsten i v2.382.0 og rettelsen av navneromsområdet i v2.382.1 leveres i gjeldende HotXLS Delphi Excel Component, der produktsiden lister opp full lese- og skrivestøtte for ODS, XLSX og XLS for Delphi og C++Builder