Når en PDF ikke baker inn en font, renderer HotPDF-komponenten den teksten med en installert Windows-font valgt av HPDFMapBaseFontToSystem: den dekoder /BaseFont-navnet, stripper stildelen, prøver flere stavemåter til GDI bekrefter at familien er installert, måler manglende standard 14-bredder fra metrikkompatible fonter og konverterer enbytekoder til Unicode før tegning. Hvert av disse trinnene finnes fordi den naive versjonen feilet på ekte filer. RenderLoadedPageToBitmap-siderendereren håndterer innbakte programmer godt; dette er historien om fontene som ikke er i filen i det hele tatt
Hvorfor tegner GDI i stillhet feil skriftsnitt for en ikke-innbakt font?
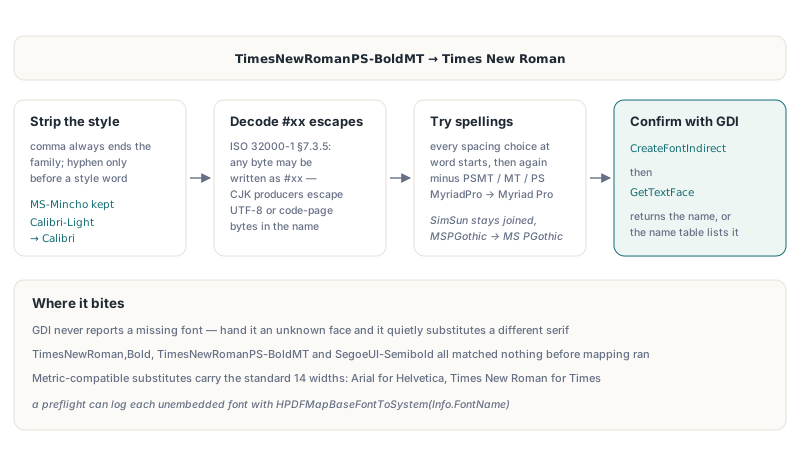
GDI rapporterer aldri en manglende font: gi CreateFontIndirect et snittnavn den ikke kjenner, og den velger stille en erstatning, ofte en annen serif uten fet vekt. Den tidlige rendereren sendte PDF-navnet nesten ordrett, så TimesNewRoman,Bold, TimesNewRomanPS-BoldMT og SegoeUI-Semibold matchet ingenting og kom ut i hva GDI enn valgte. Navn kan være verre enn det. ISO 32000-1 §7.3.5 lar et navn skrive enhver byte som #xx, og CJK-produsenter staver rutinemessig fontnavn som escapet UTF-8 eller legacy kodepage-byte; før v2.766.69 ble selve escapene snittnavnet. HPDFMapBaseFontToSystem dekoder nå escapene først, returnerer en gyldig UTF-8 bytesekvens som sine tegn og leser andre høye byte i systemets kodepage
Å kutte stilen av er der heuristikken biter. Et komma avslutter alltid familien (Arial,Bold gir Arial), men en bindestrek gjør det bare når ordet etter den er en stil: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra eller Condensed. Den regelen holder MS-Mincho hel mens den gjør Calibri-Light om til Calibri. HotPDF prøver så stavemåter av familien, fulgt av stavemåter av familien med et PSMT-, MT- eller PS-suffiks fjernet. Siden v2.768.18 dekker disse stavemåtene hvert valg av mellomrom på stedene et ord kan starte: før en stor bokstav som følger en liten (MyriadPro blir Myriad Pro), ved den siste store bokstaven i et løp som en liten bokstav følger (UIGothic), og etter en ledende MS (MSPGothic), fra den fullt mellomromsatte formen ned til navnet slik det er skrevet; forbi fire slike steder prøves bare den fullt mellomromsatte og det sammensatte navnet. Mellomrom kan ikke anvendes blindt, for Windows beholder noen ord sammensatt: SimSun er installert under nøyaktig den stavemåten, mens MicrosoftYaHei, MicrosoftJhengHei og MSPGothic hører til Microsoft YaHei, Microsoft JhengHei og MS PGothic. Før v2.768.18 satte mapperen et mellomrom foran hver indre stor bokstav, så MicrosoftYaHei ble slått opp som Microsoft Ya Hei og aldri funnet. En kandidat teller som installert når CreateFontIndirect fulgt av GetTextFace returnerer navnet som ble bedt om, eller, siden v2.768.18, når den valgte fontens name-tabell lister det som en familie, fullt eller typografisk familienavn på ethvert språk; svaret caches per navn, så dokumenter med mange fonter som ikke er installert, sonderer ikke lenger Windows for hvert navn på hver side
Fordi mapperingsfunksjonen er offentlig i HPDFRenderFontMetrics-uniten, kan en preflight-rapport vise hvilken installert familie hver ikke-innbakt font vil rendere med, ved å bruke fontopptellingen THotPDF allerede eksponerer for lastede dokumenter:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Hvordan måler HotPDF standard 14-fontene som ikke har /Widths?
HotPDF måler de manglende avstandene på den installerte fonten med de samme metrikkene, for ISO 32000-1 §9.6.2.2 lar standard 14-fontene utelate /Widths og biblioteket sender ikke med AFM-tabeller. Arial bærer Helvetica-metrikk, Times New Roman bærer Times og Courier New bærer Courier, så HPDFMeasureBaseFontWidths oppretter det matchende snittet ved lfHeight = -1000 og kaller GetCharWidth32W; ved den høyden er resultatet allerede i de 1/1000 em-enhetene PDF-bredder bruker. Rendereren gjør først hver kode om til Unicode gjennom /Encoding, /BaseEncoding og /Differences, med StandardEncoding som standard. SVG-eksport og tekstekstraksjon traff én felle til: en standard Type 1-font uten /Encoding i det hele tatt produserte en dekoder uten encodingsinformasjon, SVG-eksporten registrerte den aldri, og hver målte bredde forble ubrukt. Å levere den underforståtte StandardEncoding-en fikset det, forutsatt at den er merket som en forhåndsdefinert encoding; å sende den ned CMap-navn-stien dekoder hver kode som 0 og hver bredde følger etter
Fet, kursiv og en off-by-one i fontdeskriptorens flagg
/Flags-oppføringen i en fontdeskriptor nummererer bitene fra 1, ikke 0, så ForceBold er bit 19 ($40000) og Italic er bit 7 ($40), per ISO 32000-1 tabell 123. Den gamle koden testet $20000, som er bit 18, SmallCap. Feilen overlevde fra v2.345.0 til v2.766.53 fordi /FontDescriptor nesten alltid er en indirekte referanse og fontbyggeren bare leste direkte objekter, så hele flagggrenen kjørte aldri, og samme blindhet ignorerte /Widths 12 0 R og la tekst ut med en 500-enheters fallback-avstand. Da v2.766.53 begynte å løse indirekte referanser gjennom rendereren, måtte biten korrigeres i samme endring, ellers ville hvert small-caps-snitt plutselig ha rendert fett:
const
  // ISO 32000-1 tabell 123 teller bitposisjoner fra 1
  FD_ITALIC     = $00040;  // bit 7
  FD_SMALLCAP   = $20000;  // bit 18, ikke en vekt
  FD_FORCEBOLD  = $40000;  // bit 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;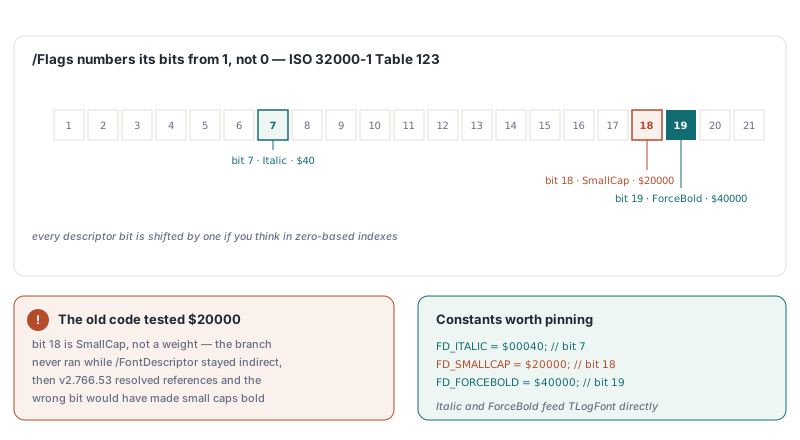
Hvorfor får CJK-fonter med en UCS2 CMap feil bredder?
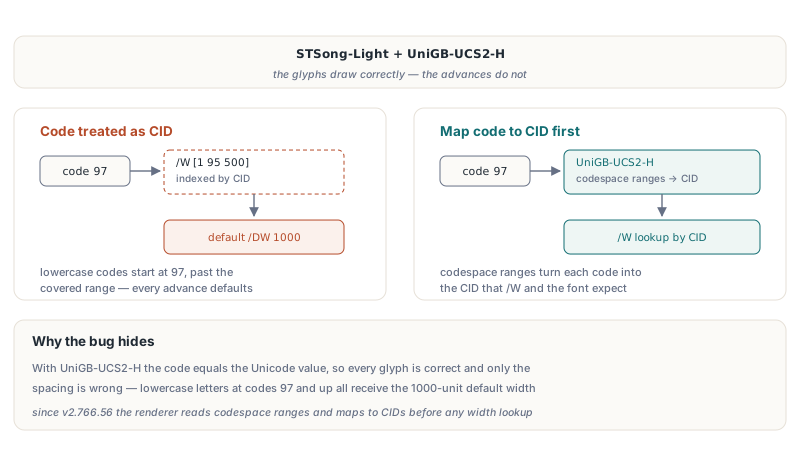
CJK-tekst med en forhåndsdefinert UCS2 CMap tegner riktige glyfer men feil avstand når en renderer behandler koden som CID-en, for /W er indeksert etter CID, ikke etter tegnkode. Med STSong-Light og UniGB-UCS2-H er koden tilfeldigvis lik Unicode-verdien, så GDI tegner de riktige tegnene og bug-en gjemmer seg i avstandene: små bokstaver ankommer som koder 97 og oppover, faller utenfor en /W-oppføring som [1 95 500] og får alle standardbredden /DW på 1000. Siden v2.766.56 leser HotPDF-rendereren koder gjennom CMapens codespace-områder (ISO 32000-1 §9.7.6.2) og mapper dem til CID-er før breddeslag opp. Bare de innebygde UCS2- og UTF16-tabellene og innbakte CMap-streams brukes; en identitets-approksimasjon for noe som GBK-EUC-H ville bare sett ut som støttet mens den produserte feil output, så rendereren later som ingenting
Hvorfor blir aksenttegn til spørsmålstegn på kinesisk Windows?
Enbytekoder må aldri nå ANSI- («A»-) GDI-funksjonene, for GetGlyphOutlineA og GetGlyphIndicesA tolker byte i systemets kodepage mens TextOutA bruker den valgte fontens tegnsett. På et kinesisk system ble Arial-byte $A9 (opphavsrettstegnet i Windows-1252) en GBK-ledende byte og rendret som «?», en felle stien for unhintede omriss lagt til i v2.766.83 gikk rett i. v2.767.3 spør realiseringsfonten om sitt tegnsett med GetTextCharset, konverterer det til en kodepage gjennom TranslateCharsetInfo, sender byten gjennom MultiByteToWideChar og kaller W-funksjonene; symbolfonter bruker U+F000 pluss koden i stedet. Encodings som strider mot Windows-1252 — /Differences, StandardEncoding, MacRomanEncoding — mappes til Unicode før noe systemfont ser dem
Hva er grensene for å tegne med systemfonter?
Systemfont-rendering er en approksimasjon, og HotPDF-komponenten er ærlig på hvor den stopper. Før v2.768.18 sammenlignet installasjonssjekken bare navnet GetTextFace returnerer, og på lokalisert Windows rapporterer den funksjonen familienavnet på systemets språk, så Microsoft YaHei på kinesisk Windows eller Yu Mincho på japansk Windows ble dømt manglende og tegnet med en GDI-erstatning; siden v2.768.18 slås også et snitt som kommer tilbake under et annet navn opp i fontens name-tabell, og slike fonter finnes. Metrikkkompatibilitet er garantert bare for Helvetica-, Times- og Courier-familiene; Symbol mappes til Symbol og ZapfDingbats til Wingdings, noe som er en nødløsning i stedet for et treff. Preflight-en over ser også bare fonter i hver sides /Resources-ordbok, ikke de referert inni form XObjects. Når en kode fortsatt ikke kan tegnes, rapporterer sporingen av uløste glyfer ved tegning det, noe som er et bedre signal enn å anse miniatyrbilder
Den varige fiksen sitter på forfattersiden. HotPDF selv skriver med FontEmbedding satt til True som standard, og erstatter med en innbakt Arial selv når koden kaller SetFont med Helvetica, og innbakt tekst går gjennom den innbakte font-glyf-rendereren i stedet for noe av gjetningen over. En billig vakt for innkommende filer er å advare før rendering når en mappet familie ikke er i skjermfontlisten:
// VCL: Screen.Fonts lister installerte familienavn (Forms-uniten)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
For hele komponenten, inkludert siderendering, tekstekstraksjon og font-subsetting på skrivesiden, se HotPDF Delphi PDF-komponentens produktside