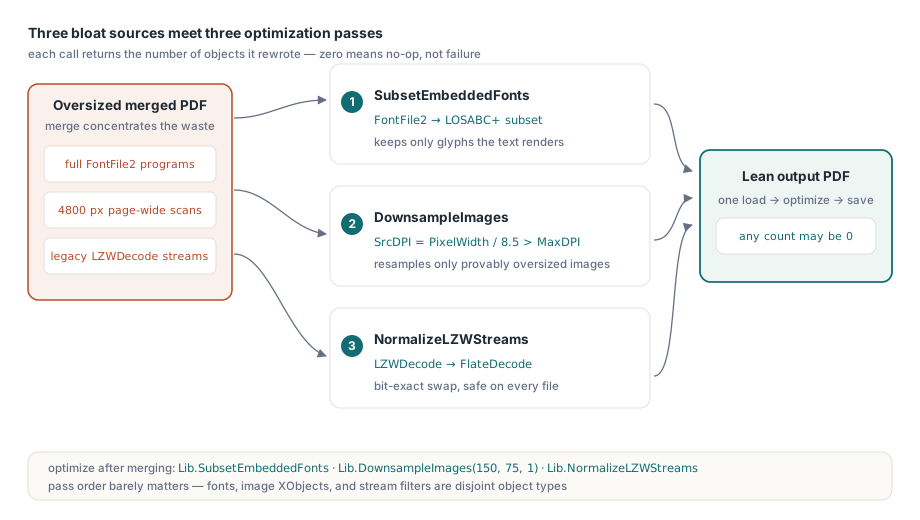
For å redusere PDF-filstørrelsen i Delphi tilbyr losLab PDF Library tre API-er som angriper de tre største kildene til oppblåsthet: SubsetEmbeddedFonts skriver om hvert innebygde TrueType-skriftprogram ned til de glyfene dokumentet faktisk gjengir, DownsampleImages resampler rasterbilder som overstiger en mål-DPI, og NormalizeLZWStreams erstatter gammel LZWDecode-komprimering med FlateDecode. Hver av dem returnerer antallet objekter den endret, så et nulltall forteller deg at gjennomgangen ikke gjorde noe, ikke at den feilet i stillhet
Hvorfor er den sammenslåtte PDF-en min større enn kildefilene?
En sammenslått eller programmatisk generert PDF er som regel for stor av én av tre grunner: fullt innebygde skrifter, bilder samplet langt over sin visningsoppløsning, og strømmer som fortsatt er komprimert med det gamle LZW-filteret. ISO 32000-1 §9.9 lar en produsent bygge inn hele skriftprogrammet, og de fleste produsenter gjør nettopp det fordi det er den trygge standardinnstillingen. Et komplett Arial-FontFile2 kommer opp i hundrevis av kilobyte; bygg det inn i et dusin kildefiler, slå dem sammen, og du bærer et dusin kopier av glyfomriss for tegn ingen har skrevet. Sammenslåingen skaper ikke sløsingen i seg selv, den bare samler den i én fil der totalen endelig blir synlig
Bilder er den andre synderen. En skanning på 4800 piksler i bredden plassert i en ramme på en kvart side frakter omtrent 40 ganger mer pikseldata enn en trykkløype på 300 DPI kan bruke. Den tredje er mer stillfaren: strømmer filtrert med LZWDecode. ISO 32000-1 §7.4.4 spesifiserer både LZWDecode og FlateDecode, og bemerker at Flate vanligvis komprimerer minst like godt; i praksis er Flate-utdata konsekvent mindre på de samme dataene, og LZW overlever stort sett i filer som en gang gikk gjennom verktøy fra 1990-tallet. Resten av denne artikkelen går gjennom de tre gjennomgangene i losLab PDF Library som løser hvert av problemene, og setter dem så sammen til én løype
Delmengder av skrifter med SubsetEmbeddedFonts
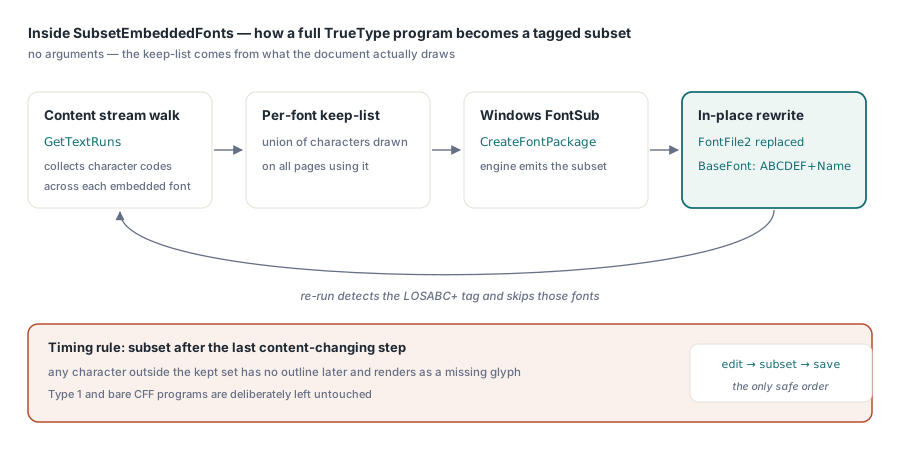
SubsetEmbeddedFonts krymper hver innebygde TrueType-skrift i et innlastet dokument til de tegnene dokumentet faktisk bruker, og den trenger ingen argumenter fordi den utleder beholdningslisten fra selve innholdsstrømmene. Innvendig går gjennomgangen gjennom innholdsstrømmen på hver side med GetTextRuns, samler tegnkodene det refereres til under hver skriftressurs, bygger en beholdningsliste og gir det opprinnelige skriftprogrammet videre til Windows-motoren FontSub (CreateFontPackage) for å lage en delmengde. Det omskrevne programmet erstatter FontFile2-strømmen på stedet, og BaseFont-navnet får en LOSABC+-merkelapp, konvensjonen med seks store bokstaver pluss et plusstegn som ISO 32000-1 §9.6.4 definerer for delmengdeskrifter. Det prefikset er også det som gjør kallet idempotent: kjør gjennomgangen to ganger, og skrifter som allerede er redusert til delmengder blir gjenkjent og hoppet over, så det er trygt å koble den inn i en satsvis jobb som kan komme innom de samme filene flere ganger
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = antall FontFile2-programmer som ble skrevet om;
      // 0 betyr ingenting innebygd, eller alt er allerede delmengder
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
To implementasjonsdetaljer er verdt å kjenne fordi de forklarer grensene til API-et. For det første retter gjennomgangen seg mot FontFile2, så den dekker innebygde TrueType-programmer; skrifter innebygd som Type 1 eller rå CFF blir latt i fred i stedet for å bli utsatt for risiko. For det andre hviler den på FontSub, noe som gjør at SubsetEmbeddedFonts bare virker på Windows. Et mer subtilt poeng fra implementasjonen: om en skrift kvalifiserer, avgjøres ved faktisk å følge referansekjeden FontDescriptor → FontFile2, ikke ved å stole på en heuristikk basert på et innebygd-flagg, fordi skrifter i et innlastet dokument aldri gikk gjennom bokføringen på opprettelsessiden som setter slike flagg. Finnes den oppløste strømmen, er skriften en kandidat; hvis ikke, hoppes den over uten feil
Den ærlige avveiningen: en delmengdeskrift inneholder bare de glyfene som fantes da delmengden ble laget. Hvis et verktøy lenger ned i kjeden, eller din egen kode, senere legger til tekst i den samme skriften, har ethvert tegn utenfor delmengden ingen omriss og vil gjengis som en manglende glyf. Lag delmengder som det siste innholdsendrende trinnet, aldri før en redigeringsfase. Den samme forsiktigheten gjelder hvis du planlegger å hente skriften ut igjen for gjenbruk senere; artikkelen om uttrekk av tekst, bilder og skrifter med PDF Library for Delphi dekker hva et uttrukket delmengdeprogram kan og ikke kan gi deg
Hvordan avgjør DownsampleImages hvilke bilder som skal krympes?
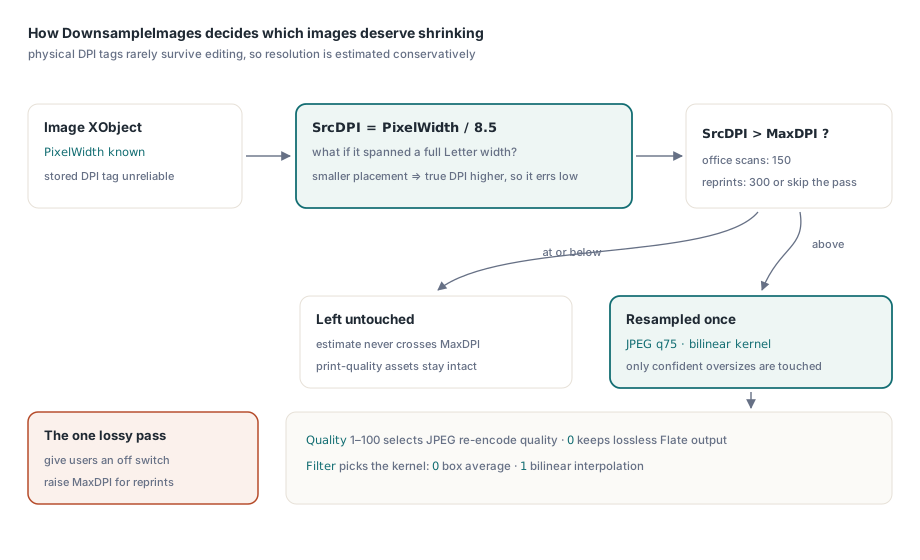
DownsampleImages(MaxDPI, Quality, Filter) resampler bare de bildene den trygt kan kalle oversamplet, ved hjelp av et bevisst forsiktig DPI-anslag. Et PDF-bilde-XObject lagrer pikseldimensjoner, men ingen pålitelig fysisk oppløsning, og en eventuell DPI-merkelapp fra kildebildet overlever sjelden en syklus med innlasting, redigering og lagring. Derfor anslår gjennomgangen SrcDPI = PixelWidth / 8.5, og spør i praksis: hvis dette bildet dekket hele bredden av en Letter-side, hvilken oppløsning ville det da hatt? Bare bilder der anslaget overstiger MaxDPI blir rørt. Skjevheten er tilsiktet: et bilde som er plassert lite på siden har en høyere reell DPI enn anslaget, så gjennomgangen utløses heller for sjelden enn å forringe en trykkferdig ressurs den ikke kan måle
Quality fra 1 til 100 velger kvaliteten på JPEG-omkodingen, mens 0 beholder utdataene som tapsfri Flate i PNG-stil; Filter velger resamplingskjernen, 0 for boksgjennomsnitt og 1 for bilineær. For skannet kontorpapir er DownsampleImages(150, 75, 1) et fornuftig utgangspunkt; for alt som kan bli skrevet ut på nytt, hev MaxDPI til 300 eller hopp over gjennomgangen helt. Nedskalering er det ene tapsgivende trinnet av de tre, så det hører hjemme bak en innstilling brukerne dine kan slå av
Konvertere gamle LZW-strømmer med NormalizeLZWStreams
NormalizeLZWStreams er den gratis gevinsten: den dekomprimerer hver LZWDecode-strøm tapsfritt og komprimerer den på nytt med FlateDecode, på stedet, og returnerer antallet strømmer som ble konvertert. Den håndterer både en enkelt /Filter /LZWDecode-oppføring og LZW som opptrer inne i en filterkjede-array, der bare LZW-leddet erstattes og resten av kjeden bevares. Prediktorparametrene (Predictor, Columns, Colors, BitsPerComponent) leses fra strømmens DecodeParms og sendes videre til dekomprimereren, slik at prediktorkodede bildedata kommer riktig gjennom rundturen. Fordi begge filtrene er bit-eksakte kodeker, er de dekodede bytene identiske før og etter; bare beholderkomprimeringen endres, og det er derfor denne gjennomgangen er trygg å kjøre uten forbehold på hver eneste fil
På et dokument uten LZW-strømmer returnerer kallet ganske enkelt 0 og rører ingenting, noe bibliotekets regresjonssuite tester eksplisitt: en nyopprettet fil med bare Flate må rapportere null konverteringer. Den garantien om at ingenting endres, betyr noe når gjennomgangen sitter i en løype som behandler tusenvis av ulike filer, noen fra 2024 og noen fra 1998
Den komplette løypa for størrelsesoptimalisering i Delphi
De tre gjennomgangene kombineres til én funksjon som laster inn, optimaliserer og lagrer, og rekkefølgen betyr mindre enn du kanskje tror, fordi de arbeider på hver sine objekttyper: skrifter, bilde-XObject-er og strømfiltre. Å kjøre delmengdeuttrekket først er likevel det ryddige valget, siden det er den gjennomgangen som har en føring på redigeringsrekkefølgen
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> delmengde
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, bilineær
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Logg Fonts/Images/Streams: tre nuller betyr at filen alt var slank
  finally
    Lib.Free;
  end;
end;
Verifiser løypa slik biblioteket verifiserer seg selv: med en rundtur. Regresjonstestene i v3.130 oppretter et dokument, lagrer det, laster det inn på nytt, kjører optimaliseringen, lagrer igjen, og fastslår så tre ting: utdataene er mindre, de returnerte tallene stemmer med forventningene, og en ny innlasting av den optimaliserte filen lar seg fortsatt tolke og gjengi. Å gjenskape den løkka med opprett, optimaliser og last inn på nytt mot et utvalg av dine egne produksjonsfiler, og sammenligne uttrukket tekst før og etter, er en times investering som fanger integrasjonsfeil lenge før en kunde åpner en ødelagt faktura
// Rundturssjekk: den optimaliserte filen må fortsatt lastes inn rent
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Hvor passer løypa inn i en sammenslåingsarbeidsflyt? Etter sammenslåingen, ikke under den. Å slå sammen først og optimalisere det ene resultatet betyr at hver innebygde skrift får delmengden sin laget én gang mot unionen av alle brukte tegn, i stedet for én gang per kildefil. Er sammenslåingskapasiteten flaskehalsen, tilbyr PDF Library for Delphi en rask sti på bytenivå som unngår full objekttolking, beskrevet i artikkelen om rask PDF-sammenslåing med forskyvning av bytereferanser; og for inndata som er for store til å holdes helt i minnet dekker sammenslåing og deling av store PDF-er med direkte tilgang den strømmende ruten. Begge passer naturlig sammen med en avsluttende optimaliseringsgjennomgang på det sammenslåtte resultatet
Hva de tre gjennomgangene ikke gjør
Optimaliseringstrioen i losLab PDF Library utelater bevisst alt som endrer dokumentets semantikk. SubsetEmbeddedFonts slår ikke sammen duplikate skrifter på tvers av sammenslåtte kilder til ett program, den krymper hver av dem for seg; deduplisering er en annen og mer risikabel transformasjon. DownsampleImages går forbi et bilde der det forsiktige DPI-anslaget holder seg under terskelen, selv når et menneske ser at det er altfor stort for rammen sin. Og ingen av gjennomgangene rører dokumentstrukturen, så en fil som er oppblåst av tusenvis av foreldreløse objekter trenger en lagring av omskrivingstypen i stedet for disse gjennomgangene på strømnivå. Innenfor de grensene fjerner kombinasjonen av delmengdeskrifter, nedskalering av bilder og normalisering fra LZW til Flate de tre klassiske kildene til PDF-oppblåsthet med ett forutsigbart API-kall hver. De tre funksjonene følger med losLab PDF Library for Delphi, C# og VB.NET, ved siden av API-ene for sammenslåing, uttrekk og gjengivelse som er omtalt over