PDF Library for Delphi skriver sideetikettområder med AddPageLabels, og siden v3.539.10 virker det kallet også på lastede filer hvis /PageLabels-nummertre er splittet i /Kids-noder: roten flattes ut til ett enkelt /Nums-blad før det nye området går inn, så etiketten faktisk dukker opp i visningsprogrammet i stedet for å bli stille ignorert. Det typiske offeret er en bokaktig PDF fra et layoutverktøy, med romertall i innledningsdelene, arabiske numre i hoveddelen og et appendiks merket A-1, A-2, der du bare ville ommarke appendikset og ingenting endret seg
Hva er PDF-sideetiketter, og hvordan lagres de?
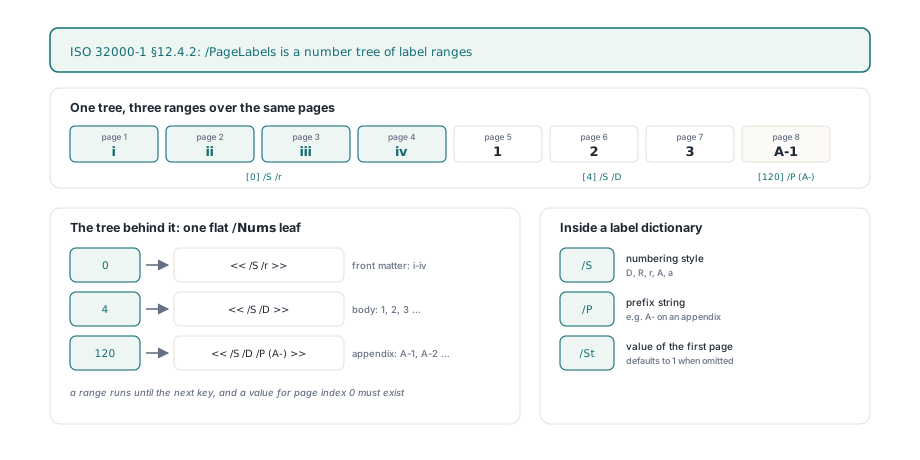
Sideetiketter er strengene et visningsprogram viser i sideboksen sin i stedet for den fysiske sideindeksen, og ISO 32000-1 §12.4.2 lagrer dem som et nummertre under katalognøkkelen /PageLabels. Hver nøkkel er en nullbasert sideindeks som starter et etikettområde, og hver verdi er en sideetikettordbok med opptil tre oppføringer: /S for nummereringsstilen (D, R, r, A eller a), /P for en prefiksstreng og /St for den numeriske verdien til første side i området, som har standardverdi 1. Et område løper til neste nøkkel, og spesifikasjonen krever at treet inneholder en verdi for sideindeks 0, så hver side dekkes av et eller annet område
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Sidene 1-4: i, ii, iii, iv (små romertall)
    Lib.AddPageLabels(1, 3, 1, '');
    // Sidene 5-120: 1, 2, 3 ... (desimal)
    Lib.AddPageLabels(5, 1, 1, '');
    // Sidene 121 og frem: A-1, A-2 ... (desimal med prefiks)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) mapper argumentene sine inn på den ordboken uten overraskelser når du kjenner tre regler. Start er 1-basert som alle andre sideargumenter i biblioteket og skrives inn i treet som Start - 1. Style går fra 0 til 5, der 0 betyr bare prefiks og 1 til 5 blir /S-verdier D, R, r, A og a; alt utenfor det området returnerer 0 og rører ingenting. Offset blir /St bare når den er større enn null, så å sende 0 utelater ganske enkelt nøkkelen, og visningsprogrammet faller tilbake til standardverdien 1. Fordi sideetiketter kom i PDF 1.3, kjører kallet også EnsureMinVersion('1.3', '/PageLabels'), som hever utgaveversjonen til en eldre fil med mindre du eksplisitt har låst lagringsversjonen
Hvorfor forsvinner nye sideetiketter når treet har /Kids?
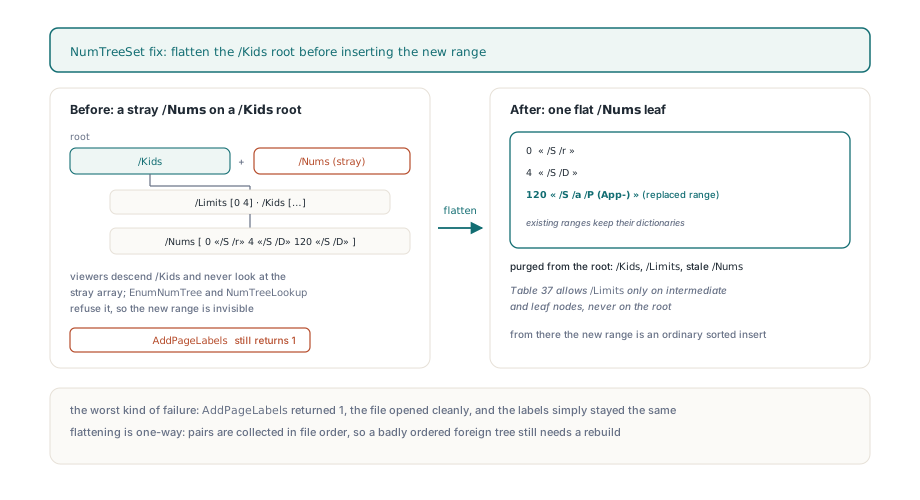
Nye etiketter forsvinner fordi ISO 32000-1 §7.9.7 (tabell 37) gjør at roten av et nummertre bærer enten /Kids eller /Nums, aldri begge, og den tidligere hjelperen NumTreeSet bare visste hvordan man ser etter /Nums. Produsenter som sender ut lange dokumenter, splitter ofte treet i mellomliggende noder, hver med et /Limits-par, og henger dem opp under en rot som bare har /Kids. Den gamle koden fant ingen /Nums på den roten, opprettet et ferskt ved siden av eksisterende /Kids og satte inn det nye området der. Resultatet var en rot med to gjensidig utelukkende inngangspunkter. Visningsprogrammer går nedover gjennom /Kids og ser aldri på den løse arrayen, bibliotekets egen EnumNumTree sjekker også /Kids først, og NumTreeLookup nekter en node der HasKids xor HasNums er usann. AddPageLabels returnerte fortsatt 1, og den lagrede filen åpnet seg fortsatt rent, som er den verste typen feil: ingenting klager, etikettene forblir bare de samme
Fiksen i NumTreeSet konverterer roten til et blad før noe settes inn. Når roten bærer /Kids, går EnumNumTree gjennom hvert blad i rekkefølge og samler hvert nøkkel- og verdipar, en ny flat /Nums-array bygges fra den listen, og /Kids, /Limits og eventuell foreldet /Nums renset ut fra roten før den flate arrayen festes. Å droppe /Limits er ikke kosmetikk, siden tabell 37 tillater den oppføringen bare på mellomliggende og bladnoder, aldri på roten. Fra det punktet er innsettingen en ordinær sortert innsetting i én array, og eksisterende områder overlever med sine opprinnelige etikettordbøker. Avveiningen er bevisst: treet bygges ikke om til balanserte /Kids-noder etterpå. For sideetiketter koster det ingenting, for selv en stor referansehåndbok har sjelden mer enn noen titalls områder, og et enkelt blad er det de fleste produsenter skriver uansett
// Ommarker appendikset i en fil hvis /PageLabels-rot bruker /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // f.eks. A-1
  // Erstatt området som begynner på side 121: App-a, App-b ...
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  // Eksisterende romerske og desimale områder er fortsatt i det utflatete bladet
  WriteLn('After: ', Lib.GetPageLabel(121));   // App-a
  WriteLn('Front: ', Lib.GetPageLabel(2));     // ii, uendret
end;
Hvordan kan en /Nums-array feiltolkes som nøkler?
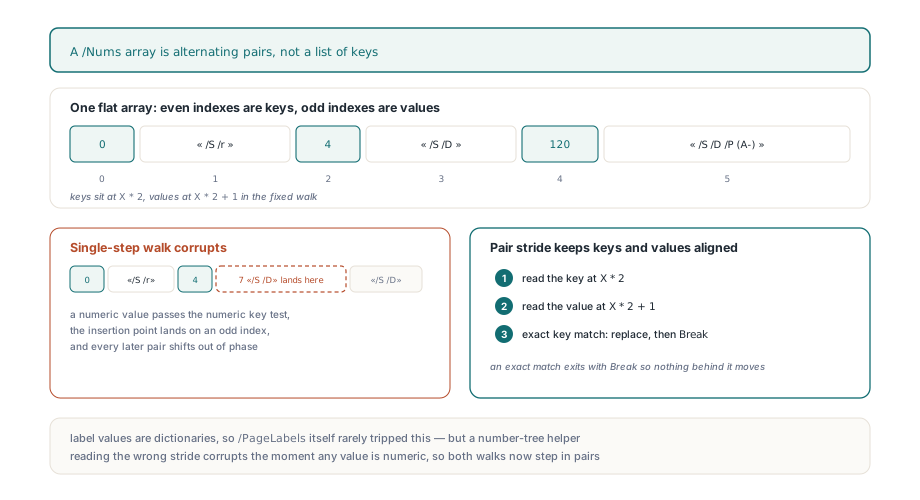
En /Nums-array feiltolkes når koden går gjennom den ett element om gangen, fordi arrayen er en flat rekke med alternerende par, [key0 value0 key1 value1 ...], og bare de jevn posisjonene er nøkler. Den gamle NumTreeSet-løkken testet hvert element for numerisk type, så en verdi som tilfeldigvis var et tall, ble sammenlignet som om den var en nøkkel; et mindre-enn-treff kunne sette innsettingspunktet til en oddetallsindeks og slippe det nye paret midt inn i et eksisterende, og flytte alle senere par ut av fase. EnumNumTree hadde samme enkeltsteg-gjennomgang. Begge itererer nå i par med en skrittlengde på to, leser nøkkelen ved X * 2 og verdien ved X * 2 + 1, og et eksakt nøkkeltreff erstatter verdien og avslutter med Break. For å være rettferdig, sideetikettverdier er ordbøker, så denne andre feilen sjelden utløste på /PageLabels selv, men en nummertre-hjelper som leser feil skrittlengde, er korrupt i det øyeblikket noen verdi er numerisk, og den ble fikset i samme omgang
Å lese etiketter tilbake og round-trippe dem
TPDFlib.GetPageLabel(Page) returnerer etiketten for en 1-basert side og har to fallbacker verdt å kjenne. Uten noen /PageLabels-oppføring i det hele tatt returnerer den det desimale sidetallet, så en kaller kan bruke den betingelsesløst. Med et tre til stede, men ingen områder som dekker siden, returnerer den en tom streng, som er nøyaktig det som skjer når en fil hopper over den obligatoriske indeks 0-oppføringen; referansedokumentasjonen sier at et område som begynner på side 1 må finnes for at etiketter skal vises riktig, og koden gjør det kravet synlig. Bokstavstiler følger spesifikasjonen snarere enn regnearkkolonner: etter Z kommer AA, så BB, som gjentar bokstaven i stedet for å bære over
var
  P: Integer;
  Data: WideString;
begin
  // Rask revisjon av hva et visningsprogram viser i sideboksen sin
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // Alternativverdi 4 eksporterer bare etikettområder som PageLabelBegin-poster
  Data := Lib.ExportDocumentData(4);
  // Import spiller dem av igjen gjennom ClearPageLabels + AddPageLabels
  Lib.ImportDocumentData(Data, 0);
end;
For bulkredigeringer skriver ExportDocumentData med alternativverdi 4 hvert område som en PageLabelBegin-blokk med PageLabelNewIndex-, PageLabelStart-, PageLabelPrefix- og PageLabelNumStyle-linjer, og ImportDocumentData behandler den første etikettposten den ser, som en full erstatning: den kaller ClearPageLabels én gang og mater deretter hver post til AddPageLabels. Det gjør en tekst-rundtur deterministisk selv når originalfilen brukte et /Kids-tre, fordi tømming fjerner hele katalogoppføringen og det gjenoppbygde treet er et enkelt blad fra starten
Hva garanterer fortsatt ikke fiksen?
Utflatningen er ensrettet og stoler på rekkefølgen den finner. EnumNumTree samler par i filrekkefølge, og GetPageLabel anvender det siste området hvis nøkkel er mindre enn eller lik sideindeksen, så en fremmed fil hvis blader er ute av rekkefølge, noe §7.9.7 forbyr men som sirkulerer, kan fortsatt gi feil etiketter til du bygger områdene på nytt med ClearPageLabels og ferske AddPageLabels-kall. Etiketter er også bundet til sideindekser, ikke sideobjekter, så enhver operasjon som endrer sideantall eller rekkefølge, lar områdene ligge der de var. Et stedseget bytte som å erstatte sider mens objektnumrene bevares, holder antallet og dermed etikettene på plass, mens en sammenslåing som sammenstokking av flettede dupleksskann produserer en ny siderekkefølge som fortjener et fersk skrevet sett med områder
Sideetikettkallene, nummertre-håndteringen og dokumentdata-eksporten og -importen beskrevet her, leveres alle i PDF Library for Delphi for Delphi, C++Builder og Lazarus, med referanseoppføringen for AddPageLabels som dokumenterer stilverdiene og returkodene