Een zoekopdracht naar "two-x" in een pas gegenereerde PDF kan nul treffers opleveren terwijl de pagina duidelijk die vijf tekens toont. Dump de geëxtraheerde string als codepunten en de reden staat er: het koppelteken kwam terug als U+00AD SOFT HYPHEN, en de spatie erachter als U+00A0 NO-BREAK SPACE. Op het scherm zien ze er identiek uit. Het verschil zit in de ToUnicode-CMap, de tabel die een reader raadpleegt om character codes terug naar Unicode te vertalen, en het komt door één fontglyph die door twee codepunten wordt gedeeld
Gewone stringhulpmiddelen maken de mismatch erger. Een CSV-export breekt de regel anders op, een diff-tool vlagt twee regels die in elke viewer hetzelfde lezen, en een spellingcontrole behandelt "two-x" met een soft hyphen als onbekend woord. Unicode-normalisatie redt u maar half: NFKC vouwt U+00A0 in een gewone spatie omdat NBSP een compatibiliteitsdecompositie heeft, maar U+00AD heeft helemaal geen decompositie, dus de soft hyphen overleeft elke normalisatievorm
Waarom komen geëxtraheerde spaties terug als U+00A0?
Geëxtraheerde spaties worden U+00A0 wanneer de ToUnicode-CMap op glyph is gesleuteld en één glyph vanaf twee codepunten bereikbaar is. In Arial dient glyph 3 zowel U+0020 als U+00A0, en de koppelteken-glyph dient zowel U+002D als U+00AD. Een CMap gebouwd vanaf de glyphkant moet iets zeggen over CID 0003, en de generator van PDFium in FPDFText_LoadFont zegt uiteindelijk twee dingen: een bfchar-invoer die hem naar U+0020 mapt, en een array-vorm bfrange die dezelfde CID naar U+00A0 mapt
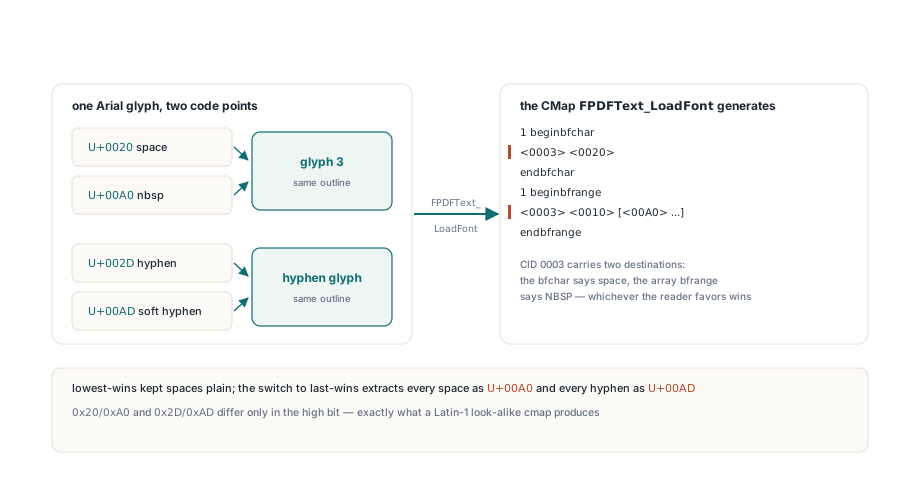
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3 beschrijft hoe bfchar en bfrange codes naar Unicode mappen, maar zegt niet welke invoer wint wanneer twee ervan dezelfde CID claimen. Readers kiezen een eigen precedentieregel. Een reader die de laagste of eerste mapping houdt extraheert een gewone spatie; de reader van PDFium houdt de laatste, en omdat de array-range na het bfchar-blok volgt, extraheert elke spatie die via een op glyph gesleutelde CMap is geschreven als NBSP en elk koppelteken als soft hyphen. Dezelfde tekst kan daardoor in twee viewers van hetzelfde bestand anders extraheren
De paren volgen een patroon. 0x20/0xA0 en 0x2D/0xAD verschillen alleen in de hoge bit, en dat produceert een font wanneer zijn cmap de Latijnse-1-lookalikes naar de omtrek stuurt die al voor het ASCII-teken in gebruik was. Ook Griekse hoofdletter Omega (U+03A9) en het Ohm-teken (U+2126) delen een glyph in Arial. Als extractiecode die eerst werkte nu faalt op tekens die u niet kunt zien, print dan de codepunten in plaats van de stringweergave van de debugger te vertrouwen; de basis van tekst uit een pagina lezen staat in tekst uit PDF-documenten extraheren met PDFium in Delphi
Hoe PDFium Component systeemfonts op codepunt sleutelt
PDFium Component vraagt de engine nooit om die CMap te genereren voor systeemfonts die een Unicode-cmap meedragen. Wanneer TPdf.AddText een font nodig heeft, leest de component de eigen sfnt-cmap-tabel van het font, bij voorkeur een subtable formaat 12 met terugval op formaat 4. Codepunten komen gesorteerd en ontdubbeld terug, en CID k+1 wordt aan het k-ste codepunt toegekend, met CID 0 als .notdef. Een expliciete CIDToGIDMap stuurt elke CID naar zijn glyph. U+0020 en U+00A0 krijgen zo twee verschillende CIDs die dezelfde omtrek tekenen, en de ToUnicode-CMap die de component schrijft mapt elke CID naar precies één codepunt
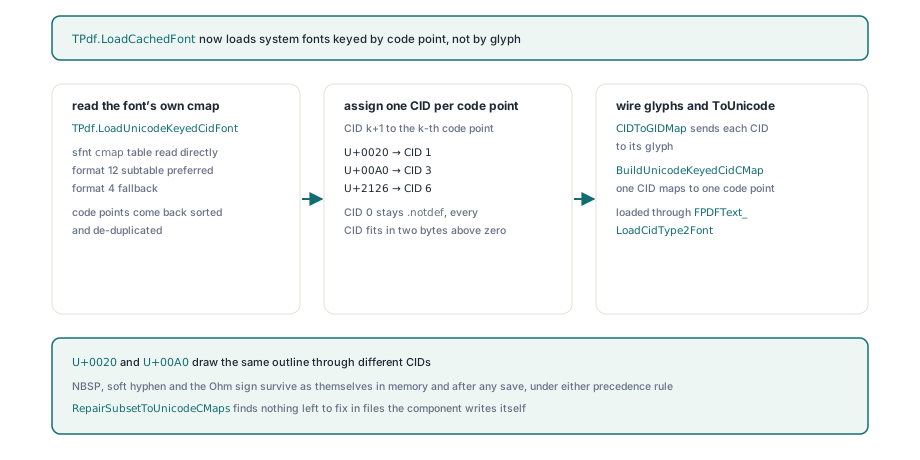
Het font wordt geladen via FPDFText_LoadCidType2Font, hetzelfde toegangspunt achter het schrijven op glyphniveau in CID Type 2-fonts insluiten met expliciete CID-naar-GID-maps. Wanneer FPDFText_SetText later een string schrijft, landt de omgekeerde opzoeking op één CID per teken. Niets daaraan hangt af van de precedentieregel van de reader, want er is geen tweede mapping om tussen te kiezen. Het opgeslagen bestand draagt ook de eigen ToUnicode-stream van de component, dus extractie na herladen ziet dezelfde een-op-een-tabel die het live document gebruikte
De prijs is een grotere CIDToGIDMap: twee bytes per codepunt dat het font dekt. Stel dat een font ongeveer 3.000 codepunten mapt. De map komt dan op ruwweg 6 KB, bij elke font aan de engine meegegeven. Die ruil is elke keer waard. Een paar kilobytes koopt extractie die hetzelfde leest in PDFium, in viewers die de eerste mapping houden, en in welke indexer uw klant volgend jaar ook draait
De rondtrip hieronder schrijft een string die elk lastelijk paar bevat, extraheert die uit het niet-opgeslagen document, slaat op, herlaadt en extraheert opnieuw. Beide strings moeten exact met de invoer overeenkomen; de helper CodePoints is er alleen om een mismatch leesbaar te maken:
uses
  SysUtils, PDFium;

const
  // Spatie/U+00A0 en koppelteken/U+00AD delen één Arial-glyph, net als
  // Griekse Omega (U+03A9) en het Ohm-teken (U+2126)
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // live, niet-opgeslagen document
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // na een volledige save en herlaad
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
Houd de NBSP en de soft hyphen in de voorbeeldstring, ook als uw documenten ze zelden bevatten. Een test die alleen ASCII schrijft slaagt ook tegen een op glyph gesleutelde CMap, want niets erin vraagt de reader ooit om tussen twee mappings te kiezen
Waarom kan één bfrange-invoer een heel blok uitwissen?
Een enkele bfrange waarvan de CID-run een xxFF-grens overschrijdt laat PDFium het hele blok waarin hij staat weggooien. ISO 32000-1 §9.10.3 laat binnen een range alleen de laatste byte van de bestemming variëren, en de CID-kant heeft een passende valkuil in de parser van PDFium: die leidt de hoge CID af als (low and $FFFFFF00) or (high and $FF). Een run van CID 00FE tot 0101 wordt gelezen als 00FE tot 0001, laag groter dan hoog, en het hele blok wordt als ongeldig gemarkeerd. SetText slaagt, de pagina rendert correct, en extractie geeft U+0000 terug voor elk teken in dat blok
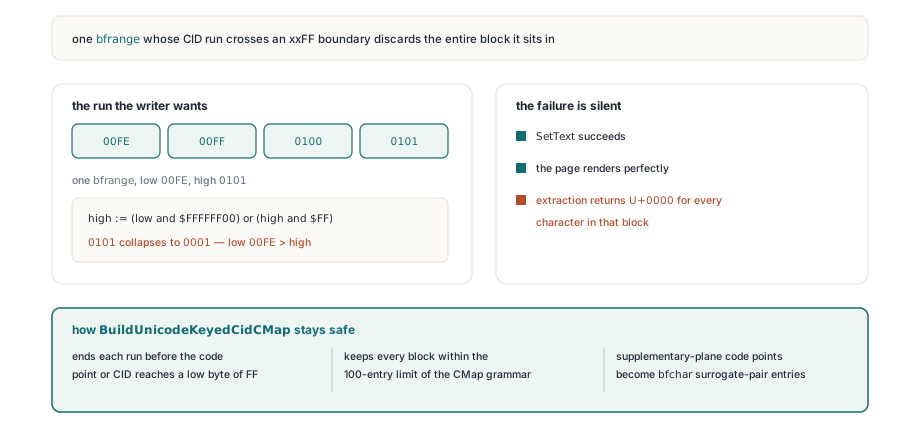
Een op codepunt gesleuteld font is precies waar dit bijt. CIDs zijn dicht en opeenvolgend, dus elk font met meer dan 255 codepunten levert CID-runs op die 00FF, 01FF enzovoorts zouden overschrijden als de schrijver opeenvolgende invoeren gewoon zou samenvoegen. De CMap die PDFium Component schrijft eindigt een run voordat het codepunt of de CID een lage byte van FF bereikt, en hij splitst de invoeren in blokken van ten hoogste 100, de limiet die de CMap-grammatica stelt aan elke sectie beginbfrange en beginbfchar
Codepunten boven U+FFFF krijgen individuele bfchar-invoeren waarvan de bestemmingen UTF-16-surrogaatparen zijn, want een surrogaatpaar binnen een range ophogen heeft geen gedefinieerde betekenis. Het surrogaatverhaal staat in emoji, CJK en surrogaatparen in Delphi. Een CMap met alleen bfchar zou het grensprobleem helemaal omzeilen, tegen een veelvoud van de grootte, en daarom blijven ranges de hoofdvorm en dragen de splitregels de last
ToUnicode-conflicten in bestanden van andere tools repareren
RepairSubsetToUnicodeCMaps in de unit FPdfCompress lost het op glyph gesleutelde conflict op in bestanden die de component niet zelf schreef. TPdf.SaveAs voert het uit bij elke volledige, niet-incrementele save, en u kunt het rechtstreeks op elke stream aanroepen. Voor elke CID die twee bestemmingen draagt wint de bfchar-invoer. Zonder bfchar voor de CID lost een paar dat alleen in de hoge bit verschilt op naar het kleinste base-Latin-codepunt. Elke ander conflict houdt zijn eerste mapping
De reparatie bewerkt de conflicterende hex-waarden op hun plek, met vervangingen van gelijke lengte. Bloklay-out, CID-dekking en elke andere byte van de stream blijven zoals ze waren, dus de CMap blijft in de vorm die de reader van PDFium al accepteerde. Een netjes herbouwde CMap zou er in een hexdump netter uitzien. Hij zou ook de structuur veranderen van een stream die een strenge reader al accepteerde, en dat is een gok zonder keer wanneer er maar een handjevol bestemmingswaarden fout zijn
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // Alleen bewerkingen van gelijke lengte; bestanden zonder repareerbaar conflict,
      // en cross-reference-stream- of object-stream-bestanden, worden gekopieerd zoals ze zijn
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
De routine herbouwt een klassieke cross-reference-tabel, dus documenten die cross-reference-streams, hybride referenties of object-streams gebruiken gaan byte voor byte door. Incrementele saves (saIncremental) slaan de reparatie met opzet over, omdat een incrementele revisie append-only moet blijven. Voor tekst die de component zelf schrijft doen beide gevallen er niet toe: zijn op codepunt gesleutelde fonts produceren nooit een conflict dat de reparatie zou vinden
Waar het op codepunt gesleutelde pad geldt
Het codepunt-gesleutelde pad dekt elk font dat een Unicode-cmap-subtable blootgeeft en valt voor de rest terug op het oude op glyph gesleutelde gedrag. De grenzen die goed om te kennen zijn voordat u erop vertrouwt:
- Symbolfonts die alleen een (3,0)-cmap meedragen, en elk font dat het CID-pad niet kan laden, gaan via
FPDFText_LoadFont, waar een glyph die door twee codepunten wordt gedeeld onderworpen is aan de precedentieregel van de reader - Met alleen een subtable formaat 4 dekt de map het Basic Multilingual Plane; een subtable formaat 12 op platform (3,10) of het Unicode-platform voegt codepunten uit het supplementaire vlak toe
- Glyph 0 en surrogaatcodepunten worden weggelaten, en het aantal invoeren is gekapt op 65535 zodat elke CID in twee bytes boven nul past
- TrueType Collections vragen extra zorg: GDI
GetFontDatageeft de hele .ttc terug, enFPDFText_LoadCidType2Fontheeft geen face-indexparameter, dus de collection erblind doorgeven zou face 0 insluiten, SimSun, terwijl u NSimSun uit simsun.ttc vroeg. De component matcht de familienaam tegen de name table van het font (nameID 1 en 16) en levert de gevraagde face aan als zelfstandige sfnt; een collection die hij niet kan parsen gaat heel door en gebruikt face 0 - Als er geen systeemfont van de gevraagde naam leesbaar is, geeft
AddTextde fontnaam door aanFPDFPageObj_NewTextObj, die hem opzoekt onder de standaardfonts van PDFium
Vouw onzichtbare tekens in de index samen, houd ze in de tekst
Zodra extractie de echte codepunten teruggeeft, komt een andere vraag op: wat moet een zoekindex doen met een echte NBSP of soft hyphen die de auteur met opzet typte? Vouw ze samen in de indexeringslaag en laat TPdf.Text met rust. De geëxtraheerde string is de registratie van wat het document zegt; een index is een verliesgevend beeld gebouwd om te matchen, en de samenvouwregels horen daar thuis
De helper hieronder is een functie die u aan uw eigen code toevoegt. Hij mapt NBSP naar een spatie en gooit de soft hyphen weg, die volgens de Unicode Standard alleen een plek markeert waar een regel mag breken. Hij laat U+2126 bewust onaangeroerd. NFC-normalisatie zou het Ohm-teken in Omega veranderen, omdat U+2126 een canonieke singleton-decompositie naar U+03A9 heeft, en of zoeken in een datasheet die twee moet matchen is een productbeslissing in plaats van een extractievraag:
uses
  SysUtils, Classes, PDFium;

// Uw eigen helper voor een zoekindex; geen deel van PDFium Component
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // exacte tekst blijft in Pdf.Text
    end;
  finally
    Pdf.Free;
  end;
end;
Draai IndexDocument op het bestand codepoints.pdf uit het eerste voorbeeld en de geïndexeerde regel luidt "two-x yz ΩΩ", elf tekens met een Ohm-teken als laatste, terwijl Pdf.Text nog steeds alle twaalf oorspronkelijke tekens teruggeeft, NBSP en soft hyphen inbegrepen
Op codepunt gesleutelde fonts, de CMap-reparatie en tekstextractie zitten op hetzelfde paginamodel in Delphi, C++Builder en Lazarus; de font- en tekst-API wordt volledig behandeld op de productpagina van PDFium Component for Delphi