Een scanbatch kan niets anders zijn dan één JPEG per pagina, zonder fonts, zonder annotaties en zonder bladwijzers, en toch als PDF/raster falen. ISO 23504-1 vraagt meer van het bestand dan alleen rasterpagina's: het moet zichzelf identificeren met een %PDF-raster-1.0-commentaar in het trailer-gebied, XMP-metadata en een trailer-/ID dragen, en zijn catalogus en Info-woordenboek beperken tot korte toegestane lijsten. Het controleren van een capturebatch vraagt daarom twee verschillende lezingen, één over de rauwe bytes en één over wat elke pagina werkelijk tekent
Twee lezingen van hetzelfde bestand
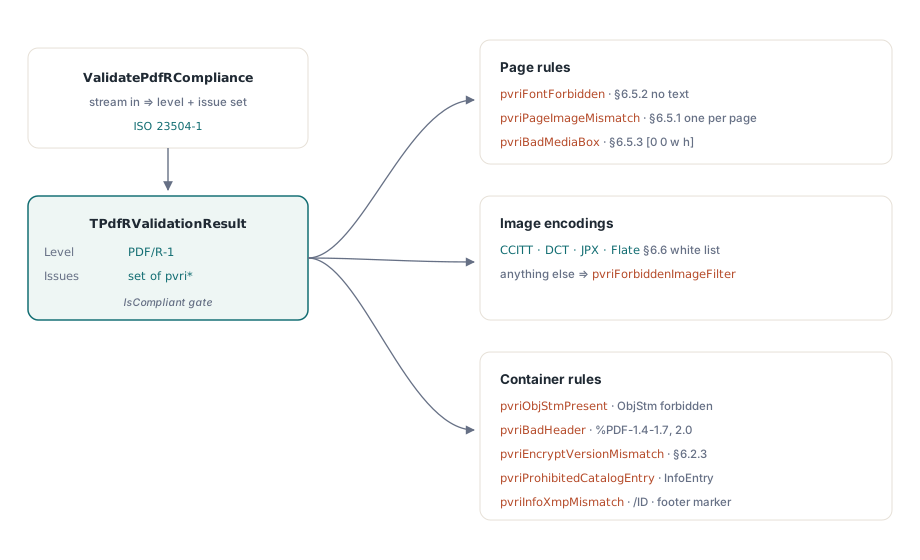
PDF/R-validatie en SaveAsPdfR worden meegeleverd met de Small Business- en Enterprise-edities van PDFium Component, dat de validatie langs die lijn splitst. ValidatePdfRCompliance in de unit FPdfPdfr leest een stream en controleert de regels op byteniveau: headerversie, de raster-marker, objectstreams, catalogus- en Info-entries, XMP, trailer-/ID, MediaBox-oorsprongen, fontresources, verboden filternamen en of het aantal beeldobjecten overeenkomt met het aantal pagina's. ValidatePdfRPageFacts controleert één pagina per keer vanuit een TPdfRPageFacts-record: hoeveel tekst-, pad-, formulier- en schaduwobjecten de pagina tekent, waar de enige stripafbeelding zit, zijn pixelgrootte, bitdiepte, kleurruimte en filterketen
Beide lezingen rapporteren via één opsomming, TPdfRValidationIssue, en de gecombineerde toegangspunten voegen ze samen in één TPdfRValidationResult. Zijn veld Conformance wordt pas prc1 wanneer de raster-marker is gevonden, en IsCompliant geeft True terug alleen wanneer het niveau prc1 is en de issueset leeg. Een bestand dat in elk ander opzicht perfect is maar de marker mist meldt prcNone, wat mensen de eerste keer verrast dat ze een propere scan erdoorheen halen
De vraag is waar de paginafeiten vandaan komen. TPdf.ValidatePdfR verzamelt ze uit het geladen document, maar hij serialiseert dat document eerst naar een tijdelijke opslag en draait de bytecontroles op de opnieuw opgeslagen kopie, dus de marker- en catalogusoordelen beschrijven een verse save, die kan afwijken van het bestand op schijf. ValidatePdfRasterSource in FPdfBusinessWorkflows neemt één momentopname van de invoerstream en draait beide lezingen daartegen. Voor een bestand dat op het punt staat het archief ingaat is dat de aanroep om te gebruiken: het oordeel heeft het dan over de bytes die worden gearchiveerd
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // het default budget is 64 MiB
  Options.Validation.MinimumResolutionDpi := 200; // ons capturecontract
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues bevat de bytelevel-issues plus elke pagina-issue
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues zegt welke pagina's opnieuw gescand moeten worden
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // Bewaar het machineleesbare oordeel naast het gearchiveerde bestand
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
Twee defaults in TPdfRasterSourceValidationOptions doen ertoe voor scanbatches. MaxInputBytes is 64 MiB en MaxPages is 1000; een lange batch kleurenscans kan het bytebudget overschrijden, en de controle eindigt dan met status prssBudgetExceeded en Complete False. MemoryLimitBytes is 8 MiB, daarboven loopt de momentopname over naar TemporaryDirectory en zet het rapport SnapshotSpilled. Report.IsCompliant vereist ook Complete, dus een controle die halverwege stopt leest nooit als een pass
Waarom faalt een OCR-tekstlaag PDF/R?
Omdat een rasterpagina de gescande afbeelding tekent en niets anders. Een onzichtbare OCR-laag is een normale toevoeging in een PDF/A-werkstroom, en hij stopt twee dingen in het bestand die PDF/R uitsluit: een fontresource, gemeld door de bytelezing als pvriFontForbidden, en tekstobjecten op de pagina, gemeld door de paginalezing als pvriNonRasterPageContent. Dezelfde pagina-issue gaat af voor vectorpaden, schaduwen en formulier-XObjects, dus een gestempeld paginanummer of een getekende kaderrand faalt op dezelfde manier als verborgen tekst
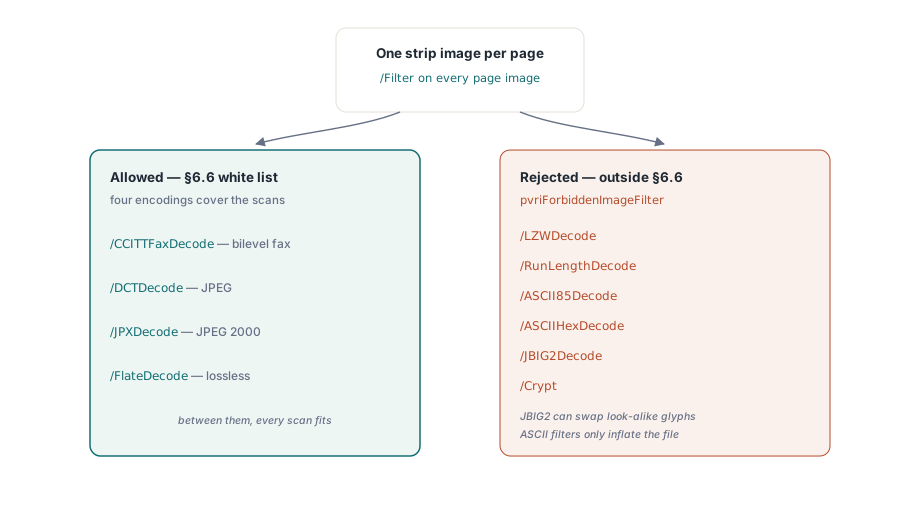
De pagina-naar-afbeelding-relatie is ook streng. Elke pagina moet exact één stripafbeelding dragen; pvriPageImageMismatch gaat af op een pagina zonder afbeelding en op een pagina waarvan de scan als twee afbeeldingen naast elkaar is weggeschreven. Aan de bytekant wordt de telling genomen over elk object waarvan /Subtype /Image is, dus elk extra beeldobject, een soft mask dat aan de strip hangt bijvoorbeeld, duwt het totaal voorbij het pagina-aantal
Geometrie krijgt twee controles. pvriBadMediaBox meldt een MediaBox die niet op [0 0 ...] begint; de bytelezing inspecteert inline numerieke arrays. De paginalezing vergelijkt daarna de getekende grenzen van de strip met de MediaBox en meldt pvriStripGeometryInvalid wanneer een rand er meer dan GeometryTolerancePoints vanaf zit, standaard 0,5 punt. Een scannerstuurprogramma dat een witte marge laat door de afbeelding op 98% van de pagina te schalen faalt hier, ook al ziet de pagina er op het scherm prima uit. RequireFullPageStrip op False zetten schakelt de dekkingstest uit voor interne bestanden waar een marge acceptabel is
Welke afbeeldingscoderingen doorgaan
De validator accepteert vier stripfilters: /CCITTFaxDecode, /DCTDecode, /JPXDecode en /FlateDecode. De bytelezing vlagt de andere standaardfilters bij naam als pvriForbiddenImageFilter: /LZWDecode, /RunLengthDecode, /ASCII85Decode, /ASCIIHexDecode, /JBIG2Decode en /Crypt
JBIG2 is de afwijzing die captureteams het eerst treffen. Hij is toegestaan in PDF/A en comprimeert bilevelpagina's uitstekend, dus een captureprofiel gebouwd voor PDF/A zendt hem misschien al uit. Zijn verliesgevende patroonherkenningsmodus staat er ook om bekend een gescande glyph te vervangen door een op een ander gelijkende, een gedocumenteerd probleem met cijfers op gescande formulieren, en een rasterarchief bestaat juist zodat wat op papier stond ook in het bestand staat. Die pagina's opnieuw coderen als CCITT Group 4 houdt ze bilevel en verliesvrij
De paginalezing gaat één stap verder en bekijkt de filterketen samen met de bitdiepte en kleurruimte van de afbeelding, en meldt mismatches als pvriImageCompressionParametersInvalid:
- Een keten van meer dan één filter wordt geweigerd, dus een ASCII85-ingepakte Flate-afbeelding faalt twee keer, één keer aan de bytekant en één keer hier
/CCITTFaxDecodemoet op een 1-bit DeviceGray-strip zitten/DCTDecodemoet op een 8-bit of 24-bit strip in DeviceGray of DeviceRGB zitten/FlateDecodewordt geaccepteerd op 1-bit strips; een 24-bit Flate-pagina faalt deze controle/JPXDecodewordt geaccepteerd op 1, 8 of 24 bits per pixel
Onafhankelijk van de filter krijgt een strip waarvan de kleurruimte noch DeviceGray noch DeviceRGB is pvriImageColorInvalid. Een ICC-gebaseerde of CMYK-scan moet dus worden geconverteerd voordat hij wordt ingepakt, en de goedkoopste plaats daarvoor is het scannerprofiel, voordat er ook maar een PDF wordt geschreven
Hoe de stripresolutie wordt bepaald
Draagt de afbeelding zijn eigen resolutie, dan gebruikt de paginalezing die. Doet hij dat niet, dan wordt de effectieve resolutie afgeleid uit pixels en paginaformaat: pixelbreedte keer 72 gedeeld door de MediaBox-breedte in punten, en hetzelfde voor de hoogte. Stel dat een scanner een strip van 2550 op 3300 pixels op een US Letter-pagina van 612 op 792 punten schrijft. Dat komt precies uit op 300 dpi in beide richtingen. Dezelfde pagina op 600 op 776 pixels komt uit op ongeveer 70,6 dpi horizontaal, onder de defaultminimum van 72, dus de pagina krijgt pvriImageResolutionInvalid
Het defaultbereik in TPdfRValidationOptions loopt van 72 tot 2400 dpi. Die grenzen vangen alleen openlijk kapotte pagina's. Een capturecontract belooft meestal een specifiek minimum, vaak 200 of 300 dpi, en die waarde hoort in MinimumResolutionDpi: een pagina van 150 dpi passeert het defaultbereik, en het is precies de pagina waarvoor dat contract is geschreven. Een van beide grenzen op 0 zetten schakelt die kant van de controle uit
ValidatePdfRPageFacts is publiek, dus dezelfde regels kunnen draaien voordat er ook maar een PDF bestaat, rechtstreeks vanuit wat de scanner over elke afbeelding rapporteert:
uses
  FPdfPdfr;

// Bouwt paginafeiten uit scanneruitvoer; deze helper is van u, geen deel van de bibliotheek
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // de strip dekt de hele pagina
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi op 0 gelaten: afgeleid
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray, 2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // 300 dpi kleuren-JPEG op Letter: lege set
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // Dezelfde pagina met Flate gecomprimeerd op 24 bits:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
Catalogus, Info-woordenboek en XMP
Naast de verplichte /Type en /Pages staat ISO 23504-1 in de catalogus alleen Version, ViewerPreferences, PageLayout, PageMode, AcroForm en Metadata toe. De validator controleert de catalogus tegen de 21 standaardkeys buiten die set en gooit pvriProhibitedCatalogEntry wanneer er een van opduikt, waaronder Outlines, Names, PageLabels, OpenAction, StructTreeRoot, MarkInfo, Lang, OCProperties en OutputIntents. De laatste doet er in de praktijk toe: een PDF/A-bestand draagt altijd een output intent, dus één bestand kan niet aan beide profielen voldoen
Het Info-woordenboek mag Creator, Producer, CreationDate en ModDate bevatten; Title, Author, Subject, Keywords en Trapped gooien pvriProhibitedInfoEntry. Een catalogus zonder /Metadata-stream krijgt pvriMissingXmpMetadata. Is de stream er wel maar mist zijn XMP een van xmp:CreateDate, xmp:ModifyDate en xmp:MetadataDate, dan is de bevinding pvriMetadataInvalid. pvriInfoXmpMismatch vergelijkt Producer met pdf:Producer en Creator met xmp:CreatorTool. Datums blijven buiten die vergelijking omdat de twee encodings legitiem verschillen, en Info-waarden opgeslagen als hex-strings worden overgeslagen. Een typische trigger is een latere tool die de Info-Producer herschrijft zonder de XMP aan te raken
De resterende containerregels zijn kort. De header moet %PDF-1.4 tot en met %PDF-1.7 of %PDF-2.0 zijn (pvriBadHeader), elke /Type /ObjStm-stream gooit pvriObjStmPresent, en een versleuteld bestand moet een %PDF-2.0-header gebruiken (pvriEncryptVersionMismatch). Met RequireEncryptedPdf20Profile aan moet het versleutelingswoordenboek ook /V 5 of 6 declareren met /R 5 of later, of het bestand krijgt pvriEncryptedPdf20ProfileInvalid
De markers schrijven
TPdfRSaveOptions draagt Creator, Producer, CreationDate, ModDate, DocumentId en InstanceId, en heeft geen veld voor Title, Author, Subject of Keywords omdat het profiel ze verbiedt. StripInfoOptionalEntries en StripCatalogOptionalEntries staan beide default op True en verwijderen de uitgesloten entries uit de bron; zet een van beide op False en de entries blijven, ten koste van conformiteit. TPdf.SaveAsPdfR vult lege optievelden vanuit de eigen metadata en bestandsidentificatoren van het geladen document, verwijdert beveiliging, en schrijft dan de marker, de gekapte woordenboeken, het XMP-pakket en de trailer-/ID
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer, datums en ID's komen uit de bron
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // Controleer de bytes die zijn weggeschreven, niet het document in het geheugen
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
Inpakken verandert alleen metadata en identificatie. Een bronpagina die vectortekst tekent, of geen stripafbeelding draagt, komt uit SaveAsPdfR met dezelfde pagina-inhoud en faalt dezelfde paginacontroles. De pagina-inhoud wordt met opzet met rust gelaten, want stilletjes een scan opnieuw renderen zou precies de pixels veranderen die het archief wil bewaren. CheckDeliveredScan uit de eerste listing op OutFile draaien geeft het volledige oordeel, paginalezingen inbegrepen
Waar PDF/R past in een capture-pijplijn
PDF/R past bij afleverproducten waar de scan zelf de registratie is en getrouwheid het hele contract: bewijslastbeelding, cheque- en betalingsverwerking, tekeningenarchieven van een grootformaatscanner. Zodra een document doorzoekbare tekst, tagging, bijlagen of bladwijzers nodig heeft hoort het in PDF/A, want elk van die functies landt op de uitsluitlijsten hierboven
Veel teams houden beide bij. Een PDF/R-origineel wordt één keer geschreven en verandert nooit, en een PDF/A-afgeleide met een OCR-laag dient de retrieval. De validators zijn onafhankelijk, dus één batchtaak kan elk bestand controleren tegen het profiel dat het claimt. De archiefkant wordt behandeld in PDF/A-archiefconformiteit en PDF/A-preflight-validatie, en printuitvoer in drukklare PDF/X-documenten valideren
De hier getoonde PDF/R-controles maken deel uit van de Small Business- en Enterprise-edities van PDFium Component for Delphi, C++Builder en Lazarus, naast validators voor PDF/A, PDF/X, PDF/E en PDF/UA; edities en ondersteunde IDE-versies staan op de productpagina van PDFium Component