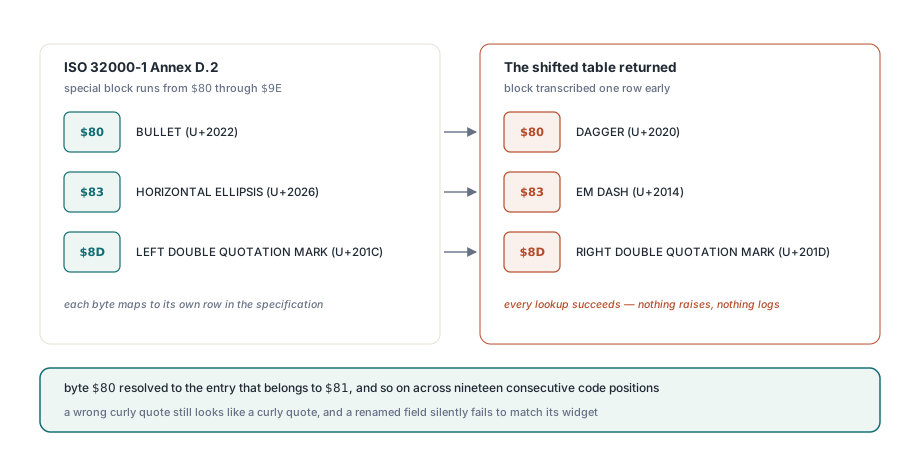
Importeer een FDF in een formulier en de veldwaarden komen er subtiel fout uit: een bullet arriveert als dagger, een ellips als em dash. PDFium Component herleidde die hele familie symptomen tot één rij in zijn PDFDocEncoding-tabel — het speciale-tekensblok in ISO 32000-1 Annex D.2 begint bij $80, niet bij $7F
Waarom geeft een FDF-import het buurteken terug?
Omdat een coderings-tabel die één positie is verschoven er nog steeds uitziet als een volkomen geldige tabel, en elke lookup erin slaagt. Het blok dat Annex D.2 aan $80 tot en met $9E toewijst, was één rij te vroeg overgeschreven, dus byte $80 loste op naar de entry die bij $81 hoort, byte $81 naar de entry voor $82, en zo verder over negentien opeenvolgende codeposities. Niets gooide een exceptie, niets logde, en geen enkel veld werd ooit afgewezen — TPdf.ImportFDF rapporteerde hetzelfde veld-aantal als altijd
De schade was uniform en stil. Een byte met $80, die Annex D.2 definieert als BULLET (U+2022), kwam terug als DAGGER (U+2020). Byte $83, HORIZONTAL ELLIPSIS (U+2026), kwam terug als EM DASH (U+2014). Byte $8D, LEFT DOUBLE QUOTATION MARK (U+201C), kwam terug als RIGHT DOUBLE QUOTATION MARK (U+201D) — het geval dat niemand opvalt, want een verkeerde curly quote ziet er in een formulierveld nog steeds uit als een curly quote. Veldnamen ondergingen hetzelfde lot als veldwaarden, en dat is erger: een naam die niet langer overeenkomt met de widget in het document wordt stilletjes gewoon niet toegepast
PDF-tekststrings dragen twee verschillende encodings
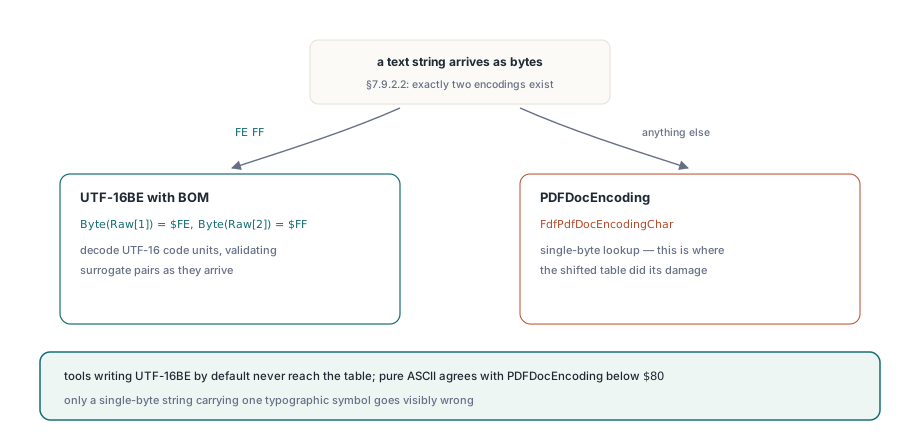
ISO 32000-1 §7.9.2.2 definieert het tekststring-type als een van precies twee encodings, gekozen door de eerste twee bytes te inspecteren in plaats van via een dictionary-entry. Een string die opent met de byte order mark FE FF is UTF-16BE; al het andere is PDFDocEncoding. Die ene branch beslist welke van twee totaal verschillende decoders draait, en PDFium Component past hem in de FDF-parser toe voordat er ook maar één teken wordt aangeraakt
// FDF-tekststring: UTF-16 wanneer de BOM aanwezig is, anders PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... decodeer UTF-16 code units, valideer surrogate pairs
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
Dit is waarom de bug zo lang verborgen bleef in gewoon testwerk. Elke FDF die door een tool is geproduceerd die standaard UTF-16BE schrijft, bereikt FdfPdfDocEncodingChar nooit, dus de verschoven tabel blijft slapend. Alleen single-byte strings — wat veel FDF-generators voor gewone Latijnse veldnamen emitteren, omdat die korter zijn — gaan de branch in waar de tabel ertoe doet. Pure ASCII-veldnamen decoderen dan toch nog correct, want onder $80 komen PDFDocEncoding en ASCII overeen. Je hebt pas een single-byte string met één typografisch symbool nodig voordat er zichtbaar iets misgaat
De gecorrigeerde tabel, en de twee ankers die hem vastpinnen
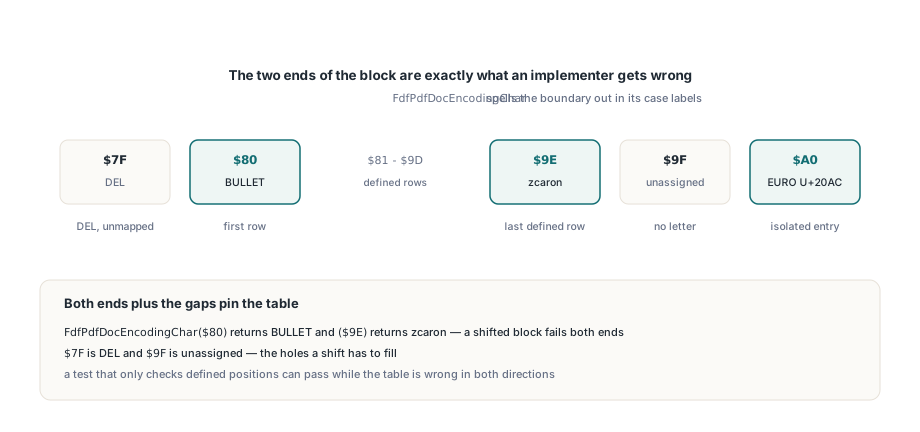
PDFium Component legt de grens nu expliciet vast in FdfPdfDocEncodingChar zelf, want de twee uiteinden van het blok zijn precies wat een implementator fout doet. $7F is DEL en heeft helemaal geen PDFDocEncoding-betekenis; het blok opent bij $80 met BULLET en loopt tot $9E met zcaron; $9F is niet toegewezen; en het euroteken zit alleen op $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annex D.2. Het blok loopt vanaf $80, niet $7F: $7F is DEL en
    // heeft geen PDFDocEncoding-betekenis, en de Euro zit op $A0, die de
    // default branch anders als no-break space terug zou geven
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, eerste rij van het blok
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 tot en met $9D
    $9E: Result := WideChar($017E);   // zcaron, laatste gedefinieerde rij
    $9F: Result := WideChar($FFFD);   // niet toegewezen in Annex D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Kijk naar wat de verschuiving met die twee uiteinden deed, want daar houdt een off-by-one op cosmetisch te zijn. zcaron zat in de specificatie op $9E, maar in de verschoven tabel op $9D, dus een documentbyte van $9E viel voorbij de laatste rij die iemand had overgeschreven en gleed rechtstreeks door naar de identity-fallback, die een C1-controlcharacter teruggaf in plaats van een letter. En $A0, de Euro, was in de eerste plaats nooit in de tabel geschreven — de identity-branch gaf hem terug als U+00A0 NO-BREAK SPACE, een teken dat elke volgende validatie overleeft, niets print, en nooit overeenkomt met de veldnaam waarnaar je op zoek bent
Hoe test je een overgeschreven coderings-tabel?
Test de eerste rij, de laatste rij en de gaten — niet een steekproef uit het midden. Dit is het deel van de fix dat je naar elke andere tabel meeneemt die je uit een specificatie kopieert, want een steekproef midden in het blok is precies de test die een hele-blokverschuiving overleeft. Verifiëren dat $8D een left double quote geeft bewijst niets wanneer $8C ook iets plausibels geeft; verifiëren dat $80 BULLET geeft en $9E zcaron pinst beide uiteinden, en een verschoven blok kan niet aan beide tegelijk voldoen
procedure CheckPdfDocEncodingAnchors;
begin
  // Beide uiteinden van het speciale blok van Annex D.2: een hele-blokverschuiving breekt deze
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Codeposities die de specificatie ongedefinieerd laat mogen niet naar een letter decoderen
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // De geïsoleerde entry boven het blok, makkelijk om helemaal te vergeten
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
De ongedefinieerde posities verdienen hun eigen assertions in plaats van te worden overgeslagen als oninteressant. Een off-by-one moet ergens iets neerzetten, en waar hij het neerzet is bijna altijd een codepositie die de specificatie leeg liet — $7F vooraan, $9F achteraan. Een test die alleen gedefinieerde posities controleert kan slagen terwijl de tabel in beide richtingen fout is; een test die de gaten vastpint vangt de verschuiving bij de eerste run
Wat dit kost in een round-trip formulierworkflow
Een FDF-import die per symbool stilletjes één teken herschrijft is erger dan een die faalt, want de fout komt pas stroomafwaarts boven en ziet eruit als iets anders. Veldnamen zijn hier de scherpe rand. TPdf.ImportFDF matcht binnenkomende namen tegen de widgets in het geopende document, en een naam die één teken fout decodeerde matcht gewoon niet — het veld blijft leeg, de return value telt het veld nog steeds als geparsed, en het rapport dat uit de pipeline komt mist één waarde zonder dat er iets in de log staat dat uitlegt waarom. Iedereen die een export-en-reimport-loop bouwt van het soort dat het exporteren en importeren van XFDF-formulierdata en annotaties met PDFium Component beschrijft, zou een veldnaam met een typografisch symbool round-trippen, niet alleen pure ASCII, voordat hij de loop vertrouwt
Het is ook eerlijk om de grenzen van de fix te benoemen. De tabel matcht nu Annex D.2 voor alle 256 bytewaarden, waardoor single-byte FDF-strings correct decoderen, maar PDFDocEncoding zelf dekt een Latijns repertoire en niets meer — alles daarbuiten moet als UTF-16BE met een BOM binnenkomen, en dat is precies wat §7.9.2.2 bedoelt. En een UTF-16-string heeft aan de Delphi-kant nog steeds zijn eigen gevaren, want een codepoint boven U+FFFF heeft een surrogate pair nodig in plaats van één WideChar, het probleem dat waarom emoji- en CJK-tekens WideChar in Delphi breken behandelt. Het bredere punt generaliseert voorbij coderings-tabellen: een PDF-parser kan iets afwijzen dat hij zou moeten accepteren, en dat vind je meteen, of iets accepteren en het stilletjes fout doen, en dat vind je in productie. De name-token-valkuilen die het veilig parsen van PDF-dictionaries beschrijft zitten in die tweede categorie, en dat geldt ook voor een tabel die één rij is verschoven — het codepad slaagt, de return value ziet er redelijk uit, en alleen een test die tegen de specificatie is geschreven in plaats van tegen de implementatie zegt dat het anders zit
ImportFDF, ExportFDF en ImportXFDF op TPdf, samen met de FDF- en XFDF-parsers erachter, maken deel uit van de standaard PDFium Component voor Delphi en C++Builder