PDFium Component controleert de PDF/A-equivalentie van Info-naar-XMP-metadata met TPdf.InspectPdfAMetadata en herstelt die met TPdf.NormalizePdfAMetadata. ISO 19005-1 (zoals gecorrigeerd door Cor.1) eist dat elk van de acht gemapte Info-invoeren, van Title tot ModDate, dezelfde waarde draagt als zijn XMP-eigenschap, en niet slechts bestaat; de controle leest de juiste RDF-vorm, matcht namespaces op URI en vergelijkt datums als tijdstippen
Het bugrapport dat dit gesprek meestal opent oogt onschuldig. Een documentmanagementsysteem stempelt bij elke incrementele save een nieuwe /ModDate in het Info-woordenboek, laat het XMP-pakket met rust, en zes maanden later vlagt een archiefaudit duizenden bestanden als niet-conform. Beide datums zijn er. Ze zijn alleen op de eerste bewerking uit elkaar gegaan, en een aanwezigheidscontrole merkte daar nooit iets van. Titelbewerkingen via een API die alleen Info kent, en een Author-string als Finance; Controlling die een of andere tool splitste in twee dc:creator-items, falen op dezelfde manier
Waarom verwerpt PDF/A metadata die op beide plekken bestaat?
PDF/A verwerpt het omdat ISO 19005-1 §6.7.3 een waarderegel is, geen aanwezigheidsregel: Tabel 1 mapt acht Info-sleutels op XMP-eigenschappen, en zodra een Info-sleutel aanwezig is, moet de gemapte XMP-eigenschap een equivalente waarde bevatten. De scanner op byteniveau uit PDF/A-preflightvalidatie met PDFium Component bevestigt alleen dat xmp:CreateDate en xmp:ModifyDate bestaan (pvaiMissingXmpDates). Sinds v3.72.0 draait TPdf.ValidatePdfA er bovendien de volledige waardevergelijking naast en voegt pvaiInfoXmpValueMismatch toe aan de issueset zodra er een XMP-pakket is dat het niet met Info eens is (een pakket dat niet te parsen is, telt als oneens). Een ontbrekend pakket blijft gemeld als pvaiMissingXmpMetadata, dus de twee issues tellen hetzelfde defect nooit dubbel
Welke RDF-vorm heeft elke gemapte XMP-eigenschap nodig?
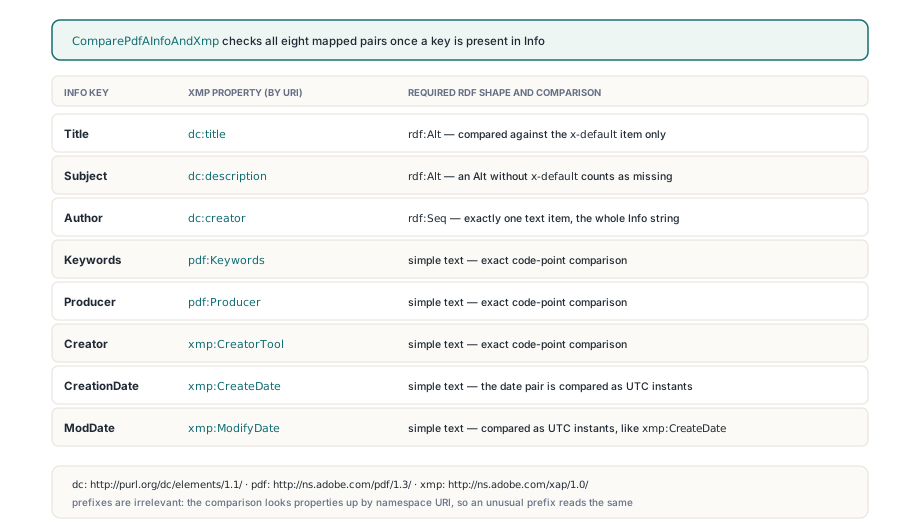
Elk van de acht mappings heeft een vast XMP-type, en een correcte waarde in de verkeerde container faalt alsnog. ComparePdfAInfoAndXmp in FPdfPdfa.pas zoekt eigenschappen op bij namespace-URI, dus een pakket dat http://purl.org/dc/elements/1.1/ aan een ongebruikelijk prefix bindt, wordt precies zo gelezen als één die dc gebruikt. De vereiste vormen zijn:
- Title →
dc:titleen Subject →dc:description: eenrdf:Alt-taalalternatief, vergeleken uitsluitend met zijn itemx-default(de taaltag wordt case-insensitief gematcht); een Alt zonderx-defaulttelt als ontbrekend - Author →
dc:creator: eenrdf:Seqmet precies één tekstitem dat de volledige Info-string bevat, zodat een puntkomma-gescheiden auteurslijst één enkele invoer blijft - Keywords →
pdf:Keywordsen Producer →pdf:Producer(namespacehttp://ns.adobe.com/pdf/1.3/): eenvoudige teksteigenschappen - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(namespacehttp://ns.adobe.com/xap/1.0/): eenvoudige teksteigenschappen
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Tekstwaarden worden vergeleken als exacte reeksen van Unicode-codepunten, zonder trimmen, case folding of normalisatie. Een spatie aan het eind, of een precomposed é aan de ene kant en een decomposed e plus combinerend accent aan de andere, is een echte mismatch. De Info-kant komt altijd uit de eigen decodering door PDFium van PDFDocEncoding- en UTF-16-tekst via FPDF_GetMetaText, zodat de library de stringdecodering niet opnieuw hoeft te implementeren en daar subtiel de fout in kan gaan; de XMP-kant is net zo schoon als de bytes die hem opleverden, en daarom zijn de codepage-valkuilen die XMP-metadata onder Free Pascal corrumperen ook hier van belang
Wanneer is een PDF-datum gelijk aan een XMP-datum?
Een PDF-datum en een XMP-datum zijn gelijk als ze hetzelfde tijdstip tot op de seconde beschrijven, met aan beide kanten dezelfde kennis van de tijdzone. Beide parsers accepteren wettig gereduceerde precisie, dus D:2026 en 2026 betekenen beide 1 januari 2026, 00:00:00. Dragen beide waarden een zone, dan worden ze vóór de vergelijking naar UTC omgezet: D:20260827093659+08'00' is gelijk aan 2026-08-27T01:36:59Z. Dragen geen van beide een zone, dan worden de lokale onderdelen vergeleken zoals ze staan. Heeft slechts één kant een zone, dan is de uitkomst pamsValueMismatch, want een offset verzinnen is gokken. Een fractionele seconde ongelijk aan nul, zoals .250 in XMP, dwingt ook een mismatch af, want een PDF-datum kan die niet uitdrukken en hem geruisloos wegronden zou een echte tegenstrijdigheid verhullen; .000 wordt geaccepteerd. Onparseerbare waarden worden apart gemeld als pamsInvalidInfoDate of pamsInvalidXmpDate
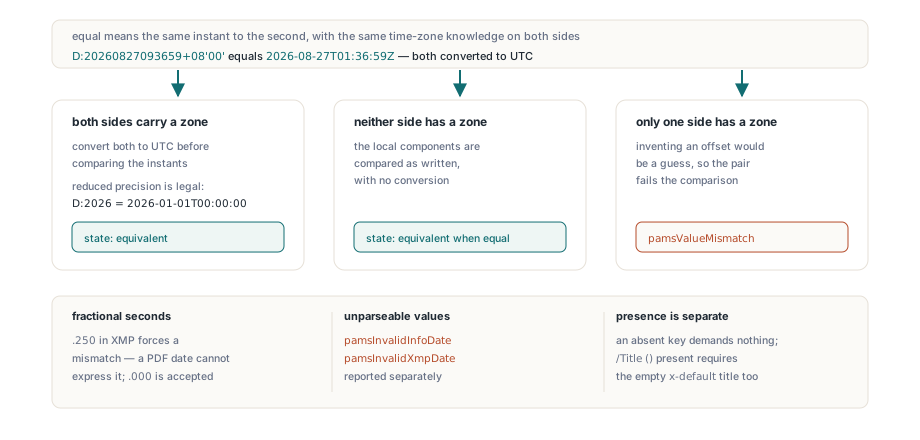
Aanwezigheid heeft zijn eigen regel. TPdfAMetadataValues.Present is een set die wordt gevuld door het woordenboek /Info van de actieve trailer af te lopen, en hij houdt "sleutel afwezig" gescheiden van "sleutel aanwezig met een lege string". Een afwezige sleutel levert pamsNotRequired op en eist niets van XMP; /Title () is aanwezig, dus het XMP-pakket moet ook een lege titel x-default meedragen
Hoe inspecteert u Info- en XMP-metadata vóór het opslaan?
TPdf.InspectPdfAMetadata geeft een TPdfAMetadataReport terug met één TPdfAMetadataComparison per veld, elk met de Info-waarde, de XMP-waarde en een TPdfAMetadataState, zodat een faling uit te leggen is zonder één validatievlag te moeten reverse-engineeren. MismatchFields vat de falende set samen, HasXmpPacket vertelt of er een pakket is gevonden, en XmpParseError draagt de parsermelding wanneer het pakket bestaat maar niet leesbaar is
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
Wat verandert NormalizePdfAMetadata, en wat weigert het?
TPdf.NormalizePdfAMetadata behandelt het Info-woordenboek als de bron van waarheid en herschrijft alleen de XMP-eigenschappen waarvan het veld in MismatchFields terechtkwam; al het andere in het pakket overleeft het. Title en Subject worden in het item x-default geschreven terwijl andere taalalternatieven intact blijven, Author wordt een rdf:Seq met één item, onbekende namespaces en ongerelateerde eigenschappen blijven behouden, en XMP-eigenschappen voor afwezige Info-sleutels worden onaangeroerd gelaten. Een Info-datum met zone wordt geschreven als een canonieke UTC-XMP-datum met suffix Z; één zonder zone houdt zijn lokale onderdelen. De bestandsoverload slaat op via een tijdelijk bestand en een atomaire vervanging, en de XMP-update zelf wordt toegevoegd als incrementele update
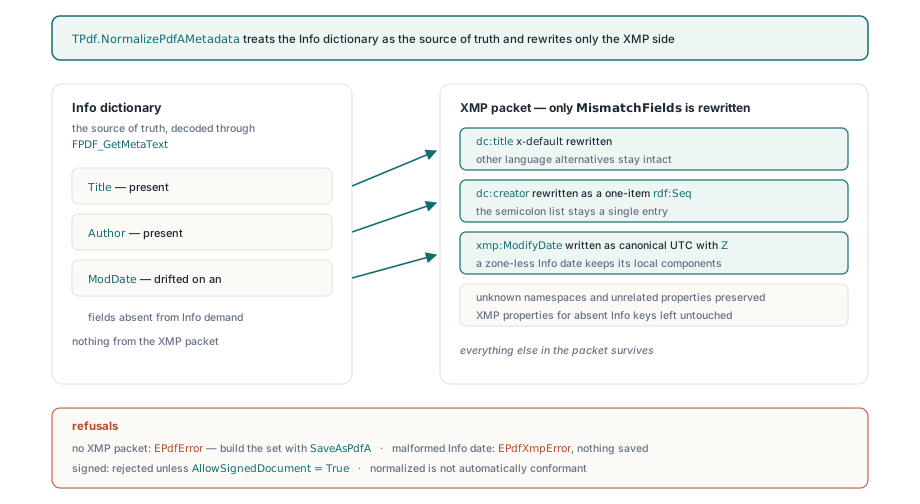
De weigeringen zijn bewust. Zonder XMP-pakket gooit de methode EPdfError, want het bouwen van een volledige PDF/A-identificatie en metadataset is het werk van SaveAsPdfA, behandeld in PDF/A-archiefbestanden maken met PDFium Component. Een misvormde Info-datum gooit EPdfXmpError in plaats van een plausibel ogende foute waarde te schrijven, en er wordt niets opgeslagen. Ondertekende documenten worden geweigerd tenzij de aanroeper AllowSignedDocument = True doorgeeft. Equivalentie is ook slechts één regel van ISO 19005-1, dus een genormaliseerd bestand is niet automatisch conformant
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // al consistent, laat het bestand met rust
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // misvormde Info-datum of onleesbaar pakket
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
De vergelijking draaien op uw eigen XMP-pakket
ComparePdfAInfoAndXmp en SynchronizePdfAInfoToXmp zijn gewone functies in FPdfPdfa die op een TPdfXmpPacket werken zonder geladen document, wat handig is voor unittests en pipelines die XMP uit een sjabloon opbouwen. De enige valkuil is Present: een record geïnitialiseerd met Default(TPdfAMetadataValues) heeft een lege set, elk veld meldt dan pamsNotRequired, en de vergelijking slaagt vacuüm, ongeacht welke waarden u invulde
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present bepaalt welke velden verplicht zijn; waarden alleen worden genegeerd
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // xmp:ModifyDate is nu 2026-08-27T01:36:59Z, dc:creator een rdf:Seq met één item
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Archivert uw pipeline documenten die andere systemen blijven bewerken, dan koppelt u een nachtelijke InspectPdfAMetadata-ronde aan NormalizePdfAMetadata voor de bestanden die afdwalen, en houdt u ValidatePdfA als poort voordat er iets naar langetermijnopslag vertrekt. Het getypeerde rapport, het reparatiepad en de rest van de PDF/A-tooling zitten in de PDFium Component voor Delphi en C++Builder