Een factuurarchief kan schoon renderen, printen, elk font insluiten en een geldige output intent dragen, en een PDF/A-validator weigert het toch omdat één resource-woordenboek 4.096 entries bevat. Het plafond ligt op 4.095. PDF/A erft een kleine tabel met implementatielimieten uit de PDF Reference, en een bestand dat er met één unit overheen gaat, faalt op conformiteit ook al klaagt geen enkele viewer
Het andere falen dat in hetzelfde emmertje "maar het oogt prima" belandt, is een symbolisch TrueType-font dat een /Encoding-entry draagt. Vinkjes, streepjescodes en dingbats komen goed op het scherm, en de validator vlagt het fontwoordenboek toch. Beide problemen wonen in de objectgraaf in plaats van in iets dat een mens op de pagina kan zien, dus ze zijn het mechanisch controleren waard voordat een bestand in een archief gaat
De getallen die PDF/A erft, en waar de grens ligt
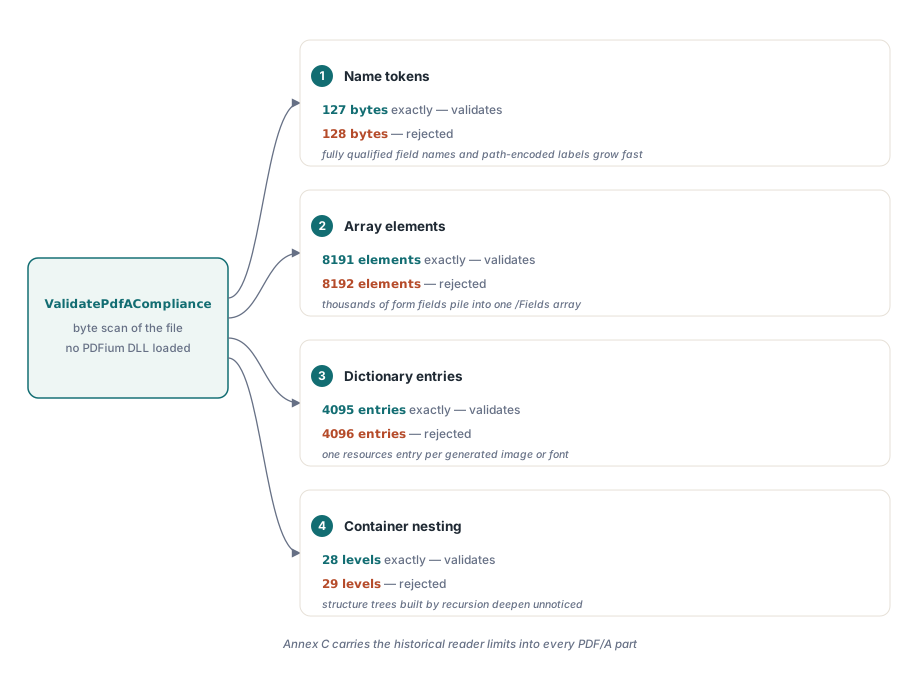
PDFium Component controleert vier containerlimieten bij elke PDF/A-validatie: een naamtoken mag hooguit 127 bytes lang zijn, een array mag hooguit 8.191 elementen bevatten, een woordenboek mag hooguit 4.095 entries bevatten, en arrays en woordenboeken mogen hooguit 28 niveaus diep nesten. Alle vier de grenzen zijn inclusief. Een naam van 127 bytes passeert en een naam van 128 bytes faalt; een array van precies 8.191 elementen passeert en één element meer doet hem falen
De naam-, array- en woordenboeklimieten komen uit de tijd waarin een conforme lezer alleen structuren tot die groottes hoefde te verwerken. Een huidige desktopviewer kan een veel grotere array zonder klagen openen, maar van een archiefbestand wordt verwacht dat het opent in lezers die nog niemand heeft getest, inclusief oude lezers die een recordsysteem misschien nog draait. Daarom houdt PDF/A de historische plafonds aan in plaats van ze te verslappen
Inclusief tegenover exclusief is waar handgemaakte controles meestal misgaan. Een test geschreven als Count >= 8191 in plaats van Count > 8191 weigert bestanden die conformeren, en een validator die conforme bestanden weigert wordt desondanks geloofd, dus de generator wordt "gefixt" voor een probleem dat hij nooit had. De functie ValidatePdfACompliance in de unit FPdfPdfa telt pas voorbij de limiet, en hij leest de bestandsbytes direct, dus de controle draait zonder de PDFium-DLL te laden
uses
  System.Classes, FPdfPdfa;

procedure CheckContainerLimits(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Res: TPdfAValidationResult;
begin
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfACompliance(Src);   // bytescan, geen PDFium-DLL nodig
    if pvaiNameOverLimit in Res.Issues then
      Log.Add('A name token is longer than 127 bytes');
    if pvaiArrayOverLimit in Res.Issues then
      Log.Add('An array holds more than 8191 elements');
    if pvaiDictOverLimit in Res.Issues then
      Log.Add('A dictionary holds more than 4095 entries');
    if pvaiNestingOverLimit in Res.Issues then
      Log.Add('Arrays and dictionaries nest deeper than 28 levels');
    if Res.IsCompliant then
      Log.Add('No PDF/A findings');
  finally
    Src.Free;
  end;
end;
De vier vlaggen zijn leden van de set Issues op TPdfAValidationResult, naast elke andere PDF/A-uitkomst, en IsCompliant geeft alleen True terug wanneer er een PDF/A-identificatie is gevonden en de set leeg is. Een bestand dat helemaal geen PDF/A-identificatie draagt, wordt gecontroleerd tegen de strenge PDF/A-1-regelset, dus de containerlimieten gelden ook voor hem
Welke generatoren lopen tegen deze limieten op?
Bijna altijd degenen die structuur in een lus bouwen. Een formulier met enkele duizenden velden produceert een AcroForm-/Fields-array, of een pagina-/Annots-array, die voorbij 8.191 entries loopt. Een rapportengine die per gegenereerd object één font- of afbeeldingsresource registreert en nooit een bestaande entry hergebruikt, laat een /Resources-subwoordenboek voorbij 4.095 sleutels groeien. Een getagd document waarvan de structuurboom door recursie over een genest datamodel ontstaat, kan zonder dat iemand kijkt voorbij 28 niveaus gaan
Lange namen hebben een andere oorsprong: data die in naamtokens wordt gepropt. Een separation-colorant genoemd naar een klantreferentie, een optional-content-groep genoemd naar een bestandspad, een veldlabel opgebouwd uit zes hiërarchieniveaus. Namen kosten niets om te genereren, en 127 bytes zijn snel bereikt zodra er een UTF-8-label met geaccenteerde tekens meedoet, want elk van die tekens kost twee of drie bytes. De 127 bytes worden geteld na de /-introductor, tot de volgende delimiter of witruimte
De remedie is elke keer structureel. Splits de array, splits het woordenboek, maak de recursie vlak, verkort de naam. PDF/A-markers in het bestand injecteren helpt bij geen van deze uitkomsten, want het probleem is de vorm van de objectgraaf en de XMP-metadata zegt er niets over
Hoe de scan elementen en entries telt
De telregel telt wanneer u een uitkomst in een hex-editor probeert te reproduceren. Een geneste array of woordenboek telt als één element van zijn ouder, zo is de limiet geformuleerd: een array van 10 elementen die elk 1.000-element-arrays zijn, is prima, want geen enkele array overtreft 8.191. Binnen een woordenboek worden alleen de sleutels geteld, dus een waarde die toevallig een naam is, blaast het entrytotaal niet op. Hex-tekenreeksen zoals <FEFF0041> worden als losse tokens overgeslagen, dus hun hoekhaakjes worden nooit aangezien voor woordenboeknesting
De scan dekt de objectstructuur van het hele bestand, inclusief objecten die in gecomprimeerde objectstreams zijn bewaard en die vóór het tellen worden uitgepakt. Streamlichamen zelf, zoals pagina-inhoud en afbeeldingsdata, worden eerst leeggemaakt, dus een reeks binary-bytes die toevallig een / of een [ bevat, kan geen valse naam- of array-uitkomst triggeren
Er is een aangrenzende numerieke limiet die dezelfde validatie onder een eigen vlag meldt. Wanneer het bestand PDF/A-2 of een later deel declareert, wordt pvaiIntegerImplementationLimit gezet voor elk integer-token buiten het 32-bits signed bereik, dat wil zeggen buiten -2.147.483.648 tot 2.147.483.647. Generatoren die byte-offsets of grote tellers als kale integers schrijven, zijn de gebruikelijke bron
Waarom moet een symbolisch TrueType-font /Encoding laten vallen?
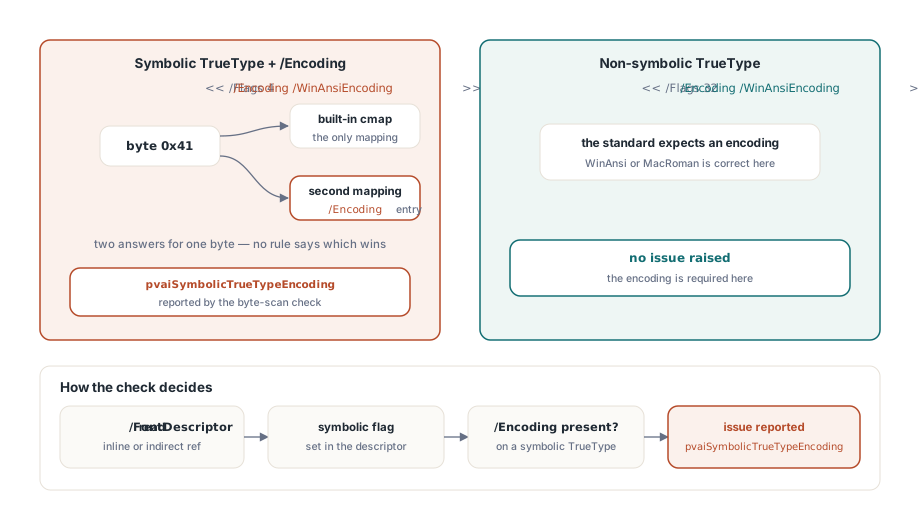
ISO 19005-1 §6.3.7 staat voor een symbolisch TrueType-font alleen de ingebouwde cmap van het fontprogramma toe als karakterafbeelding. Een symbolisch font mapt codes op glyphs op eigen gezag; dat verklaart de Symbolic-vlag. Voeg een /Encoding-entry toe en het bestand geeft nu twee antwoorden op de vraag "welke glyph selecteert byte 0x41", zonder dat iets in het bestand zegt welke wint. Lezers resolven het conflict verschillend, en hetzelfde vinkje kan in de ene viewer als vinkje en in de andere als de letter A verschijnen
ValidatePdfACompliance vindt elk fontwoordenboek met /Subtype /TrueType, controleert of het een /Encoding-sleutel heeft, en leest daarna bit 3 (waarde 4) van de entry /Flags in de fontdescriptor. De descriptor wordt gevolgd of hij nu inline is geschreven of als indirect object wordt gerefereerd. Een niet-symbolisch TrueType-font dat /WinAnsiEncoding of /MacRomanEncoding houdt, wordt door deze controle niet gevlagd, want voor niet-symbolische fonts verwacht PDF/A precies die encoding
// Res komt van ValidatePdfACompliance zoals in het eerste voorbeeld
if pvaiSymbolicTrueTypeEncoding in Res.Issues then
  Log.Add('A symbolic TrueType font carries /Encoding; PDF/A admits only ' +
    'the font''s built-in cmap (ISO 19005-1 6.3.7)');

// Een buurregel met een andere trigger: een NIET-symbolisch
// TrueType-font waarvan het Encoding-woordenboek /Differences draagt
if pvaiTrueTypeDifferencesForbidden in Res.Issues then
  Log.Add('A non-symbolic TrueType Encoding dictionary carries /Differences');
De fonts die deze regel triggeren zijn voorspelbaar: Symbol, Wingdings, streepjescode-fonts, iconfonts. Ze verschijnen in zakelijke documenten als vinkjes, sterren en streepjescodes, en een subsettingstap die elk TrueType-font gelijk behandelt, schrijft er ook een encoding voor weg. Het zijn ook de fonts waar niemand naar kijkt wanneer een validator "fontprobleem" zegt, want de fonts van de lopende tekst worden eerst gecontroleerd
De omgekeerde fout komt ook in het wild voor: een producent zet de Symbolic-vlag op een gewoon tekstfont dat in werkelijkheid WinAnsi-gecodeerd is. De PDF/A-controle volgt de clausule zoals geschreven en meldt dat font, en hier hoort de reparatie thuis in de descriptor: verbeter de vlag in de descriptor in plaats van de encoding te verwijderen. /Encoding uit een verkeerd gelabeld tekstfont halen zou de tekst laten afhangen van welke cmap de subset toevallig bevat, en dat is een slechter bestand dan waarmee u begon. Bekijk de glyphset van het font voordat u kiest welke helft van de contradictie eruit gaat
De uitkomsten lezen in een preflightrapport
De preflightrapport-unit wordt meegeleverd met de Enterprise-editie, terwijl ValidatePdfACompliance in elke editie zit. Het rapport in de unit FPdfPreflightReport sorteert de vier containerlimieten in de categorie Structure en de kwestie rond symbolische TrueType-encoding in de categorie Content. Die splitsing is bewust. Uitkomsten over structuur gaan meestal terug naar wie de generator onderhoudt, uitkomsten over inhoud meestal naar wie de fonts en sjablonen aanleverde, en een rapport dat ze mengt stuurt beide mensen achter problemen aan die niet van hen zijn
Elke issue draagt zijn enumnaam als Code en een aanbeveling die de remedie in concrete termen benoemt, bijvoorbeeld "Split dictionaries so none carries more than 4095 entries". Let op dat de categorie Structure ook twee andere uitkomsten bevat, een ontbrekende getagde structuur bij een Level A-claim en PDF 1.5-crossreference- of objectstreams in een PDF/A-1-bestand, dus filter op code wanneer u alleen de vier limieten wilt
uses
  System.SysUtils, System.Classes, PDFium, FPdfPreflightReport;

procedure ReportStructureFindings(const FileName: string; Log: TStrings);
var
  Pdf: TPdf;
  Report: TPdfPreflightReport;
  Issues: TPdfPreflightIssues;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;          // dit pad laadt de PDFium-DLL
    if not Pdf.Active then
      Exit;
    Report := BuildPdfPreflightReport(Pdf, [ppsPdfA]);
    Issues := Report.FilterByCategory('Structure').FlattenIssues;
    for I := 0 to High(Issues) do
      Log.Add(Issues[I].Code + ': ' + Issues[I].Recommendation);
    Report.SaveJsonToFile(ChangeFileExt(FileName, '.preflight.json'));
  finally
    Pdf.Free;
  end;
end;
De twee paden beantwoorden licht verschillende vragen. BuildPdfPreflightReport loopt via TPdf.ValidatePdfA, dat het open document naar een tijdelijke kopie opslaat, op die kopie dezelfde bytescan draait en daarna controles toevoegt die de PDFium-engine nodig hebben, zoals fonts die op een pagina worden gebruikt maar niet zijn ingesloten. ValidatePdfACompliance beoordeelt de exacte bytes op schijf. Voor implementatielimieten is het bytepad op het originele bestand het pad om te vertrouwen: hij rapporteert over het bestand dat u op het punt staat te archiveren, en hij draait in een buildstap of een afgesloten service waar een native DLL niet kan worden uitgerold. Gebruik het rapportpad wanneer u ook de controles op engelniveau wilt en de JSON-, SARIF- of JUnit-uitvoer voor een pijplijn
Waar verder gaan
Deze controles over een map heen draaien, beslissen welke uitkomsten een release blokkeren en het resultaat omzetten in een rapport dat mensen daadwerkelijk lezen, wordt behandeld in de doorloop van PDF/A-preflightvalidatie in Delphi en in de batch-preflightrapport-CLI. Welk PDF/A-deel en welk conformiteitsniveau u in eerste instantie moet nastreven, is het onderwerp van de notities over PDF/A-archiefcompliance; die keuze bepaalt onder meer of de integerlimiet geldt
De hier getoonde validators worden meegeleverd met PDFium Component voor Delphi, C++Builder en Lazarus, naast rendering, het invullen van formulieren en bewerking bovenop de PDFium-engine. De productpagina van PDFium Component lijst de ondersteunde conformiteitsstandaarden, edities en compilerversies op