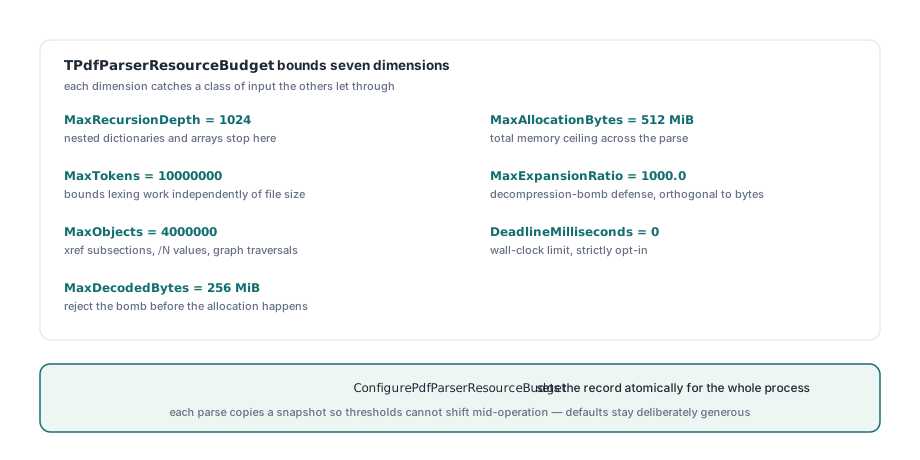
PDFium Component stelt TPdfParserResourceBudget beschikbaar, één record dat recursiediepte, token-aantal, object-aantal, gedecodeerde bytes, expansieratio, allocatie en een wall-clock deadline begrenst voor elke PDF-parser in de bibliotheek. ConfigurePdfParserResourceBudget zet hem atomair voor het proces, en elke parse kopieert een snapshot zodat zijn drempels niet midden in de operatie kunnen verschuiven
Zes parsers, zes private ceilings
De situatie die dit afdwong was alledaags en waarschijnlijk bekend. Sparse xref-traversal had zijn eigen object-ceiling. De stream inspector had zijn eigen gedecodeerde-byte-cap. XMP had er een, XFDF en FDF hadden er nog een, content normalisatie had een derde, en preflight-defaults hadden een vierde. Elk van die getallen was op zichzelf verdedigbaar en geen ervan was van buitenaf bereikbaar, dus een caller die wilde zeggen "dit intake-pad verwerkt anonieme uploads, niets hier mag meer dan 64 MiB alloceren of langer dan vier seconden draaien" had geen plek om dat te zeggen. Het tweede probleem was erger omdat het stil was: waar een limiet wél in een muteerbare global woonde, kon een parse die onder één beleid begon onder een ander eindigen. Eén thread roept een setter aan terwijl een andere halverwege een object stream zit, en de eerste helft van die traversal wordt begrensd door de oude ceiling terwijl de tweede helft door de nieuwe wordt begrensd. Niets crasht, niets logt, en achteraf kun je niet zeggen onder welke limieten de operatie daadwerkelijk draaide, en dat is precies de eigenschap waarvoor je de limieten nodig had
Wat begrenst TPdfParserResourceBudget werkelijk?
Zeven dimensies, gekozen omdat elk ervan een klasse input vangt die de andere doorlaten. MaxRecursionDepth staat standaard op 1024 en stopt dat geneste dictionaries en arrays de ISO 32000-1 §7.3-objectsyntax in een stack overflow veranderen. MaxTokens staat standaard op 10.000.000 en begrenst het lexing-werk onafhankelijk van de bestandsgrootte. MaxObjects staat standaard op 4.000.000 en dekt cross-reference-subsection-aantallen, object-stream-/N-waarden en graaf-traversals. MaxDecodedBytes staat standaard op 256 MiB en MaxAllocationBytes op 512 MiB, zodat een bestand vóór de allocatie kan worden afgewezen in plaats van erna. MaxExpansionRatio staat standaard op 1000.0 en is degene die mensen onderschatten: ISO 32000-1 §7.4-streamfilters zijn general-purpose compressie, een paar kilobytes Flate-data kunnen zich legitiem uitbreiden tot honderden megabytes, en een ratio-ceiling is de standaardverdediging tegen een decompression bomb. Hij staat orthogonaal op de absolute byte-cap, want een 200 KiB-stream die 200 MiB wil worden zit onder de 256 MiB-ceiling en is nog steeds absurd. DeadlineMilliseconds staat standaard op 0, wat geen deadline betekent, dus die dimensie is strikt opt-in. De defaults als set zijn bewust royaal, bedoeld om gewone zakelijke documenten niets te laten omgooien in plaats van een gehard profiel te zijn; als je input van een publiek uploadformulier komt, wil je iets dichter bij de getallen hieronder, naast de regels die in het harden van een Delphi PDF-previewpane worden beschreven
uses
  FPdfPdfCommon;

procedure ApplyUntrustedIntakeBudget;
var
  Budget: TPdfParserResourceBudget;
begin
  Budget := TPdfParserResourceBudget.Default;
  // Defaults behouden: MaxRecursionDepth 1024, MaxTokens 10000000,
  // MaxObjects 4000000
  Budget.MaxDecodedBytes      := Int64(32) * 1024 * 1024;  // standaard 256 MiB
  Budget.MaxAllocationBytes   := Int64(64) * 1024 * 1024;  // standaard 512 MiB
  Budget.MaxExpansionRatio    := 50.0;                     // standaard 1000.0
  Budget.DeadlineMilliseconds := 4000;                     // standaard 0 = uit
  ConfigurePdfParserResourceBudget(Budget);
end;
Waarom een snapshot nemen in plaats van de global lezen?
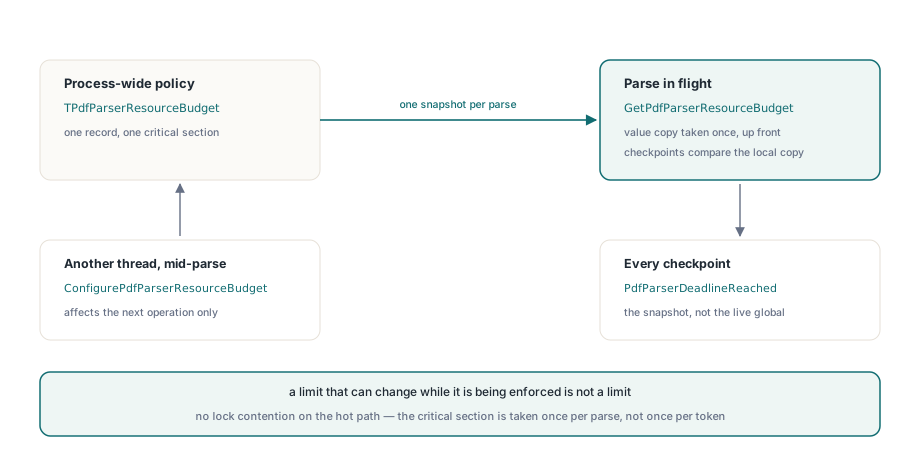
Omdat een limiet die kan veranderen terwijl hij wordt gehandhaafd geen limiet is. Dit is het kernontwerppunt van de hele feature, en het is één regel discipline op elk entry point: lees het beleid één keer aan het begin van de operatie in een lokale TPdfParserResourceBudget, en laat dan elk checkpoint tegen die lokale kopie vergelijken. GetPdfParserResourceBudget neemt de critical section en geeft een waarde-kopie van de record terug, en daarna raakt de parse nooit meer muteerbare globale state aan. Het resultaat is dat een call naar ConfigurePdfParserResourceBudget vanuit een andere thread de volgende operatie beïnvloedt, nooit degene die onderweg is. Gelijktijdige parses draaien zonder interferentie onder verschillende beleidsregels, een operatie die op een resource-limiet faalde, faalde tegen één coherente set drempels, en er is geen lock-contention op het hot path omdat de lock één keer per parse wordt genomen in plaats van één keer per token
type
  TCustomScanState = record
    Budget: TPdfParserResourceBudget;
    StartTick: Cardinal;
    TokenCount: Int64;
    Depth: Integer;
  end;

procedure BeginScan(var S: TCustomScanState);
begin
  S.Budget := GetPdfParserResourceBudget;  // snapshot één keer genomen, vooraf
  S.StartTick := PdfParserStartTick;
  S.TokenCount := 0;
  S.Depth := 0;
end;

function ScanCheckpoint(var S: TCustomScanState): Boolean;
begin
  Result := False;
  if PdfParserDeadlineReached(S.StartTick, S.Budget) then
    Exit;
  Inc(S.TokenCount);
  if S.TokenCount > S.Budget.MaxTokens then
    Exit;
  if S.Depth > S.Budget.MaxRecursionDepth then
    Exit;
  Result := True;
end;
Als je je eigen parser bovenop de bibliotheek schrijft, kopieer dan die vorm in plaats van GetPdfParserResourceBudget binnen je token-loop aan te roepen. Het per token aanroepen is correct maar zinloos: je betaalt bij elke iteratie een critical section en je voert de mid-operatie-drift weer in die de snapshot er juist was om te voorkomen
Waarom stopt een byte-ceiling een pathologisch bestand niet?
Omdat grootte en kosten in PDF maar losjes gerelateerd zijn. Een bestand van 400 KiB met een ISO 32000-1 §7.5.8 cross-reference stream waarvan de /Index- en /W-arrays een aannemelijk maar vijandig entry-aantal beschrijven, een object-stream-keten die dezelfde offsets opnieuw bezoekt, of een content stream van operators die elk meer kosten dan ze lijken, zit comfortabel onder elke byte- en object-ceiling die je instelt en bezet nog steeds een worker thread voor minuten. Byte-aantallen begrenzen geheugen; ze begrenzen geen tijd. Daar zijn PdfParserStartTick en PdfParserDeadlineReached voor. PdfParserStartTick legt een tick-waarde vast aan het begin van de operatie en PdfParserDeadlineReached vergelijkt de verstreken tijd met DeadlineMilliseconds en retourneert False zodra de deadline 0 is. De aftrekking draait in unsigned rekenkunde, dus een rollover van de tick-teller produceert geen valse timeout. Cross-reference-parsing, object-stream-decodering, content token normalisatie en de FDF- en XFDF-readers checken hem allemaal aan hun loop-heads, dus een over-budget-parse stopt bij een checkpoint in plaats van van buitenaf te worden gedood
Twee eerlijke kanttekeningen. Het is wall-clock tijd, geen CPU-tijd, dus een machine die swapt of een buildserver onder belasting kan een deadline laten afgaan die een rustige machine zou halen, wat pleit voor het instellen ruim boven je waargenomen slechtste geval in plaats van dicht bij je mediaan. En hij staat standaard uit, omdat een deadline die bij maandafsluitende batchverwerking op een legitiem groot document afgaat een ergere mislukking is dan degene die hij voorkomt. Kies per intake-pad opt-in in plaats van globaal, en combineer hem met de structurele checks in het valideren van cross-reference streams
Het budget is een ceiling, geen vervanging van formaatlimieten
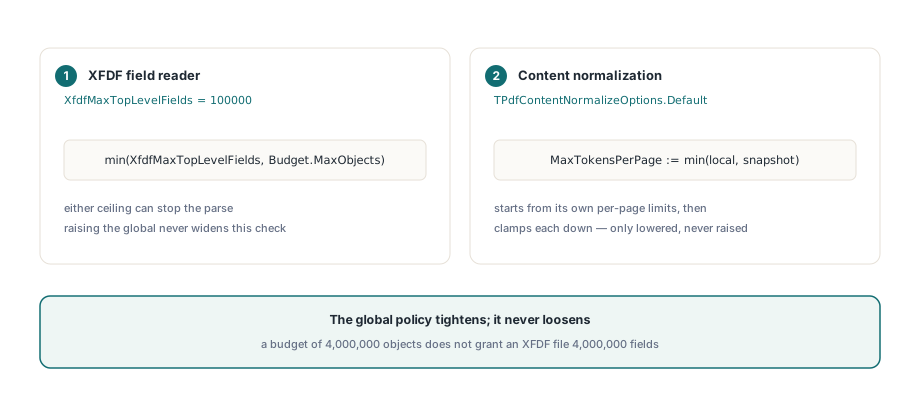
Elke parser houdt zijn eigen formaatspecifieke constanten en past beide toe. XFDF is het duidelijkste voorbeeld: de field reader handhaaft XfdfMaxTopLevelFields en een MaxFieldNodes-constante van 100000 naast de snapshot-waarde, en elk van beide kan de parse stoppen
const
  XfdfMaxTopLevelFields = 100000;   // formaatlokaal, geldt altijd
...
  // Beide ceilings zijn live; de laagste wint
  if (FieldCount >= XfdfMaxTopLevelFields) or
     (FieldCount >= Budget.MaxObjects) then
    Exit(False);
Dat is bewust en het waard om te internaliseren voordat je op zoek gaat naar een knop die niet bestaat. Een globaal budget van 4.000.000 objecten geeft een XFDF-bestand geen 4.000.000 velden, want 100000 velden ligt al ver buiten wat een echte annotatie-export produceert, en een globale ceiling verhogen mag een formaatspecifieke sanity check niet stilletjes verruimen. Content normalisatie werkt hetzelfde vanuit de andere richting: TPdfContentNormalizeOptions.Default start vanuit zijn eigen per-pagina-limieten en klemt ze daarna elk naar beneden naar de snapshot, dus MaxTokensPerPage kan door het budget alleen maar worden verlaagd, nooit verhoogd. Het globale beleid spant aan; het versoepelt nooit
Slechte configuratie faalt wanneer je hem configureert
ConfigurePdfParserResourceBudget valideert vóór hij toewijst. Een niet-positieve waarde in een van de zes numerieke dimensies gooit meteen een exception, en MaxDecodedBytes boven High(Integer) wordt afgewezen als overschrijding van platformlimieten in plaats van stilletjes ergens diep in een decoder te worden afgekapt. Dat ertoe meer dan het klinkt: een budget dat uit een configbestand met een ontbrekende key wordt opgebouwd geeft je nullen, en een nul-object-ceiling die bij het opstarten wordt geaccepteerd verandert drie uur later in een raadselachtige parse-mislukking op het eerste document, op welk punt niemand de config vermoedt. Dezelfde zorg geldt voor elke code die het budget tijdelijk aanspant, inclusief tests. Het beleid is procesbreed, dus een 4-seconden-deadline die na een fixture blijft staan vergiftigt elke latere; save en restore rond de wijziging
var
  Saved: TPdfParserResourceBudget;
begin
  Saved := GetPdfParserResourceBudget;
  try
    ApplyUntrustedIntakeBudget;
    ProcessInboundDocument(FileName);
  finally
    ConfigurePdfParserResourceBudget(Saved);
  end;
end;
ResetPdfParserResourceBudget is de bottere versie, die TPdfParserResourceBudget.Default ronduit herstelt. Gebruik hem in test-teardown waar je een bekende staat wilt, en gebruik save-and-restore in productiecode, waar wat de host-applicatie bij het opstarten heeft geconfigureerd de staat is waarnaar je moet terugkeren
Waar het budget ophoudt te helpen
Het is één procesbreed beleid, en dat is zijn belangrijkste beperking. Je kunt de ene worker thread geen strikt profiel en de andere een permissief geven, want er is één record achter één critical section; als je echt per-tenant-limieten nodig hebt, is de vorm die werkt om elke beleidsklasse op zijn eigen proces te serialiseren, of werk met save-and-restore tussen haakjes en accepteren dat het haakje alleen veilig is wanneer niets anders tegelijk parst. Het begrenst ook parsing, geen rendering: rasterisatiegeheugen, font-cache-groei en image-decodering zitten buiten deze zeven dimensies en hebben hun eigen controles nodig. En een budget vertelt je dat een operatie te duur was, nooit waarom. De ceiling die afging is het symptoom, en de misvormde /Index-array of de weggelopen filterketen erachter moet nog steeds met de hand worden gediagnosticeerd, en daarom is het de moeite waard om het decodeerpad dat in object stream en predictor decodering wordt beschreven te begrijpen voordat je getallen gaat verplaatsen. Behandel het budget als het ding dat voorkomt dat een slecht document het proces met zich mee naar beneden trekt, en houd je logging goed genoeg om te ontdekken wat het document aan het doen was
De volledige parser-API, de budget-record en een source-code build voor Delphi, C++Builder en Lazarus staan op de productpagina: PDFium Component