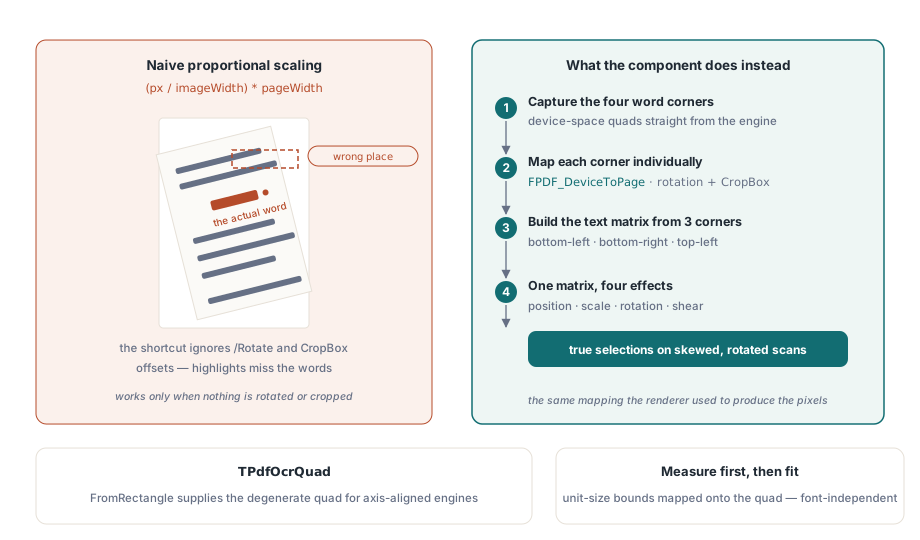
Een zoekactie naar een factuurnummer in een gescande PDF vindt de treffer, maar de markering staat een halve inch links van de gedrukte cijfers en een halve inch eronder. Een halve inch is 36 punt, en de pagina in kwestie heeft een CropBox van [36 36 576 756]. Wie die tekstlaag bouwde, zette pixelposities om in paginaposities door te delen door de bitmapbreedte en te vermenigvuldigen met de paginabreedte, wat veronderstelt dat het zichtbare gebied in de oorsprong begint. Op een pagina met /Rotate 90 doet dezelfde formule het nog slechter: de x-as van de bitmap loopt nu langs de y-as van de pagina, en de woorden belanden volledig in het verkeerde deel van de pagina
Wat een onzichtbare tekstlaag werkelijk is
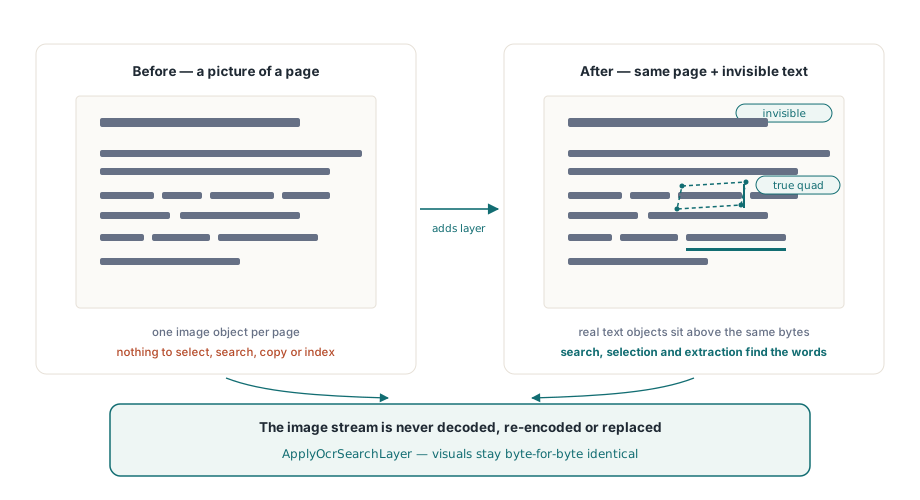
Een gescande pagina is één grote afbeelding die de content stream tekent. Er is niets te selecteren, doorzoeken, kopiëren of indexeren. Een doorzoekbare tekstlaag voegt gewone tekstobjecten bovenop die afbeelding toe en zet hun text rendering mode op 3, wat ISO 32000-1 §9.3.6 (Table 106) definieert als noch fill noch stroke: de glyphs bestaan voor selectie, zoeken en extractie, en een viewer tekent er niets voor. Goed uitgevoerd ziet de lezer de originele scan en vindt Ctrl+F de woorden precies waar ze gedrukt staan
In PDFium Component is de hele klus één aanroep, TPdf.ApplyOcrSearchLayer. De methode rendert elke geselecteerde pagina, geeft de pixels door aan een OCR-provider, filtert de herkende woorden op betrouwbaarheid en schrijft de overlevenden terug als onzichtbare tekstobjecten. De pagina-afbeelding blijft ongemoeid: de scan wordt niet gedecodeerd, opnieuw gecodeerd of vervangen, dus een JBIG2- of CCITT G4-afbeelding behoudt precies de gecomprimeerde bytes waarmee hij binnenkwam. De methode zit in de edities Small Business en Enterprise, dus het project heeft Lib\SmallBusiness op het zoekpad nodig en FPdfSmallBusiness in een uses-clausule; zonder die unit gooit de aanroep EPdfSmallBusinessRequired
Een IPdfOcrProvider schrijven
De herkenning zelf zit achter één interface. IPdfOcrProvider.RecognizePage ontvangt een TPdfOcrImage (paginanummer, breedte, hoogte, stride, DPI, pixelformaat en een TBytes-buffer met top-down BGRA-rijen), plus een cancellation-token, en geeft een array van TPdfOcrWord-records terug: Unicode-tekst, een confidence tussen 0 en 1, en een quad met vier hoekpunten in beeldpixels. De editie levert één kant-en-klare provider mee, CreatePdfTesseractOcrProvider in FPdfOcrTesseract, die koppelt aan een Tesseract-bibliotheek en een traineddata-map die u zelf aanlevert. Elke andere engine, een cloud-API of een commerciële SDK, plugt u aan via een klasse als deze:
uses
  System.SysUtils, PDFium, FPdfAsync, FPdfSmallBusiness;

type
  TMyOcrProvider = class(TInterfacedObject, IPdfOcrProvider)
  public
    function RecognizePage(const Image: TPdfOcrImage;
      const CancellationToken: IPdfCancellationToken;
      out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
  end;

function TMyOcrProvider.RecognizePage(const Image: TPdfOcrImage;
  const CancellationToken: IPdfCancellationToken;
  out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
var
  I, Count: Integer;
begin
  // De Engine*-routines hieronder staan voor uw eigen OCR-enginebinding
  Count := EngineRecognize(Image.Pixels, Image.Width, Image.Height,
    Image.Stride, Image.Dpi);
  CancellationToken.ThrowIfCancelled;   // meld een annulering ook echt als annulering

  SetLength(Words, Count);
  for I := 0 to Count - 1 do
  begin
    Words[I].Text := EngineWordText(I);
    // Veel engines rapporteren 0..100; de laag verwacht 0..1
    Words[I].Confidence := EngineWordConfidence(I) / 100;
    Words[I].Quad := TPdfOcrQuad.FromRectangle(
      EngineLeft(I), EngineTop(I), EngineRight(I), EngineBottom(I));
  end;
  ErrorMessage := '';
  Result := True;
end;
Een provider die Tesseracts 87.5 ongefilterd doorgeeft, krijgt elk woord afgekeurd. Tesseract rapporteert de confidence van een woord bijvoorbeeld als percentage, en de meegeleverde adapter deelt die eerst omlaag voordat hij teruggeeft; een eigen provider moet hetzelfde doen, want ApplyOcrSearchLayer behandelt een confidence boven 1 als ongeldige invoer. Het symptoom is ondubbelzinnig zodra u weet waar u op moet letten: Report.RejectedWordCount is gelijk aan Report.DetectedWordCount en het opgeslagen bestand bevat geen enkele tekst
De token-aanroep is om een andere reden belangrijk. Als de provider een annulering opmerkt en simpelweg False teruggeeft, komt de pagina terecht als popsFailed met welke foutmelding u ook zet. Roept u in plaats daarvan ThrowIfCancelled aan, dan gaat EPdfOperationCancelled omhoog; de laag vangt die af en noteert de pagina als popsCancelled, met Report.Cancelled gezet en de lus gestopt. Binnen een provider is de token nooit nil; geeft de beller geen mee, dan krijgt u een token die nooit annuleert
Quads, en woorden die de laag weigert
Scans staan zelden haaks op de pagina, dus een woord op een licht scheef ingescand vel neemt een parallellogram in beslag. TPdfOcrQuad heeft voor precies dat geval de punten TopLeft, TopRight, BottomRight en BottomLeft, en FromRectangle bouwt de as-uitgelijnde variant voor engines die alleen boxes rapporteren. Een woord wordt overgeslagen en geteld in RejectedWordCount als zijn tekst leeg is of langer dan MaxWordCharacters, als zijn confidence NaN is, onder MinConfidence ligt of boven 1 uitkomt, als een hoekpunt buiten de bitmap valt, of als de quad na het mappen instort tot een splinter smaller dan 0.01 pt
Waarom proportionele schaling OCR-woorden verkeerd plaatst
Proportionele schaling is alleen correct als de pagina geen /Rotate-entry heeft en zijn CropBox in (0, 0) begint. Veel scans voldoen niet aan een van die voorwaarden: een liggend vel wordt vaak opgeslagen als staande pagina met /Rotate gezet, en crop boxes raken verschoven wanneer iemand de marges in een editor bijsnijdt. Het openingsvoorbeeld is de milde variant; met rotatie is de fout geen verschuiving meer maar een verwisselde as
ApplyOcrSearchLayer stuurt elk van de vier hoekpunten door FPDF_DeviceToPage, met dezelfde bitmapgrootte en rotatie die ook de pixels produceerden die de provider te zien kreeg. Rotatie en verschoven crop boxes worden dus afgehandeld door dezelfde transformatie die de renderer gebruikte. Hoekpunten worden onderweg afgerond op hele pixels, wat bij de standaard 300 DPI een kwantisatiestap van 0.24 pt is, ver onder alles wat een selectiemarkering kan tonen
Uit de gemapte punten definiëren de hoekpunten linksonder, rechtsonder en linksboven een affine matrix. Drie punten zijn genoeg om positie, schaal, rotatie en shear uit te drukken, daarom wordt het vierde hoekpunt alleen gevalideerd en nooit voor de fitting gebruikt. Het tekstobject wordt aangemaakt met een fontgrootte van 1, zijn werkelijke bounds worden gemeten, en de matrix mapt die gemeten bounds op de doelquad. Een puntgrootte raden uit de quadhoogte zou met de ascent en descent van elk lettertype meedrijven; eerst meten maakt de pasvorm onafhankelijk van het lettertype dat Options.FontName noemt
Het lettertype doet er voor de extractie nog toe, ook al wordt er niets getekend. TPdfOcrOptions.Default zet het op Arial. Laadt dat lettertype niet, dan valt de laag terug op de standaard Helvetica, een van de 14 standaardlettertypen, waarvan de ingebouwde tekencodering alleen Latijnse tekst dekt. Voor Cyrillische, Griekse of CJK-uitvoer zet u FontName op een geïnstalleerd lettertype dat dat schrift dekt
De laag draaien en het rapport lezen
ApplyOcrSearchLayer geeft alleen True terug als geen enkele pagina mislukte en er niets geannuleerd werd. Die teruggeefwaarde is het verkeerde ijkpunt om de opslag op te baseren. Met ContinueOnError op de standaardwaarde True geeft een klus van 300 pagina's met één onleesbare pagina False terug terwijl 299 pagina's een correcte laag dragen, en de mislukte pagina is al teruggezet in zijn oude staat. Baseer de opslag in plaats daarvan op het rapport:
var
  Pdf: TPdf;
  Options: TPdfOcrOptions;
  Report: TPdfOcrReport;
  Cancel: IPdfCancellationTokenSource;
  I: Integer;
begin
  Cancel := TPdfCancellationTokenSource.New;  // houd hem binnen bereik van een Cancel-knop
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'scanned-contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfOcrOptions.Default;      // 300 DPI, MinConfidence 0.5, Arial
    Options.MinConfidence := 0.6;
    Options.MaxTotalPixels := Int64(4000) * 1000 * 1000;

    Pdf.ApplyOcrSearchLayer(TMyOcrProvider.Create, Options, Report,
      Cancel.Token);

    for I := 0 to High(Report.Pages) do
      if Report.Pages[I].Status = popsFailed then
        Writeln(Format('page %d failed: %s',
          [Report.Pages[I].PageNumber, Report.Pages[I].ErrorMessage]));
    Writeln(Format('%d inserted, %d rejected, %d skipped, %d failed',
      [Report.InsertedWordCount, Report.RejectedWordCount,
       Report.SkippedPageCount, Report.FailedPageCount]));

    if not Report.Cancelled and (Report.InsertedWordCount > 0) then
      Pdf.SaveAs('scanned-contract-searchable.pdf');
  finally
    Pdf.Free;
  end;
end;
Niet opslaan na een annulering is een afweging, en dit is de afweging die hier gemaakt is. Een geannuleerde klus laat een bestand achter dat in het eerste deel doorzoekbaar is en in de rest leeg, en niets in de PDF vertelt de volgende lezer waar de laag ophoudt. Het hele document later opnieuw draaien is goedkoper dan een half geïndexeerd archief moeten uitleggen
SkipPagesWithText staat standaard op True en controleert of de pagina al extraheerbare tekens oplevert. Dat houdt born-digital-pagina's buiten de OCR, voorkomt een tweede laag op bestanden die eerder verwerkt zijn, en maakt een herhaalde run over dezelfde uitvoer een no-op. De keerzijde is dat één echt teken al telt: een scan met een Bates-nummer dat als echte tekst is gestempeld, wordt gemeld als popsSkippedExistingText en krijgt geen laag. Archieven die zo zijn opgebouwd hebben SkipPagesWithText := False en een zorgvuldig paginabereik via FirstPage en LastPage nodig, anders krijgen eerder verwerkte pagina's een dubbele laag en geeft extractie elk woord tweemaal terug
Pixelbudgetten, annulering en per-pagina-rollback
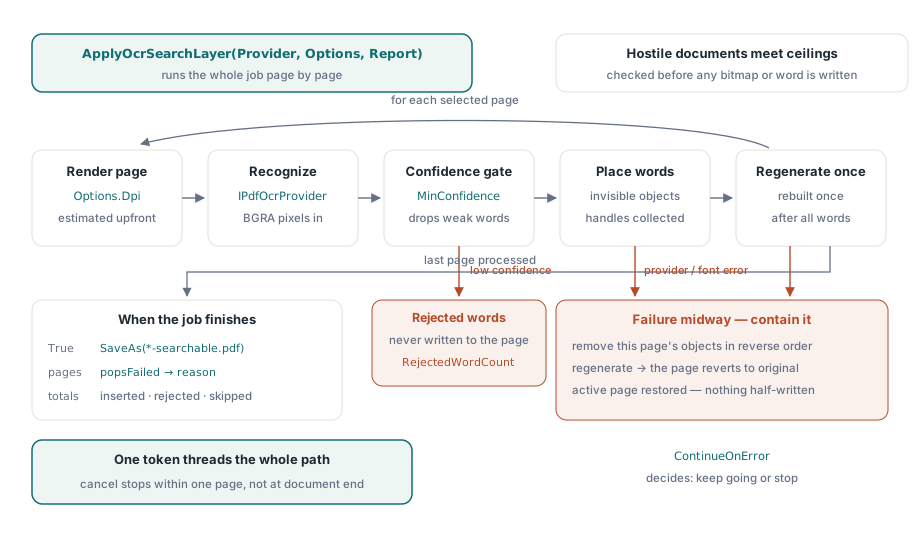
Elke grootheid die een vijandig of gewoon enorm document kan opblazen, heeft een plafond in TPdfOcrOptions, en de pixelcontroles draaien voordat er ook maar één bitmap wordt toegewezen. De rendergrootte is Ceil(PageWidth * Dpi / 72) bij Ceil(PageHeight * Dpi / 72), dus de cijfers laten zich vooraf uitrekenen:
| Pagina bij 300 DPI | Bitmap | Pixels |
|---|---|---|
| US Letter, 612 × 792 pt | 2550 × 3300 | 8.415.000 |
| A4, 595 × 842 pt | 2480 × 3509 | 8.702.320 |
| A3, 842 × 1191 pt | 3509 × 4963 | 17.415.167 |
| A0, 2384 × 3370 pt | 9934 × 14042 | 139.493.228 |
De standaardwaarden zijn 100 miljoen pixels per pagina en 1 miljard voor de hele klus. Een A0-tekening bij 300 DPI overschrijdt MaxPixelsPerPage dus al op zichzelf. Het klusbrede budget raakt eerder op dan het per-pagina-budget: bij 8.415.000 pixels per Letter-pagina passen 118 pagina's onder 1 miljard en mislukt pagina 119 met een melding die MaxTotalPixels noemt, en daarna elke pagina. Verhoog voor lange gescande archieven MaxTotalPixels zoals het voorbeeld hierboven doet, of splits het werk op in bereiken met FirstPage en LastPage. Overgeslagen pagina's worden nooit gerenderd en tellen niet mee. De meegeleverde Tesseract-adapter voegt een eigen limiet toe, TPdfTesseractOptions.MaxPixels, die standaard op 16.777.216 staat; een A3-vel bij 300 DPI zit net daarboven, dus A3-batches hebben een verhoogde adapterlimiet of een lagere DPI nodig
DPI moet tussen 36 en 1200 liggen. Een verdubbeling van 300 naar 600 verviervoudigt de bitmap, en elke pixel kost 4 bytes, dus een Letter-pagina gaat van zo'n 34 MB BGRA naar zo'n 135 MB. Voor gewone kantoorscans balanceert 300 DPI herkenningskwaliteit tegen geheugen; 600 is het waard voor kleine afdrukken en voetnoten, niet voor hele archieven. Woordaantallen zijn begrensd door MaxWordsPerPage en MaxTotalWords, en een provider die meer woorden teruggeeft dan de pagina toelaat, laat die pagina mislukken in plaats van zelf afgekapt te worden
Het cancellation-token bereikt de progressieve render, de provider-aanroep en de lus die woorden inserteert. Annuleren tijdens de herkenning van pagina 212 van een bestand met 400 pagina's stopt op pagina 212, mits de provider het token honoreert dat hij meekreeg. De Tesseract-adapter gaat een stap verder en registreert een cancel-callback bij de engine, naast een timeout per pagina die standaard op 60.000 ms staat
Inperking gebeurt per pagina. De laag onthoudt de handle van elk tekstobject dat hij inserteert en roept FPDFPage_GenerateContent één keer aan, nadat het laatste woord op die pagina is geplaatst. Faalt er onderweg iets — een lettertype dat een teken weigert, of een annulering die halverwege de lus binnenkomt — dan worden de al geplaatste objecten van die pagina in omgekeerde volgorde verwijderd en wordt de pagina-inhoud opnieuw gegenereerd, zodat de pagina weer alleen draagt wat hij al had. De lus gaat daarna door of stopt volgens ContinueOnError, en de pagina die vóór de aanroep actief was, is daarna weer actief
Het resultaat controleren
Twee controles dekken het meeste wat mis kan gaan. De eerste is visueel: render één pagina uit het originele bestand en dezelfde pagina uit het verwerkte bestand op dezelfde grootte met TPdf.RenderPage, en vergelijk de bitmaps. Verwachting: identiek, want modus 3 tekent niets en de image stream is ongemoeid gebleven; elk pixelverschil betekent dat iets anders dan de tekstlaag de pagina heeft veranderd. De tweede controleert dat de woorden bestaan en liggen waar de scan ze toont:
procedure CheckOcrPage(Pdf: TPdf; PageNo: Integer; const Probe: WString);
const
  TEXT_MODE_INVISIBLE = 3;   // FPDF_TEXTRENDERMODE_INVISIBLE
var
  TextObjects: TPdfIntegerArray;
  I, Invisible, Hit: Integer;
  Box: TPdfRectangle;
begin
  Pdf.PageNumber := PageNo;
  TextObjects := Pdf.GetObjectsByType(otText);
  Invisible := 0;
  for I := 0 to High(TextObjects) do
    if Pdf.GetTextRenderMode(TextObjects[I]) = TEXT_MODE_INVISIBLE then
      Inc(Invisible);
  Writeln(Format('page %d: %d invisible text objects', [PageNo, Invisible]));

  Hit := Pdf.FindFirst(Probe);
  if Hit >= 0 then
  begin
    Box := Pdf.CharacterRectangle[Hit];
    Writeln(Format('"%s" starts at x=%.1f, y=%.1f pt',
      [Probe, Box.Left, Box.Bottom]));
  end;
end;
Kies een proefwoord dat u op de scan met het oog kunt vinden, een kop of een totaal, en leg de gerapporteerde coördinaten naast zijn positie in een gerenderde afbeelding. Op de CropBox-pagina uit de opening moet de x-waarde op 36 of hoger beginnen, nooit bijna nul. De extractiekant wordt uitgebreider behandeld in tekst uit PDF-documenten extraheren, het renderen van pagina's voor een uitlijningsoverlay in PDF-pagina's naar JPEG converteren, en het tokenpatroon dat overal doorloopt in annuleerbare progressieve rendering
OCR-laagvorming staat naast rendering, tekstextractie en paginabewerking op hetzelfde TPdf-object, in Delphi, C++Builder en Lazarus. Edities en de volledige API-lijst staan op de productpagina van PDFium Component for Delphi