Met overflowcontrole uit evalueert 2000000000 + 2000000000 naar -294.967.296 als beide operanden Delphi Integer-waarden zijn. Dat getal houdt op triviaheden te zijn op het moment dat een containerparser een offset en een lengte uit een recordheader leest en ze optelt om te zien of een ingebedde PDF in de buffer past. De som slaat negatief om, de vergelijking tegen Length(Data) passeert, en de volgende regel neemt het adres van een byte van ruwweg twee gigabyte voorbij het einde van de array. Een PDF uit het midden van een grotere buffer laden vraagt een grenscontrole die nooit optelt, en een duidelijk antwoord op de vraag wie de bytes bezit zodra het document open is
Dit artikel behandelt documenten die al in het RAM staan, op een bekende offset binnen iets anders. Documenten die te groot zijn om in het geheugen te houden zijn een ander probleem, opgelost door op dem-and blokken van schijf te halen zoals beschreven in grote PDF's on-demand streamen met PDFium VCL. De laatste sectie trekt de grens
Een ingebedde PDF op een bekende offset
Een mailopslag bewaart berichtteksten en bijlagen in één record. Een archiefcontainer plakt een manifest, een paar images en een PDF aaneen. Een custom wire-protocol kadert een document in achter een header met lengteprefix. Stel dat het record 40 MB is, de PDF begint op byte 1.182.336 en 312 KB doorloopt. De gewoontecode roept Copy(Data, Index, Count) aan om een plak te snijden, en geeft die plak dan aan een lader die hem opnieuw kopieert in zijn eigen buffer. Container meegerekend bestaat dezelfde 312 KB nu drie keer, en een mailboxscan herhaalt dat voor elk bericht
PDFium Component adresseert het venster direct. TPdf declareert LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean = True), waarbij Index een nulgebaseerde bytepositie is en Count een bytelengte. De methode valideert beide getallen, berekent één pointer en delegeert naar de pointeroverload LoadDocument(Data: Pointer; Size: NativeUInt; Buffered: Boolean), die het document opent via FPDF_LoadMemDocument64. De hele-array-vorm LoadDocument(const Data: TBytes; Buffered: Boolean) is een eenregelige aanroep naar de byte-range-vorm met 0 en Length(Data), dus elke TBytes-load passeert dezelfde validatie
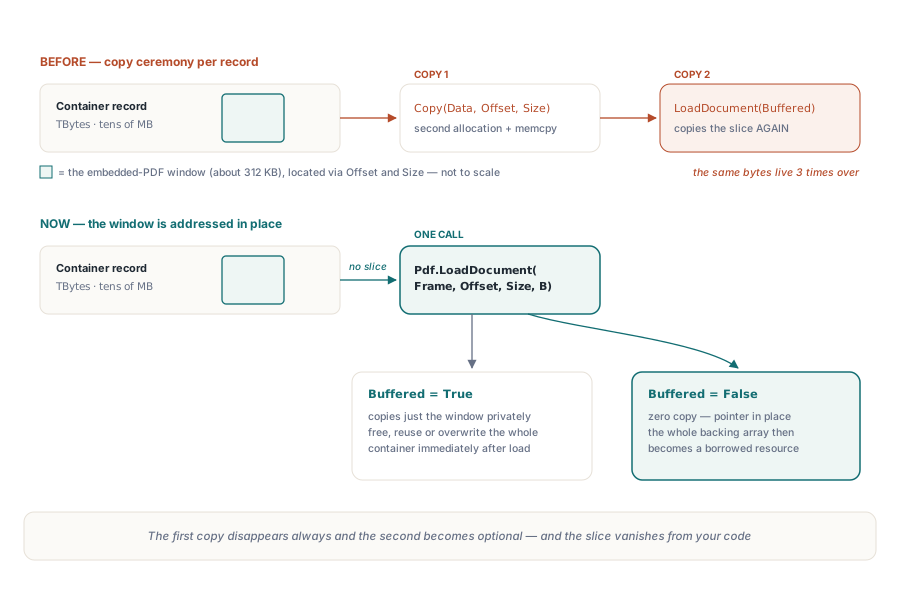
In code verdwijnt de plak gewoon. LocateEmbeddedPdf staat voor je eigen containerparser
uses
  System.SysUtils, System.IOUtils, PDFium;

procedure PreviewEmbedded(const RecordFile: string);
var
  Frame: TBytes;           // hele containerrecord, tientallen megabytes
  Offset, Size: Integer;
  Pdf: TPdf;
begin
  Frame := TFile.ReadAllBytes(RecordFile);
  LocateEmbeddedPdf(Frame, Offset, Size);   // je parser, geen deel van het component

  Pdf := TPdf.Create(nil);
  try
    // geen Copy(Frame, Offset, Size): het venster wordt ter plekke geadresseerd
    Pdf.LoadDocument(Frame, Offset, Size);  // Buffered staat standaard op True
    Frame := nil;  // prima hier: alleen het PDF-venster werd gekopieerd
    Writeln('Pages: ', Pdf.PageCount);
  finally
    Pdf.Free;      // sluit het document
  end;
end;
Als de globale EnableV8Engine nog False is en de PDFium-library nog niet is geladen, scannen de geheugenladers de binnenkomende bytes op XFA-markers en zetten EnableV8Engine aan wanneer ze er vinden, zodat de V8-capabele DLL wordt geladen. Bij de byte-range-aanroep ziet die scan alleen het venster. Een manifest of een tweede document elders in hetzelfde record kan hem niet triggeren
Waarom laat Index plus Count de grenscontrole omslaan?
Omdat Index en Count allebei 32-bit signed Integer-waarden zijn, en het optellen van twee grote positieve waarden niet betrouwbaar een groot positief resultaat oplevert. Waar de offset en lengte uit een bestandsheader komen, bepalen een aanvaller of een gecorrupt record allebei. Dezelfde valkuil loert in je eigen containerparser, die die getallen eerst berekent
// een helper voor je eigen containerparser (voorgesteld, geen deel van het component)
function IsValidWindow(const Data: TBytes; Index, Count: Integer): Boolean;
begin
  // FOUT: Index + Count wordt geëvalueerd als Integer en kan negatief omslaan
  //   Result := (Index >= 0) and (Index + Count <= Length(Data));

  // GOED: verwerp tekens, begrens Index op zichzelf, vergelijk daarna Count
  // met het restant; de enige rekenkunde is een aftrekking die niet kan omslaan
  Result := (Index >= 0) and (Count >= 0) and
            (Index <= Length(Data)) and
            (Count <= Length(Data) - Index);
end;
Werk het falende geval door. Met Index = 2000000000 en Count = 2000000000 is de ware som vier miljard, maar 32-bit signed rekenkunde slaat hem op als -294.967.296. Die waarde zit ruim onder elke Length(Data), dus de verkeerde controle passeert en @Data[Index] wijst ver buiten de array, met een lengte van twee gigabyte eraan vast. Een crash is de goede afloop. De slechte is PDFium die het procesgeheugen dat daar toevallig woont gaat parsen
De correcte volgorde telt nooit op. Negatieve waarden worden geweigerd voordat er iets wordt geïndexeerd. Daarna wordt Index op zichzelf begrensd tegen Length(Data), wat garandeert dat Length(Data) - Index een niet-negatieve Integer is, en pas dan wordt Count vergeleken met dat restant. Delphi evalueert and standaard met short-circuit-logica ({$B-}), dus elke latere term draait pas als de eerdere kloppen. Leun niet op {$Q+} als vangnet: releasebuilds worden routineus verzonden met overflowcontrole uit, en met hem aan heb je alleen een geheugenveiligheidsgat ingeruild voor een EIntOverflow die uit het midden van een validatieroutine ontsnapt
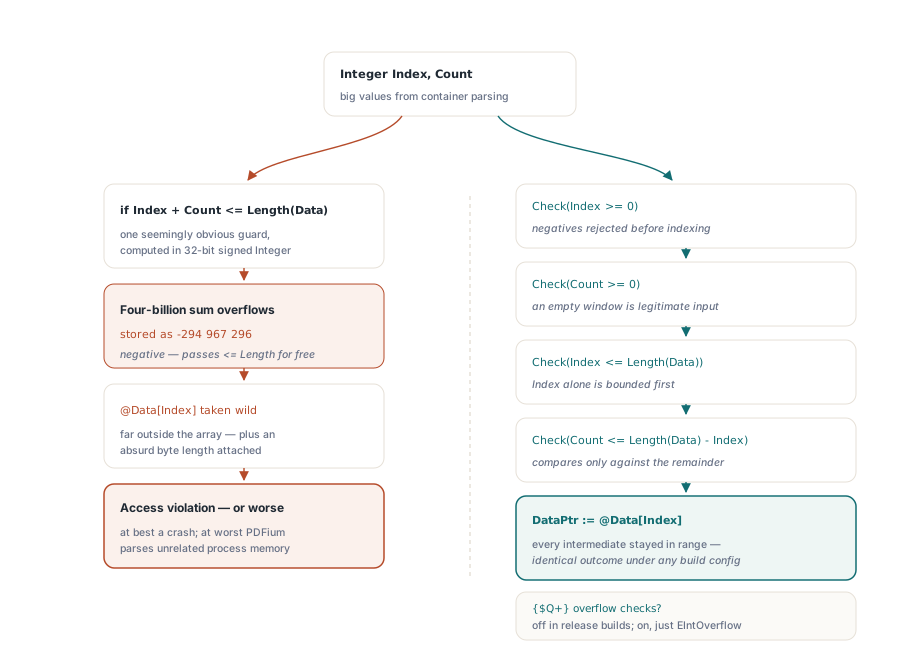
De byte-range LoadDocument draait dezelfde vier tests in dezelfde volgorde en geeft EPdfError met een melding die de gefaalde regel benoemt: "PDF byte range index cannot be negative", "PDF byte range count cannot be negative", "PDF byte range index exceeds data length" en "PDF byte range exceeds data length". Je kunt elk ervan reproduceren met een array van vier bytes. Index = 5, Count = 0 triggert de derde melding, Index = 2, Count = 3 de vierde, en na elke weigering is Pdf.Active nog False. Dezelfde behandeling van onbetrouwbare lengtes over de native grens wordt breder behandeld in het hardenen van de PDFium VCL ABI en geheugenveiligheid in Delphi
Een venster met lengte nul is nog steeds een legale aanroep
Een leeg venster geeft een nil-pointer door, want @Data[Index] is geen legale expressie voor elke Index die de validatie accepteert. Index = Length(Data) met Count = 0 is een welgevormd leeg venster aan de staart van de buffer, en een lege TBytes geeft Index = 0 op een array die helemaal geen element nul heeft. Het adres nemen leest in beide gevallen voorbij het einde of dereferentieert een nil dynamische array, en met range checking aan geeft Delphi ERangeError voordat de lader überhaupt draait
Dus de byte-range-overload vertakt: Count = 0 levert nil op, elke andere count levert @Data[Index] op. De pointeroverload accepteert nil alleen samen met een grootte van nul, PDFium weigert dan een lege buffer te openen, en de aanroep eindigt in een gewone EPdfError met de last-error-tekst van PDFium, of "Cannot load PDF document" wanneer PDFium niets meldt. Een header die een bijlage van nul bytes claimt krijgt dezelfde opvangbare exception als elke andere slechte invoer. Hem in je parser weigeren, met het recordnummer in de melding, leest in een supportlog nog steeds beter
Buffered bepaalt wie de bytes bezit
Buffered is hier de enige parameter wiens gevolgen de aanroep overleven. Met Buffered = True kopieert het component het geselecteerde venster, en alleen het venster, naar zijn eigen buffer voordat hij laadt. In het voorbeeld van 40 MB worden 312 KB gekopieerd en blijft de container met rust. Zodra LoadDocument terugkeert, mag je de container onmiddellijk vrijgeven, hergebruiken of overschrijven
Met Buffered = False gaat @Data[Index] rechtstreeks naar FPDF_LoadMemDocument64, en PDFium blijft via die pointer lezen zolang het document open is. De hele onderliggende TBytes wordt geleend. Ze moet in leven en ongewijzigd blijven totdat je Active := False zet of de TPdf vrijgeeft. De hele array telt, niet alleen het venster: een Delphi dynamische array is reference counted als één blok, dus de laatste referentie laten vallen waar dan ook in je code geeft het geheugen vrij dat PDFium nog leest. SetLength is net zo fataal. Een reallocatie kan het blok verplaatsen
Twee Delphi-details maken dit makkelijker fout te doen dan het eruitziet. Dynamische arrays hebben geen copy-on-write, in tegenstelling tot strings, dus Other := FFrame; Other[0] := 0; schrijft in de bytes die PDFium op dat moment parsen. En een ontvangbuffer die je netwerkcode hergebruikt voor het volgende frame wordt onder het open document overschreven. Een functieresultaat rechtstreeks doorgeven, als in Pdf.LoadDocument(ReadRecord(Id), Offset, Size, False), laat de array vastgehouden door alleen een verborgen tijdelijke die sterft met de aanroepende routine, terwijl het document blijft bestaan
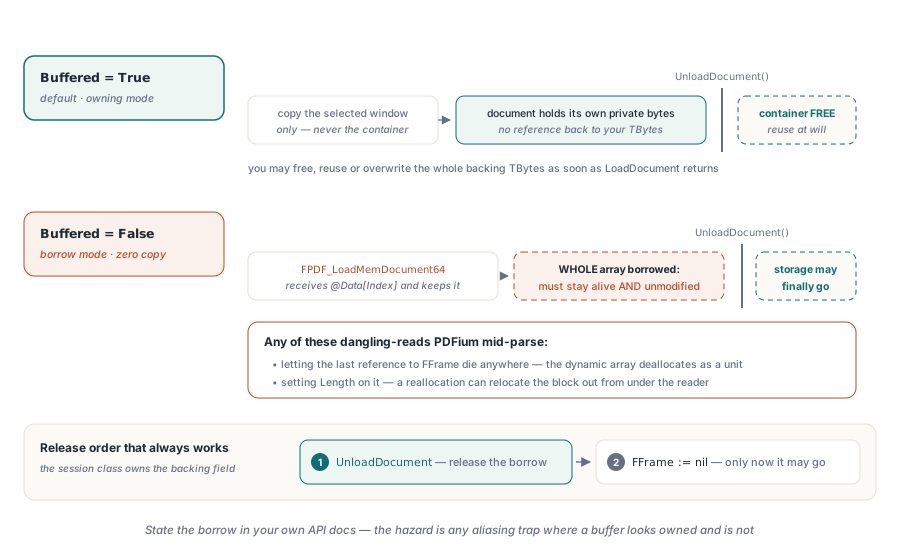
Houd Buffered = True voor alles wat een thread passeert, achter een herbruikbare buffer zit, of de routine die hem laadt overleeft. De extra kost is één kopie van de eigen grootte van de PDF, en die koopt de vrijheid om een record van 40 MB los te laten op het moment dat de aanroep terugkeert. Lenen verdient zijn plek alleen wanneer de container al een langlevend veld is dat je toch de hele sessie vasthoudt, zoals een viewer die een archiefrecord openhoudt terwijl de gebruiker door de bijlage bladert. Maak in dat geval het eigendom expliciet in één class
type
  TFrameSession = class
  private
    FFrame: TBytes;   // is eigenaar van de onderliggende opslag zolang FPdf een document open heeft
    FPdf: TPdf;
  public
    constructor Create(const AFrame: TBytes);
    destructor Destroy; override;
    procedure OpenEmbedded(Offset, Size: Integer);
  end;

constructor TFrameSession.Create(const AFrame: TBytes);
begin
  inherited Create;
  FFrame := AFrame;   // deelt de array; niemand anders mag er nu naar schrijven
  FPdf := TPdf.Create(nil);
end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  FPdf.Active := False;                            // sluit eerst een eventueel eerder venster
  FPdf.LoadDocument(FFrame, Offset, Size, False);  // FFrame moet dit document overleven
end;

destructor TFrameSession.Destroy;
begin
  FPdf.Active := False;  // 1. geef de lening vrij
  FPdf.Free;
  FFrame := nil;         // 2. pas nu mag de opslag weg
  inherited;
end;
De constructor deelt de array van de aanroeper in plaats van hem te kopiëren, dus de aanroeper moet ermee stoppen er naar te schrijven. Kun je dat niet beloven, geef dan Copy(AFrame) door aan de constructor en je bent terug bij één kopie, eenmaal per sessie in plaats van eenmaal per load
Controleren dat het venster op %PDF- begint
Een venster dat een paar bytes ernaast zit is de subtiele mislukking, want het document kan nog gewoon openen. ISO 32000-1 §7.5.4 definieert elke cross-reference-entry als een byteoffset vanaf het begin van het bestand, en §7.5.2 zet de %PDF--header aan het begin. Telt je parser een prefix verkeerd en begint het venster acht bytes te vroeg, dan zitten die offsets er acht bytes naast. PDFium zoekt de header binnen de eerste 1024 bytes en compenseert voorlopende rommel; een venster dat te laat begint of te vroeg eindigt kan hem ertoe drijven de cross-reference-tabel te herbouwen uit de objectmarkers die hij vindt. Hoe dan ook oogt het paginaaantal kloppend. De offset in je parser is nog steeds fout, en de volgende lezer van dat record is misschien minder vergevingsgezind
De overload LoadDocument(const Data: TBytes; Index, Count: Integer; const Options: TPdfLoadOptions; out Report: TPdfLoadReport; Buffered: Boolean = True) maakt dat zichtbaar. Report.HeaderOffset is waar %PDF- werd gevonden binnen de eerste 1024 bytes van het venster, of -1 wanneer hij niet werd gevonden. Report.UsedRecovery is True wanneer PDFium de cross-reference-tabel niet als geldig accepteerde. Alle offsets in het rapport tellen vanaf de eerste byte van het venster, niet vanaf de container. Een Count die te kort is snijdt de afsluitende %%EOF af, en TPdfLoadOptions.Default(plmStrict) zet RequireFinalEndOfFileMarker aan, dus de strikte modus weigert dat venster ronduit
var
  Options: TPdfLoadOptions;
  Report: TPdfLoadReport;
begin
  Options := TPdfLoadOptions.Default;   // plmCompatible
  Pdf.LoadDocument(Frame, Offset, Size, Options, Report, True);

  // LogWarning is je eigen logroutine
  if Report.HeaderOffset > 0 then
    LogWarning(Format('Window starts %d bytes before %%PDF-, check Offset',
      [Report.HeaderOffset]))
  else if Report.HeaderOffset < 0 then
    LogWarning('No %PDF- header in the first 1024 bytes of the window');

  if Report.UsedRecovery then
    LogWarning('Cross-reference table was rebuilt, check Offset and Size');
end;
De audit achter die velden heeft een kost die ertoe doet bij geleende loads. Past het venster binnen Options.AuditByteLimit (standaard 256 MB), dan leest de audit een tijdelijke kopie van het venster, dus Buffered = False gecombineerd met een rapport is tijdens de load niet langer kopievrij. AuditByteLimit op 0 zetten slaat de audit en de kopie over en laat HeaderOffset op -1. Draai de geauditeerde vorm terwijl je de containerparser ontwikkelt en tegen nieuwe bronnen van records; schakel over op de kale overload zodra de offsets worden vertrouwd. De rest van het rapport wordt behandeld in PDF-laadfouten opvangen met een PDFium load report
Wanneer een byte range het verkeerde gereedschap is
De byte-range-overload veronderstelt dat de hele container al in het geheugen staat, en omdat Count een Integer is, kan één venster niet voorbij MaxInt bytes gaan. Een archief van 6 GB op schijf, of een socket die je niet kunt terugspoelen, past niet in die vorm, en alles in TBytes lezen alleen om een venster erin te adressen verslaat het doel. Voor die gevallen laat LoadCustomDocument(AStream: TStream; AOwnsStream: Boolean) PDFium blokken uit een seekable stream op dem-and halen. Een kleine TStream-afstammeling van eigen makkelij die de startoffset van de PDF bij elke Seek optelt, presenteert het ingebedde document alsof hij op positie nul begint, zoals het artikel over on-demand streaming laat zien
De andere mismatch is content die nog geen kale PDF is. Zijn de ingebedde bytes gecomprimeerd, door de container versleuteld, of gewikkeld in een andere codering, dan is een getransformeerde kopie onvermijdelijk, en die nieuwe array laden met de default Buffered = True is het eerlijke antwoord. De byte range betaalt zich uit in één vorm: aaneengesloten, ongewijzigde PDF-bytes, al resident, op een offset die je parser heeft gevalideerd zonder op te tellen
De byte-range-aanroep staat naast bestand-, stream-, ruwe-pointer- en on-demand-lading in hetzelfde TPdf-component. De productpagina van PDFium Component somt de ondersteunde Delphi- en C++Builder-versies, licentieopties en de rest van de laad-API op