Een merge-loop die bij elke aanroep 1 als invoegpositie doorgeeft produceert een bestand met het juiste aantal pagina's en de documenten in omgekeerde volgorde. Het laatste bestand in de lijst belandt op pagina 1, want positie 1 betekent "invoegen vóór de huidige eerste pagina", en elke nieuwe bron duwt de eerdere verder naar achteren. Er gaat niets verloren, en dat is precies waarom de fout een snelle paginatelling overleeft en pas opduikt wanneer iemand de bundel echt leest
De pagina-voor-pagina-loop met ImportPages
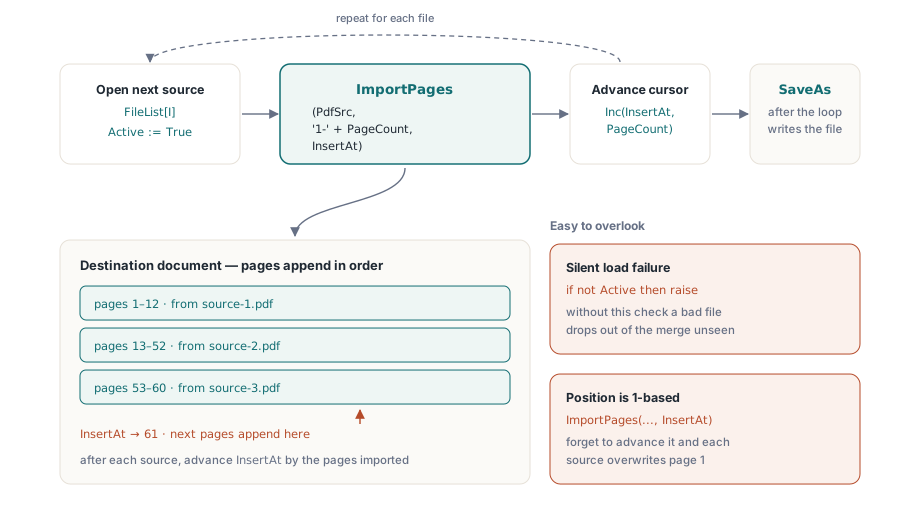
PDFium Component bouwt een samengevoegde PDF in Delphi vanuit twee TPdf-instanties: één bestemming die leeg wordt aangemaakt met CreateDocument, en één bron die elke invoer opent. TPdf.ImportPages(Pdf, Range, PageNumber) kopieert de in Range genoemde pagina's van Pdf naar de bestemming en geeft True terug bij succes. PageNumber telt vanaf 1 en default op 1. Hij noemt de bestemmingspositie waar de eerste geïmporteerde pagina belandt, dus 1 plakt vooraan en PageCount + 1 plakt achteraan
De netste manier om bestanden in lijstvolgorde te houden is het bijhouden van een cursor helemaal los te laten en de bestemming te vragen waar zijn einde zit. Een lopende InsertAt-teller kan ook, maar die moet worden opgeschoven met het aantal werkelijk geïmporteerde pagina's, en dat aantal gaat zodra bereiken meespelen snel mis. PdfDest.PageCount + 1 is altijd goed:
procedure MergeFileList(const FileList: TStrings; const OutputPath: string);
var
  PdfDest, PdfSrc: TPdf;
  I: Integer;
begin
  PdfDest := TPdf.Create(nil);
  PdfSrc  := TPdf.Create(nil);
  try
    PdfDest.CreateDocument;
    for I := 0 to FileList.Count - 1 do
    begin
      PdfSrc.FileName := FileList[I];
      PdfSrc.Active   := True;            // gooit niet bij mislukking
      if not PdfSrc.Active then
        raise Exception.CreateFmt('Cannot open %s', [FileList[I]]);

      // positie vanaf 1: PageCount + 1 plakt na de laatste pagina
      if not PdfDest.ImportPages(PdfSrc,
        '1-' + IntToStr(PdfSrc.PageCount), PdfDest.PageCount + 1) then
        raise Exception.CreateFmt('Page import failed for %s', [FileList[I]]);

      PdfSrc.Active := False;             // FileName kan alleen wijzigen terwijl hij inactief is
    end;

    if not PdfDest.SaveAs(OutputPath) then
      raise Exception.Create('Cannot write ' + OutputPath);
  finally
    PdfSrc.Free;
    PdfDest.Free;
  end;
end;
Twee controles in die loop wegen echt. Active := True zetten gooit nooit: als het bestand ontbreekt, beschadigd is of een wachtwoord nodig heeft, vangt TPdf de laadfout op en laat Active op False staan. De component blijft in een consistente gesloten toestand en een formulier crasht niet op een slecht bestand. Een merge-loop die de controle overslaat produceert simpelweg een kortere uitvoer. De tweede controle is het Boolean-resultaat van ImportPages, dat False terugkomt wanneer de bereikstring niet parset of de positie voorbij PageCount + 1 ligt. Merk ook op dat FileName en Password alleen toegewezen kunnen worden terwijl de component inactief is, en dat de bron daarom onderaan elke ronde wordt gesloten
Bereikstrings: wat de parser accepteert
Het bereikargument is een kommagescheiden lijst van losse pagina's en gesloten bereiken, genummerd vanaf 1 in het brondocument. '1-3' neemt de eerste drie pagina's, '2,4,6' neemt drie specifieke, en '1,3-5' neemt een omslag plus een samenvatting van drie pagina's. De getallen verwijzen altijd naar de bron; waar die pagina's in de bestemming belanden wordt alleen door het positieargument bepaald
Open-eindige bereiken zijn waar mensen struikelen. Een string als '7-' lijkt op "pagina 7 tot het einde", maar de PDFium-bereikparser eist beide uiteinden van een bereik en wijst de hele string af. Hetzelfde gebeurt bij een omgekeerd bereik ('5-3'), een paginanummer 0, of elke pagina voorbij het paginatotaal van de bron. Eén slecht item laat de hele aanroep falen: ImportPages geeft False terug en er wordt geen enkele pagina uit die string gekopieerd. Daarom bouwt de loop hierboven '1-' + IntToStr(PdfSrc.PageCount) in plaats van '1-' te schrijven
Houd je pagina-indexen al in een array, dan slaat ImportPagesByIndex(Source, PageIndices, InsertAt) de stap met de string over. Let wel op de conventie die wisselt: zowel de indexen als InsertAt zijn daar nulgebaseerd, dus toevoegen is InsertAt = PdfDest.PageCount en de omslag-plus-samenvatting-selectie wordt [0, 2, 3, 4]. Een lege array doorgeven importeert elke pagina
Bestaat er een merge in één aanroep voor een lijst bestanden?
Ja. TPdf.MergeFiles(Sources, Options, Report) neemt een array van TPdfBatchMergeSource-records, elk gebouwd met TPdfBatchMergeSource.FromFile(FileName, PageRange, Password), opent ze één voor één en vult een TPdfBatchMergeReport met wat er gebeurde. Een lege PageRange betekent elke pagina. De bereiksyntax is hetzelfde komma-en-bereikformaat, en een misvormd bereik wordt een fout per bestand in het rapport in plaats van een stille overslag
De defaults van TPdfBatchMergeOptions.Default zijn het kennen voordat je er één aanpast. CreateDestination staat op True, dus een inactieve bestemming wordt voor je aangemaakt. InsertAt staat op -1, wat toevoegen betekent; elke andere waarde is een nulgebaseerde index, zoals bij ImportPagesByIndex en niet zoals bij ImportPages. ErrorPolicy staat op bmepStop en RollbackOnCancelOrFailure op True, dus één onleesbaar bestand beëindigt de run en haalt elke pagina weg die de run had toegevoegd. CopyViewerPreferences kopieert de viewer-preferences van de eerste bron die met succes importeert
procedure BuildBundle(const OutputPath: string; Log: TStrings);
var
  Dest: TPdf;
  Sources: TPdfBatchMergeSources;
  Options: TPdfBatchMergeOptions;
  Report: TPdfBatchMergeReport;
  I: Integer;
begin
  SetLength(Sources, 3);
  Sources[0] := TPdfBatchMergeSource.FromFile('cover.pdf');
  Sources[1] := TPdfBatchMergeSource.FromFile('annual-report.pdf', '1,3-5');
  Sources[2] := TPdfBatchMergeSource.FromFile('appendix.pdf', '', 'user-password');

  Options := TPdfBatchMergeOptions.Default;
  Options.ErrorPolicy := bmepSkip;        // doorgaan voorbij onleesbare bestanden

  Dest := TPdf.Create(nil);               // inactief: MergeFiles maakt hem aan
  try
    if not Dest.MergeFiles(Sources, Options, Report) then
      raise Exception.Create('Merge failed: ' + Report.ErrorMessage);

    for I := 0 to High(Report.Issues) do
      Log.Add(Format('%s: %s',
        [Report.Issues[I].FileName, Report.Issues[I].MessageText]));
    Log.Add(Format('%d pages from %d of %d files',
      [Report.ImportedPageCount, Report.ImportedSourceCount, Report.SourceCount]));

    Dest.SaveAs(OutputPath);
  finally
    Dest.Free;
  end;
end;
Welke foutpolicy je kiest hangt af van wat een ontbrekend bestand voor de uitvoer betekent. Voor een contractbundel of een factuurrun is een bundel zonder één van zijn onderdelen een verkeerd document: houd de default bmepStop met rollback aan. Schakel alleen naar bmepSkip voor best-effort-verzamelingen, zoals een weekelijkse digest van rapporten, en behandel bmrsCompletedWithErrors in Report.Status dan als iets waar een persoon naar moet kijken. Wat je ook kiest, lees Report.Issues: elk entry draagt de bronindex, de bestandsnaam en de melding, wat de vraag "welk bestand was de dader" beantwoordt die de handgeschreven loop met zijn eigen excepties moet beantwoorden
Nog twee opties wegen bij lange runs. OnProgress en CancellationToken laten een UI het huidige bestand tonen en de run stoppen, en een geannuleerde run wordt teruggerold zoals een mislukte. ResourcePolicy default op bmrpSourceScoped, dat de geselecteerde pagina's van elke bron in één native aanroep importeert, zodat fonts en afbeeldingen die die pagina's delen één keer worden gekopieerd. bmrpChunked importeert in batches van PageChunkSize pagina's, wat fijnere annuleringspunten oplevert ten koste van het opnieuw kopiëren van gedeelde resources per batch
Wat een geïmporteerde pagina meebrengt, en wat in de bron achterblijft
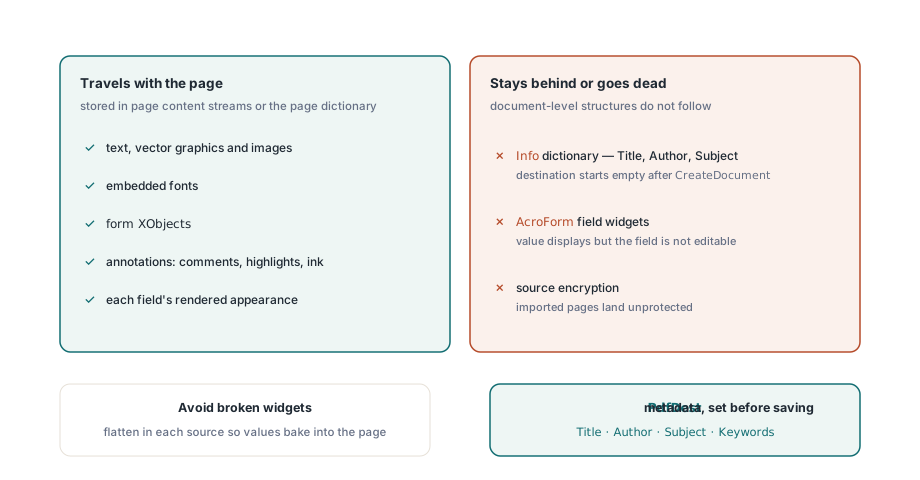
Een geïmporteerde pagina brengt alles mee dat vanuit zijn page-dictionary bereikbaar is: de content-stream, de fonts, afbeeldingen en form-XObjects in zijn resources, en zijn annotaties, inclusief commentaren, highlights en inkt. Alles dat in de bron op documentniveau leeft komt niet mee, want ISO 32000-1 houdt het buiten de paginaboom
- De document information dictionary (ISO 32000-1 §14.3.3) blijft achter, dus het samengevoegde bestand heeft geen Title, Author of Keywords uit de bronnen. De properties
TitleenAuthoropTPdfzijn read-only, wat ze handig maakt voor het loggen van wat elke bron verklaarde voordat je hem sluit - Outlines (§12.3.3) vallen onder de default
OutlinePolicyvanbmopDiscardweg;bmopRejectmaakt van een bron met outlines in plaats daarvan een fout per bestand. Om bladwijzers te houden voegt deFPdfMerge-unitMergeFilesWithNavigationtoe, die outlines herbouwt, botsende named destinations standaard hernoemt met eenImported_-prefix, en links tussen pagina's opnieuw in kaart brengt; het artikel over outlinebewerking en page remapping beschrijft hoe die destinations worden herschreven - Encryptie (§7.6) hoort bij het bronbestand. Een beveiligde bron opent met zijn
Password, maar een bestemming uitCreateDocumentis onversleuteld, en de pagina's die erin worden gekopieerd ook. Moet het samengevoegde bestand beveiligd zijn, schrijf het dan metSaveAsEncryptedin plaats vanSaveAs
Waarom houden formuliervelden het na een merge voor gezien?
Formuliervelden liggen verdeeld over twee niveaus van een PDF. De widget-annotatie die een tekstvak tekent staat op de pagina, terwijl het veld zelf, met zijn naam en waarde, in de /Fields-array van het interactieve formulierdictionary van de catalogus staat (ISO 32000-1 §12.7.2). Een native pagina-import kopieert de widget mee met de andere pagina-annotaties, maar niets voegt hem toe aan de veldboom van de bestemming. Het vak tekent nog zijn laatste weergave. Een viewer die zijn formuliermodel uit /AcroForm bouwt heeft echter geen veld om de widget aan te hangen, dus de waarde kan niet worden bewerkt en elke formulieroperatie die de veldboom doorloopt slaat hem over
TPdfBatchMergeOptions.FormPolicy geeft drie antwoorden voor een gewone merge. bmfpPreserveNative, de default, houdt het hierboven beschreven native importresultaat aan. bmfpFlatten genereert weergaven en flattent de geselecteerde pagina's van elke bron met formulier in het geheugen voordat ze worden geïmporteerd, zodat waarden gewone paginacontent worden; het bronbestand op schijf wordt niet gewijzigd. bmfpReject maakt van elke bron met een AcroForm- of XFA-formulier een fout per bestand
Moeten de velden invulbaar blijven, gebruik dan MergeFilesWithForms uit de FPdfFormMerge-unit. Hij importeert de paginacontent, herbouwt de widgets uit de veldboom van elke bron en ent die velden in het bestemmingsformulier. Veldnamen zijn het moeilijke deel. Volgens §12.7.3.2 zijn twee velden met dezelfde volledig gekwalificeerde naam hetzelfde veld en delen ze één waarde, dus een Total-veld in een factuur en een Total-veld in een pakbon zouden elkaar overschrijven. De default CollisionPolicy is pagcpReject, die de merge stopt bij de eerste botsing:
uses
  PDFium, FPdfCompress, FPdfFormMerge;

procedure MergeFillableForms(Dest: TPdf;
  const Sources: TPdfBatchMergeSources; Log: TStrings);
var
  Options: TPdfFormMergeOptions;
  Report: TPdfFormMergeReport;
begin
  Options := TPdfFormMergeOptions.Default;
  // Botsende namen krijgen de RenamePrefix ('Imported_' tenzij je hem aanpast)
  Options.GraftOptions.CollisionPolicy := pagcpRename;

  if Dest.MergeFilesWithForms(Sources, Options, Report) then
    Log.Add(Format('%d fields grafted, %d renamed',
      [Report.GraftedFieldCount, Report.RenamedFieldCount]))
  else
    Log.Add('Form merge failed: ' + Report.ErrorMessage);
end;
pagcpNamespace zet de velden van elke bron in plaats daarvan onder zijn eigen prefix (Imported plus het bronnummer), en pagcpMergeCompatible voegt gelijknamige velden alleen samen wanneer hun types en opties overeenkomen. MergeFilesWithForms werkt op AcroForm-bronnen en -bestemmingen zonder handtekeningvelden. Hij weigert XFA-formulieren en ondertekende bestanden resoluut, want het herschrijven van een ondertekend bestand maakt de ondertekende byte-range uit ISO 32000-1 §12.8.1 ongeldig. Een open bestemming moet bovendien onversleuteld zijn: samenvoegen in een met wachtwoord beveiligd bestand faalt, dus voeg beveiliging daarna toe met SaveAsEncrypted. Een pagina die in één bron tweemaal is gekozen, zoals in '1,1', vraagt om een expliciete RepeatedPagePolicy
Het bestemmingsdocument wordt pas vervangen nadat het klaargezette resultaat opnieuw is geopend en gecontroleerd. Veldnamen, waarden en types worden pagina voor pagina vergeleken, en een mislukte formuliermerge laat Dest zoals hij was. Het AcroForm-graft-artikel gaat dieper op het botsingsbeheer in
Het samengevoegde document opslaan
SaveAs heeft een bestandsoverload en een TStream-overload, beide met een optionele TSaveOption (default saNone) en een TPdfVersion (default pvUnknown, dat de header aan de library overlaat). Beide geven een Boolean terug, en in een batchjob verdient dat resultaat dezelfde controle als Active. Pin de versie met iets als pv17 alleen wanneer een systeem stroomafwaarts op een specifieke header staat
De omgekeerde klus, één bestand opdelen in meerdere, gebruikt dezelfde bereikstrings en dezelfde posities vanaf 1; het artikel over splitten loopt hem door
ImportPages, MergeFiles en de formulierbewuste merge die hier is beschreven worden meegeleverd met de PDFium Component, die deze pagina-operaties naar Delphi- en C++Builder-applicaties brengt