De Catalog-dictionary van een PDF heeft precies één verplichte navigatiesleutel: /Pages. Die sleutel moet naar een indirect object van het type /Pages wijzen, dat op zijn beurt de array /Kids en het totale aantal pagina's in /Count bevat. Neem die verwijzing weg en geen enkele conforme lezer kan nog één pagina in het bestand vinden. ISO 32000-1 §7.7.2 is op dit punt ondubbelzinnig: de Catalog moet een vermelding /Pages hebben, en het object waarnaar wordt verwezen moet het type /Pages hebben. Bestanden die deze eis schenden, zijn niet louter niet-conform; ze zijn structureel kapot op een manier waar de meeste parsers slecht mee omgaan
Wat de specificatie werkelijk zegt
Een minimale conforme PDF heeft ten minste drie objecten. Object 1 is de Catalog, object 2 is de Pages-wortel, en object 3 en verder zijn afzonderlijke Page-dictionaries. De Catalog wijst naar de Pages-wortel; de Pages-wortel somt haar kinderen op in /Kids; elke Page draagt een /Parent-terugverwijzing. De hele keten is door het ontwerp tweerichtingsverkeer, zodat een parser vanaf beide uiteinden kan beginnen en bij gebalanceerde bomen in O(log n) tijd naar elke pagina kan doorlopen
% Minimale conforme structuur (ISO 32000-1 §7.7.2)
1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [3 0 R 4 0 R] /Count 2 >>
endobj

3 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Contents 5 0 R /Resources << >> >>
endobj

4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Contents 6 0 R /Resources << >> >>
endobj
De Pages-boom mag genest zijn. Een document met duizenden pagina's groepeert die doorgaans in tussenliggende knooppuntobjecten die eveneens het type /Pages dragen, elk met een eigen /Kids en een /Count die de deelboom eronder weergeeft. De /Count van het wortelknooppunt is altijd gelijk aan het totale aantal pagina's. Dat aantal is wat viewers in het paginanummerveld tonen voordat ze ook maar één pagina hebben geparseerd, want één geheel getal uit object 2 lezen is veel goedkoper dan de hele boom doorlopen
Hoe een bestand zonder Pages eruitziet
Bestanden zonder Pages-dictionary komen doorgaans van PDF-generatoren die pagina-objecten rechtstreeks wegschrijven zonder ze tot een boom samen te stellen, of van corruptie die het wortelknooppunt verwijdert terwijl de Page-bladobjecten intact blijven. De Catalog in zo'n bestand mist ofwel de sleutel /Pages volledig, ofwel bevat een verwijzing naar een object dat niet langer in de kruisverwijzingstabel bestaat
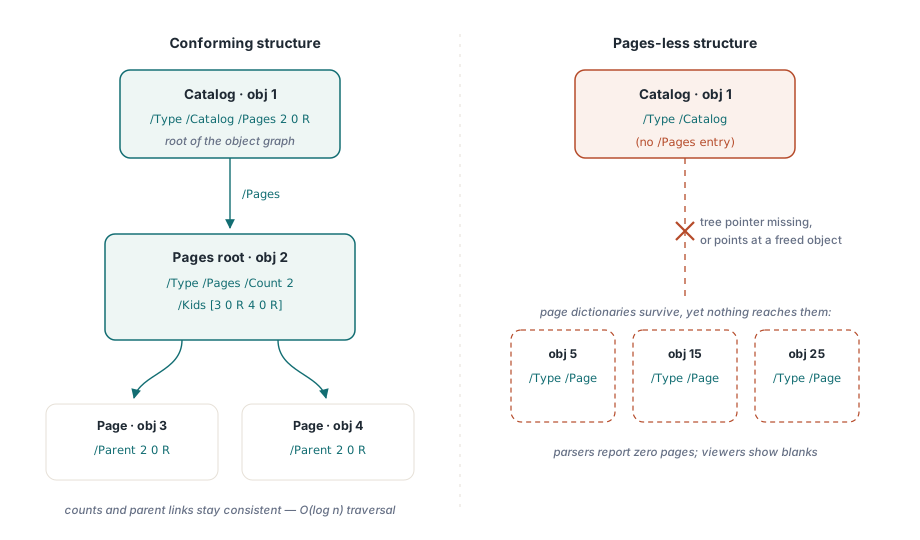
/Pages, terwijl een bestand zonder Pages intacte pagina-objecten achterlaat zonder navigeerbare ingang vanuit de Catalog% Niet-conform: Catalog zonder verwijzing /Pages
1 0 obj
<< /Type /Catalog >>
endobj
% Pagina-objecten bestaan maar zijn onbereikbaar vanuit de Catalog
5 0 obj
<< /Type /Page /MediaBox [0 0 612 792] /Contents 6 0 R /Resources << >> >>
endobj
15 0 obj
<< /Type /Page /MediaBox [0 0 612 792] /Contents 16 0 R /Resources << >> >>
endobj
25 0 obj
<< /Type /Page /MediaBox [0 0 612 792] /Contents 26 0 R /Resources << >> >>
endobjEen parser die de specificatie volgt, leest de Catalog, probeert /Pages op te lossen, vindt niets (of een dode verwijzing), en werpt ofwel een fout op ofwel meldt nul pagina's. Wat hij niet mag doen, is doorgaan alsof het bestand nul pagina's had en stilletjes slagen; dat levert een lege uitvoer op die er voor geautomatiseerd gereedschap correct uitziet en fout voor elke mens die hem opent
Waarom parsers crashen
De meeste PDF-parsers wijzen hun interne paginatabel bij het laden toe op basis van de waarde /Count uit de Pages-wortel. Ontbreekt die wortel, dan leest de parser ofwel nul, wijst niets toe, en dereferentieert vervolgens een nulwijzer zodra enige code om pagina 1 vraagt, ofwel leest hij rommel en wijst hij een volstrekt verkeerde buffer toe. Geen van beide uitkomsten is elegant. De toegangsschending op 0x008E5D78 die in crashlogboeken van zulke bestanden opduikt, is precies dit: een dereferentie van een nulwijzer in het paginatoegangspad, uitgelokt door de afwezigheid van de structuur waarvan de parser aannam dat die er altijd zou zijn
De onderliggende ontwerpaanname is redelijk. De overgrote meerderheid van de bestaande PDF-bestanden heeft een Pages-dictionary. Parsers die de bestaanscontrole overslaan om een paar instructies te sparen, zijn niet roekeloos; ze optimaliseren voor het gangbare geval. De bestanden die die optimalisatie afstraffen, zijn zeldzaam genoeg dat productiecode er misschien nooit een tegenkomt, tot het wel gebeurt, en op dat moment is de crash zowel reproduceerbaar als onbegrijpelijk als de ontwikkelaar §7.7.2 niet heeft gelezen
Herstel zonder Pages-boom
Moet een parser deze bestanden verwerken in plaats van ze te weigeren, dan volgt het herstel een voorspelbaar pad: scan elk indirect object in de kruisverwijzingstabel, verzamel de objecten met /Type /Page, en sorteer ze op objectnummer. De specificatie garandeert niet dat de volgorde van objectnummers overeenkomt met de leesvolgorde, maar in de praktijk zenden generatoren die de Pages-boom weglaten hun pagina's meestal opeenvolgend uit, dus de volgorde op objectnummer klopt vaker wel dan niet
De controle zelf is goedkoop. Bevestig, voordat u de verwijzing /Pages van de Catalog volgt, dat die verwijzing bestaat, dat ze naar een echt object oplost, en dat de /Type van het opgeloste object gelijk is aan /Pages. Faalt een van die drie voorwaarden, val dan terug op de lineaire scan. De scan is voor grote documenten trager dan het doorlopen van de boom, omdat hij elke objectkop leest in plaats van een gebalanceerd pad te volgen, maar hij werkt, en voor een bestand dat toch al misvormd is, gaat juistheid boven snelheid
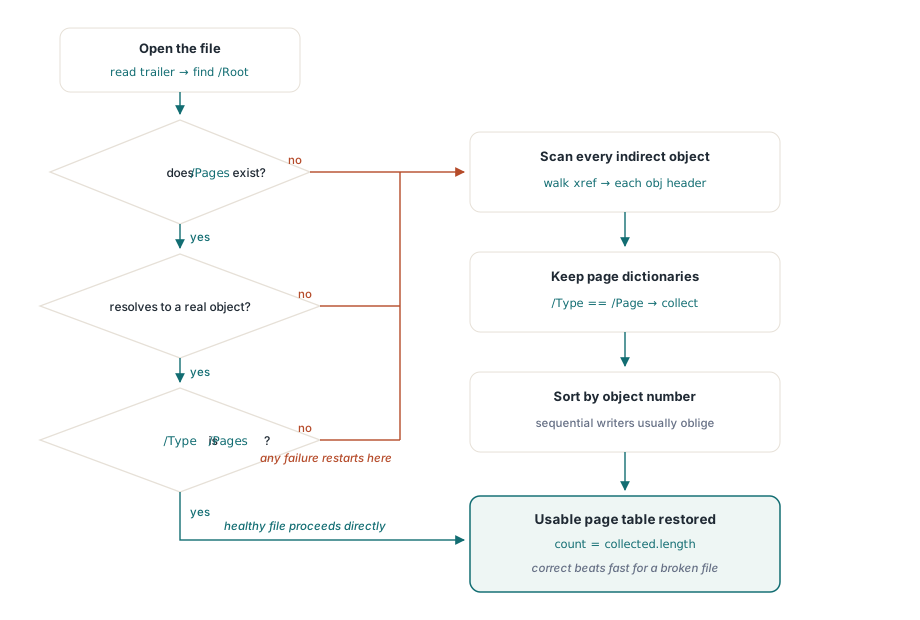
/Pages, en elke mislukking leidt de parser naar een lineaire scan die de paginatabel op objectnummer herbouwtEén randgeval lost de lineaire scan niet automatisch op: de paginavolgorde. Zonder een array /Kids die de reeks bepaalt, is de "juiste" volgorde volgens de specificatie ongedefinieerd. De volgorde op objectnummer is de pragmatische standaard; is het bestand belangrijk genoeg om zorgvuldig te verwerken, dan loont het extra werk om te controleren of de Page-objecten een expliciete /StructParents of annotatieverwijzingen dragen die een leesvolgorde impliceren
Gevolgen voor PDF-generatoren
Voor wie een PDF-generator schrijft in plaats van een parser, is de les smal: zend altijd de Pages-wortel uit voordat u het bestand sluit. De Catalog zonder vermelding /Pages is onder geen enkele revisie van de specificatie een geldige PDF. Generatoren die pagina-objecten gaandeweg opbouwen en de boom bij de afronding samenstellen (de aanpak van de meeste streaming-schrijvers) zijn prima, zolang die afronding daadwerkelijk draait. De gebruikelijke faalwijze is een uitzondering of een vroege return die het schrijven afbreekt voordat de trailer compleet is, en die een bestand achterlaat dat in sommige viewers opent (die herstelheuristieken hebben) en in andere faalt (die dat niet hebben)
PDF/A en PDF/UA leggen aanvullende beperkingen op aan de paginaboom bovenop wat de basisspecificatie eist, maar geen van beide versoepelt de eis van /Pages. Een validator die conformiteit met ISO 19005 of ISO 14289 controleert, vangt een ontbrekende Pages-dictionary op als een schending van de basisspecificatie nog voordat hij bij de profielspecifieke regels komt