Twee minuten om drie pagina's uit een PDF van 40 pagina's te kopiëren is geen prestatieprobleem om bij te tuningen. Het is een signaal dat het verkeerde API-pad wordt gebruikt. Toen ik deze timing voor het eerst zag op pagina-kopieercode gebouwd op de HotPDF Delphi Component, was mijn instinct eerst naar de documentstructuur te kijken en pas daarna naar de code. Die volgorde bleek precies verkeerd
Wat er daadwerkelijk traag was
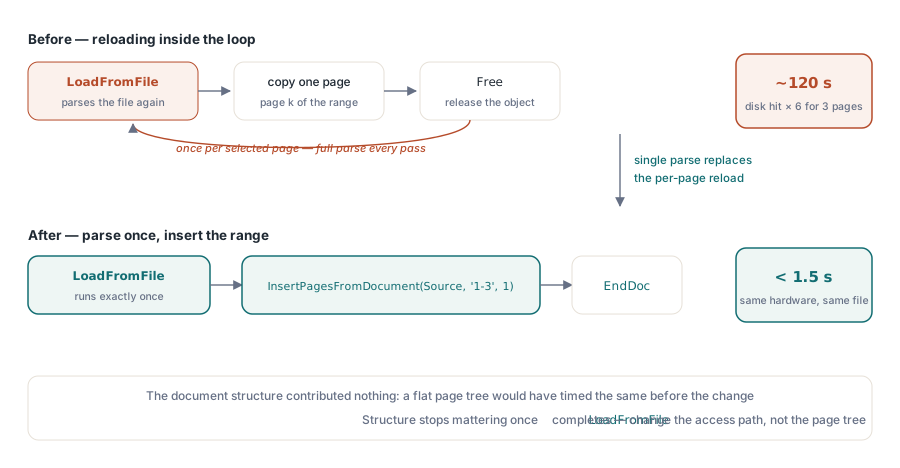
De PDF in kwestie was een referentiedocument van 40 pagina's met een niet-triviale paginaboom: meerdere tussenliggende /Pages-knooppunten in plaats van een enkele platte array. De code riep LoadFromFile aan, bouwde vervolgens een nieuw document op met BeginDoc, liep in een lus over geselecteerde paginanummers en laadde bij elke iteratie het brondocument opnieuw vanaf schijf om een pagina op te halen. Dat is de volledige parseerkost vermenigvuldigd met het aantal pagina's dat je wilt. Een bestand van 12 MB raakte zes keer de schijf voor een extractie van drie pagina's, omdat niemand had gekeken of het bestand tussen de iteraties door open moest blijven
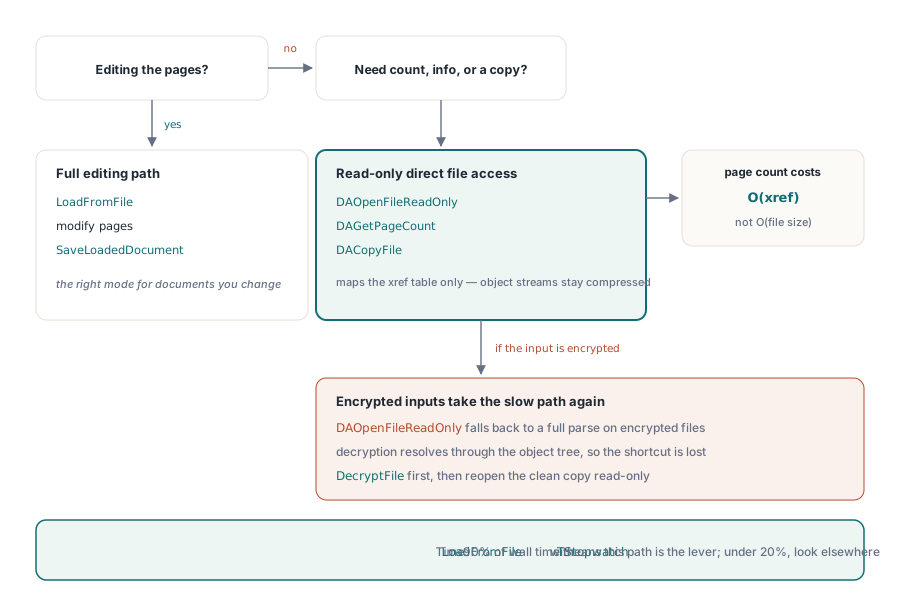
De tweede bijdragende factor was onzichtbaar in de code: LoadFromFile van HotPDF bouwt het in-memory objectmodel waarop de bewerkings-API werkt. Dat is het juiste gedrag voor een document dat je gaat wijzigen, maar het is meer werk dan je nodig hebt als je alleen het aantal pagina's en een subset van pagina's wilt. Voor alleen-lezen toegang tot de structuur vermijdt DAOpenFileReadOnly de deserialisatie van de volledige objectboom, wat uitmaakt bij gecomprimeerde bestanden met grote afbeeldingsbronnen
Beide komen neer op het kiezen van de API die voor één taak is ontworpen en die voor een andere gebruiken
ExtractPagesToFile gebruiken voor pagina-extractie
Het juiste pad om een reeks pagina's uit een geladen HotPDF-document naar een nieuw bestand te kopiëren is ExtractPagesToFile, aangeroepen na LoadFromFile op de bron. Je laadt de bron eenmaal in, en de aanroep bouwt het doeldocument, kopieert de geselecteerde pagina's erin en schrijft het naar schijf, allemaal vanuit de kopie die al in het geheugen staat:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // Laad de bron eenmalig: de volledige parse gebeurt hier en alleen hier
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // Schrijf het gevraagde bereik ('1-3', '1,5,7-9') weg naar een nieuw bestand
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
De parameter PageRange accepteert hetzelfde formaat als het opdrachtregelvoorbeeld: een lijst van paginanummers of -bereiken gescheiden door komma's, zoals '1-3' of '1,5,7-9'. Pagina's zijn 1-based. ExtractPagesToFile kopieert elke geselecteerde pagina samen met de content streams en bronnen waarnaar hij verwijst, dus voor een extractie van drie pagina's uit een document van 40 pagina's blijft de werkset klein
Timing op hetzelfde 12 MB-bestand dat eerder twee minuten duurde: ongeveer 1,3 seconde met dit patroon. Het merendeel van die tijd is de eenmalige LoadFromFile-aanroep. De documentstructuur is irrelevant zodra de objectentabel de eerste keer is opgelost
Wanneer LoadFromFile te veel is: de Direct File API
Als je alleen pagina's hoeft te tellen, documentinformatie wilt inspecteren of een bestand wilt kopiëren zonder de inhoud aan te raken, dan vermijdt de Direct File API de volledige parse volledig. DAOpenFileReadOnly brengt de kruisverwijzingstabel in kaart (maps) zonder objectstreams te decomprimeren, dus het tellen van pagina's is O(xref-grootte) in plaats van O(bestandsgrootte):
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile is een byte-behoudende kopie, zonder her-serialisatie
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
Het voorbehoud: DAOpenFileReadOnly accepteert een wachtwoordparameter maar valt terug op een volledige parse voor versleutelde (encrypted) invoer, omdat decodering vereist dat de objectboom de versleutelingsdictionary oplost. Als je bronbestanden zijn versleuteld, ontsleutel (decrypt) ze dan eerst met DecryptFile om een niet-versleutelde kopie te krijgen, en open die vervolgens met de Direct File API. De functie DecryptFile op bestandsniveau (file-level) neemt een direct AES-256-herschrijfpad voor standaardversleuteling en is bij grote bestanden sneller dan LoadFromFile gevolgd door SaveLoadedDocument, omdat het niet het volledige in-memory objectmodel opbouwt
Geheugen tijdens verwerking in grote batches
Batch-taken die tientallen bestanden in een lus verwerken, hebben een patroon dat er correct uitziet, maar geheugen ophoopt: THotPDF aanmaken in de lus, LoadFromFile aanroepen, werk verrichten, Free aanroepen. Dat is structureel in orde. Het probleem ontstaat wanneer de interne taken 'scratch objects' (tijdelijke objecten) toewijzen, uitzonderingen opvangen en die 'scratch objects' in leven laten op foutpaden (error paths). Het geheugenbeheer van Delphi wordt niet gecomprimeerd (does not compact), dus honderd lekken via foutpaden in een batchuitvoering kunnen het geheugen zodanig opstuwen dat de toewijzing voor al het andere vertraagt
De oplossing is niet exotisch. Elke THotPDF en elke tussentijdse TStream of TBitmap die deelneemt aan PDF-werk hoort thuis in een try/finally-blok, waarbij Free de laatste statement is. Zet lokale pointers op nil vóór de try, zodat de finally-tak if Assigned(x) then x.Free veilig kan gebruiken wanneer de initialisatie halverwege mislukt. Dit is de standaard eigendomsdiscipline in Delphi en dit vormt het volledige verhaal voor deze categorie van problemen
Nog iets om te weten in batchcontexten: AddImage registreert elke afbeelding bij het document dat wordt opgebouwd, en HotPDF geeft die registraties vrij zodra EndDoc dat bestand afrondt. Het register volgt de BeginDoc/EndDoc-cyclus, niet LoadFromFile, dus het nette patroon voor een batch is één THotPDF-instantie per document: aanmaken, het werk doen, opslaan, vrijgeven
Meten voordat je iets verandert
Voordat je naar een van deze patronen grijpt: meten. Delphi's TStopwatch uit System.Diagnostics wikkelt QueryPerformanceCounter in en is nauwkeurig genoeg voor wandklokprofilering (wall-clock profiling) van bestands-I/O. Wikkel LoadFromFile afzonderlijk in en kijk hoeveel tijd dit in beslag neemt. Als het 90% van de totale tijd beslaat, dan is de oplossing de Direct File API of het verminderen van het aantal keren dat je hetzelfde bestand parseert. Zit het onder de 20%, dan bevindt de bottleneck zich ergens anders en ben je op het verkeerde spoor
De extractie van twee minuten waar deze post mee begon, bleek geheel toe te schrijven aan het herhaalde-laadpatroon. De documentstructuur droeg daar niets aan bij; een platte paginaboom zou op dezelfde manier gelopen hebben. Overschakelen naar een eenmalige LoadFromFile gevolgd door één ExtractPagesToFile-aanroep bracht de tijd terug op ongeveer 1,3 seconde op dezelfde hardware, zonder ook maar iets anders aan te raken
De API voor paginamanipulatie die hier getoond wordt, maakt deel uit van de HotPDF Delphi Component voor Delphi en C++Builder