Typ =NORM.DIST(115,100,15,TRUE) in een cel en Excel geeft zonder plichtplegingen 0,8413447 terug. De aanroep leest als een opzoekactie. Dat is het niet. Achter dat ene getal zit de cumulatieve normale verdeling, een integraal zonder gesloten vorm, en achter CHISQ.INV.RT en BETA.DIST zitten speciale functies die een zorgvuldige bibliotheek moet evalueren en niet met de hand mag benaderen. Een spreadsheetcomponent die Excel-compatibiliteit claimt, moet deze waarden tot op het laatste cijfer dat Excel toont reproduceren, en dat betekent de numerieke methoden reproduceren, niet alleen de functienamen
HotXLS implementeert ruim vijftig van deze statistische functies, en het werk dat ze correct maakt, is vanaf de formulebalk vrijwel onzichtbaar. Dit is een rondleiding langs de manier waarop de engine ze berekent: de gedeelde kern met speciale functies, de vertakkingsbeslissingen die het rekenwerk stabiel houden, en een bug in de inverse normale verdeling die zich lang in de staart verstopte omdat het gangbare geval de kapotte regel nooit raakte
Eén werkbladaanroep, vijftig verdelingen erachter
De functies bestrijken de families waar een statistische werkmap naar grijpt. Er is de normale familie, NORM.DIST en NORM.S.DIST met hun inversen; de gamma- en chi-kwadraatfamilie, GAMMA.DIST, CHISQ.DIST, CHISQ.DIST.RT, CHISQ.INV.RT; de betafamilie, BETA.DIST en BETA.INV; de steekproefverdelingen T.DIST, T.DIST.2T, F.DIST en F.INV; het discrete paar BINOM.DIST en POISSON.DIST; en de toetsingshulpen zoals CONFIDENCE.T en CONFIDENCE.NORM. Vanuit de stoel van de aanroeper is elk daarvan één enkele formule. U zet invoerwaarden in cellen, vraagt de werkmap om te evalueren en leest het resultaat
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // waarneming
  sh.Range['A2', 'A2'].Value := 100;   // gemiddelde
  sh.Range['A3', 'A3'].Value := 15;    // standaardafwijking

  // De XLS-formuleparser gebruikt ';' als argumentscheidingsteken.
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;
De methode Calculate op de werkmap compileert en evalueert een ad-hocformule tegen het levende blad en geeft een Variant terug. Eén detail laat mensen bij de eerste poging struikelen: de formuleparser achter Calculate neemt de puntkomma als argumentscheidingsteken, dus het is =SUM(A1;B1) en niet =SUM(A1,B1). Opgeslagen celformules houden de komma aan die in Excel de standaard is. Dezelfde evaluator verdeelt elke statistische functie hieronder, dus zodra één ervan werkt in Calculate, volgt de rest hetzelfde pad
De twee functies waar al het andere op rust
De meeste cumulatieve verdelingen in deze verzameling worden niet berekend door hun eigen definitie te sommeren of te integreren. Ze worden berekend uit twee speciale functies: de geregulariseerde onvolledige gammafunctie van beneden, geschreven als P(a, x), en de geregulariseerde onvolledige betafunctie, geschreven als Ix(a, b). Intern zijn dit de hulpfuncties waar de dispatchers op leunen, en de keten is kort. De chi-kwadraat-CDF is de gamma-CDF met vormparameter df/2 en schaal 2. De gamma-CDF is direct P(a, x). De cumulatieve t-, F- en binomiaalfuncties zijn stuk voor stuk waarden van de geregulariseerde onvolledige beta bij de juiste argumenten. De CDF van Poisson is de bovenste onvolledige gamma Q. Implementeer de gamma- en betafunctie goed en een dozijn verdelingen erft hun nauwkeurigheid gratis
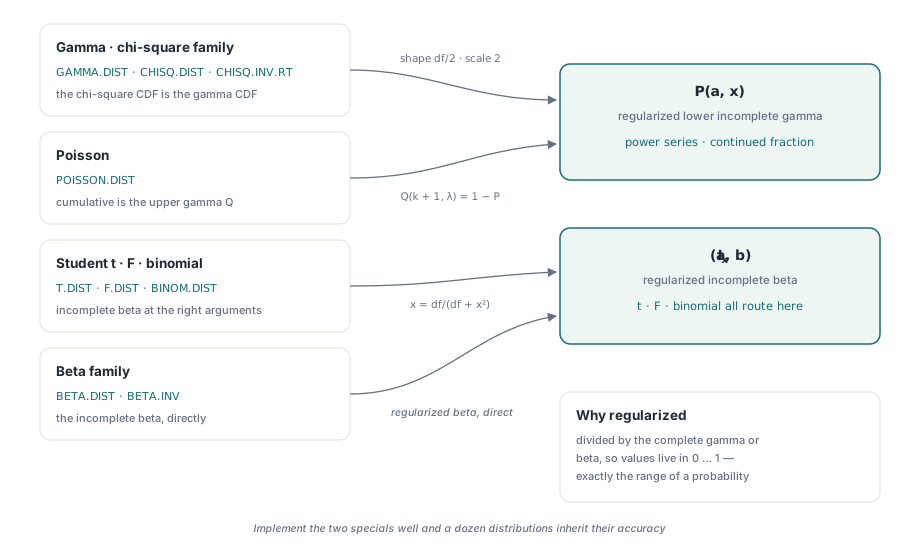
Het woord "geregulariseerd" is de hele clou. De ruwe onvolledige gamma groeit als een faculteit en de ruwe beta-integraal kan onderlopen of overlopen lang voordat het antwoord dat doet. De geregulariseerde vormen zijn gedeeld door de volledige gamma of beta, dus ze leven volledig in het interval van nul tot één, precies het bereik dat een kans inneemt. Die normalisatie is wat dezelfde routine in staat stelt om zowel een chi-kwadraat met twee vrijheidsgraden als een met tweehonderd te bedienen, zonder dat de tussentermen van de rand van een double aflopen. Het verklaart ook waarom u een CDF niet berekent door een lange staart van dichtheidstermen op te tellen: elke term draagt zijn eigen afrondingsfout, de fouten stapelen zich op naarmate de reeks loopt, en de geregulariseerde speciale functie omzeilt de som volledig door in plaats daarvan een snel convergerende reeks of kettingbreuk te evalueren
Reeks onder de diagonaal, kettingbreuk erboven
De routine voor de onvolledige gamma neemt één beslissing voordat ze iets berekent: ze vergelijkt x met a + 1. Die grens is niet willekeurig. De machtreeksontwikkeling van P(a, x) convergeert snel wanneer x klein is ten opzichte van a, en traag, uiteindelijk nutteloos, wanneer x groot is. De kettingbreuk heeft het omgekeerde karakter. De engine gebruikt dus de machtreeks voor x onder a + 1 en een kettingbreuk volgens Lentz voor x op of boven a + 1, waarbij elke tak alleen het werk hoeft te doen waar ze goed in is
De kettingbreuk heeft één beveiliging nodig. De methode van Lentz werkt door een lopende teller en noemer mee te dragen en de noemer bij elke stap te inverteren, en als een van beide de nul nadert, ontploft die inversie. De oplossing is een minieme ondergrens: zodra een tussenterm in grootte onder ongeveer 1e-30 zakt, wordt hij op 1e-30 vastgezet, wat de recursie eindig houdt zonder de geconvergeerde waarde te verstoren. Dezelfde begrenzing duikt om dezelfde reden op in de kettingbreuk van de onvolledige beta. Het is een kleine constante die dragend werk verricht, het verschil tussen een stabiele evaluatie en een deling door iets dat niet van nul te onderscheiden is
De bovenstaart, Q(a, x), is simpelweg 1 min P(a, x), en zo wordt de cumulatieve tak van Poisson berekend: de kans op ten hoogste k gebeurtenissen met gemiddelde λ is Q(k + 1, λ). Dat via de bovenste onvolledige gamma leiden in plaats van k + 1 Poisson-termen op te tellen, is opnieuw de keuze om één convergente uitdrukking te evalueren in plaats van vele kleine op te stapelen
Discrete kansmassa zonder overloop van faculteiten
De discrete verdelingen brengen een ander gevaar mee. Een binomiale kansmassa bevat een binomiaalcoëfficiënt, en de coëfficiënt voor tweeënvijftig-boven-zesentwintig is een enorm geheel getal. Vorm hem rechtstreeks en de teller loopt over de grens van een double heen nog voor de deling die hem tot een zinnige kans zou terugbrengen. De engine vormt hem nooit. Ze berekent de faculteiten in de logruimte via de log-gammafunctie, telt de logaritmen op en trekt ze af, vouwt de logaritmen van de kans op succes en mislukking erin, en neemt aan het allerlaatste eind eenmaal de exponent
// Binomiale kansmassa, volledig in de logruimte geevalueerd.
// LnGammaF(n+1) is ln(n!); de drie log-faculteiten vormen ln(C(n,k)),
// en de hele exponent is opgebouwd voor er een enkele Exp-aanroep volgt.
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
  + kk * Ln(pp) + (nt - kk) * Ln(1 - pp));
De log-gammafunctie zelf is een Lanczos-benadering, nauwkeurig over de hele positieve as en goedkoop te evalueren. Omdat elke grote grootheid als logaritme wordt vastgehouden tot de laatste Exp, is het grootste getal dat de routine ooit materialiseert de kans zelf, die hooguit één is. De massafunctie van Poisson volgt hetzelfde recept, met de enkele log-gammaterm in de plaats van de faculteit in de noemer. De gesloten vormen krijgen aan de randen een aparte behandeling, waar p exact nul of één is, zodat de code nooit Ln(0) aanroept. HotXLS geeft 0,2460938 terug voor BINOM.DIST(5,10,0.5,FALSE) en 0,6766764 voor de cumulatieve POISSON.DIST(2,2,TRUE), in overeenstemming met Excel tot en met de cijfers die het afdrukt
Inversen door de voorwaartse kromme in te sluiten
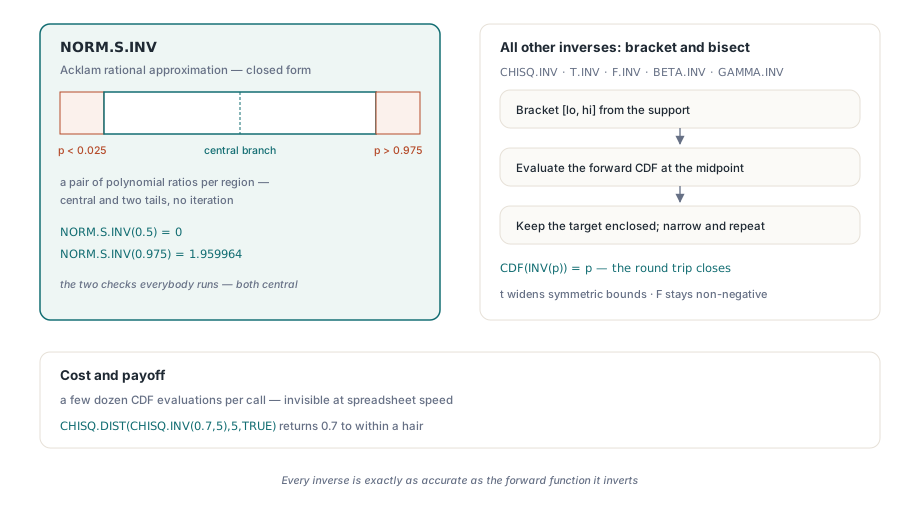
Een inverse verdelingsfunctie stelt de omgekeerde vraag: gegeven een kans, vind de waarde waarvan de CDF daaraan gelijk is. Slechts één inverse in deze verzameling heeft een snelle directe formule. NORM.S.INV, de inverse standaardnormale, gebruikt een rationale Acklam-benadering, een paar polynoomverhoudingen die over het hele bereik nauwkeurig zijn tot ongeveer de precisie van een double, opgesplitst in een centraal gebied en twee staarten. Het is een evaluatie in gesloten vorm zonder iteratie
De andere inversen kennen zo'n formule niet, dus de engine inverteert ze numeriek. Ze sluit het antwoord in tussen een onder- en een bovengrens die uit het draagvlak van de verdeling worden gekozen, en halveert dan: evalueer de voorwaartse CDF in het midden, verplaats de grens die de doelkans ingesloten houdt, en herhaal tot het interval smal is. Voor de gamma- en chi-kwadraatinversen begint het insluitingsinterval bij nul en bij een ruime bovenschatting die uit vorm en schaal is opgebouwd, waarbij de bovengrens wordt verdubbeld als de kans nog niet is ingesloten. De t-inverse sluit in met symmetrische grenzen die naar buiten wijken; de F-inverse halveert op een niet-negatief interval. De prijs is enkele tientallen CDF-evaluaties per aanroep, wat op spreadsheetsnelheid onzichtbaar is, en de winst is dat elke inverse exact even nauwkeurig is als de voorwaartse functie die hij inverteert. Daarom komt een rondgang als CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE) op een haar na terug op 0,7
De logaritme met grondtal 10 die zich in de staart verstopte
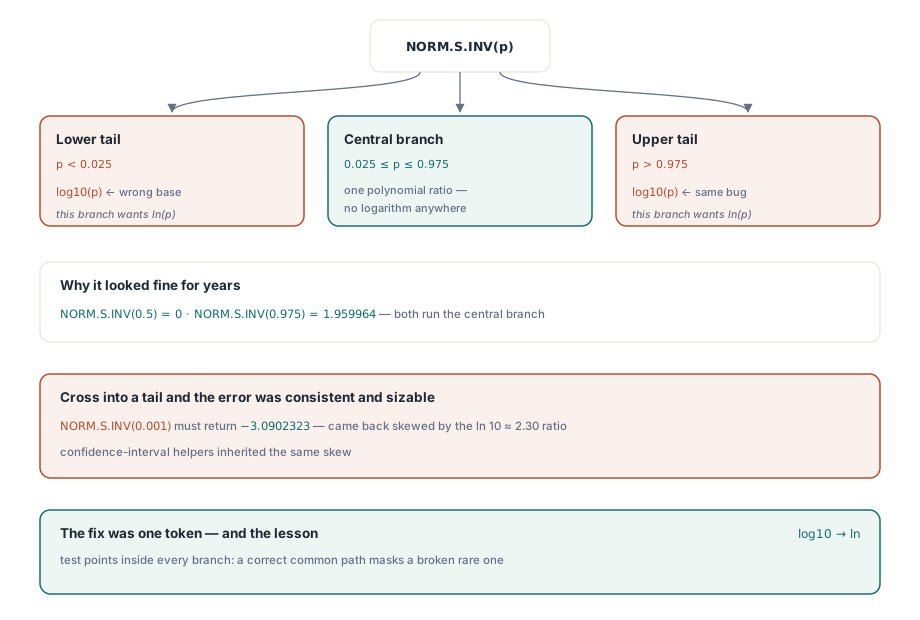
Hier is de bug die het vertellen waard is, omdat het het soort is dat lang overleeft. De Acklam-routine voor de inverse normale heeft drie takken. De brede centrale tak, die wordt gebruikt zodra de kans tussen ongeveer 0,025 en 0,975 ligt, jaagt de invoer door een polynoomverhouding zonder enige logaritme erin. De twee staarttakken, voor zeer kleine of zeer grote kansen, nemen elk eerst een logaritme van de invoer, want de staart gedraagt zich als de wortel uit min de natuurlijke logaritme van p
Een vroege versie van de staarttak nam een logaritme met grondtal 10 waar de natuurlijke logaritme thuishoorde. De twee verschillen een constante factor van ongeveer 2,30, dus de staartresultaten zaten er met een consistente, forse marge naast. En toch zag de functie er bij elke oppervlakkige controle prima uit, want oppervlakkige controles leven in het midden. NORM.S.INV(0.5) is nul, NORM.S.INV(0.975) is de leerboekwaarde 1,959964, en die lopen allebei door de centrale polynoom die helemaal geen logaritme aanroept. De fout dook pas op zodra een kans een staart binnenging, bijvoorbeeld NORM.S.INV(0.001), dat -3,0902323 moet teruggeven en in plaats daarvan terugkwam met precies de verhouding tussen de natuurlijke en de tienlogaritme ernaast. Elke functie die in haar staart van de inverse normale afhangt, inclusief de hulpfuncties voor betrouwbaarheidsintervallen, erfde dezelfde scheefheid. De les is alledaags en duur: een functie met een takstructuur heeft testpunten binnen elke tak nodig, want een correct gangbaar pad maskeert vrolijk een kapot zeldzaam pad. De oplossing was een wijziging van één token, van de tienlogaritme naar de natuurlijke logaritme, en de staartwaarden klikten vast op die van Excel
Het teken van x bepaalt de staart van de t-verdeling
De cumulatieve functie van Student t draagt een subtiliteit die makkelijk andersom uitpakt. Haar waarde komt uit de geregulariseerde onvolledige beta geëvalueerd in df / (df + x²), maar die betawaarde is de kans in de staart voorbij de grootte van x, niet de cumulatieve kans tot x. De symmetrische vorm van de t-verdeling betekent dat de omrekening afhangt van aan welke kant van nul x valt
// CDF van Student t. ib is de geregulariseerde onvolledige beta in df/(df+x*x),
// die de symmetrische staart meet. De cumulatieve waarde hangt af van
// het teken van x; ib onomgerekend teruggeven levert de verkeerde staart op.
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // boven het gemiddelde: een min de halve staart
else if x < 0 then
  result := 0.5 * ib            // onder het gemiddelde: de halve staart
else
  result := 0.5;                // precies op het gemiddelde
Voor x boven nul is de cumulatieve kans één min de halve symmetrische staart; voor x onder nul is het de helft van die staart; in nul is het precies een half. Geef de betawaarde rechtstreeks terug en u rapporteert de verkeerde kant van de verdeling, met de hele romp van de kromme ernaast voor elke x ongelijk aan nul. De varianten voor de rechterstaart en beide staarten bouwen op dezelfde tak voort, en daarom komt T.DIST.2T(1,1) terug als 0,5 en T.DIST(1,1,TRUE) als 0,75, en halveert de inverse T.INV tegen deze gecorrigeerde CDF zodat de rondgang sluit
Niets hiervan is zichtbaar vanuit de cel, en dat is precies de bedoeling. U schrijft een formule en leest een getal dat met Excel overeenstemt. Breidt u de engine uit met uw eigen logica, dan komt het registreren van een functie aan bod in onze rondleiding langs de formule-engine en aangepaste functies, en de manier waarop formules over bladen en benoemde bereiken heen reiken staat in het artikel over gedefinieerde namen en formules over meerdere bladen. Dit alles wordt geleverd in de HotXLS Delphi-spreadsheetcomponent voor Delphi en C++Builder, naast de API's voor lezen, schrijven, grafieken en opmaak die elders op deze blog aan bod komen