Een Delphi-loader die een XLSX-pakket van acht werkbladen op acht worker-threads parset, kan een CPU-grafiek tonen die nauwelijks boven één kern uitstijgt, en het threadaantal van twee naar acht laten oplopen helpt de stopwatch nauwelijks vooruit. Met twee threads kan de laadbeurt zelfs trager uitpakken dan een kale seriële lus. De parseercode pakt zelf geen locks en de werkbladen delen geen data, dus het wachten gebeurt op een plek waar de broncode het nooit noemt: binnen het geheugenbeheer, dat elk van die workers voor elke elementnaam, attribuutwaarde en cel aanroept
Het threadaantal is de knop waar iedereen eerst aan draait. Voor allocatiegebonden code verzet hij nauwelijks iets. Wat de curve laat bewegen, is het aantal heap-allocaties dat elke cel kost
Hoe HotXLS Open opsplitst in drie fasen
HotXLS parset de worksheets van een XLSX-pakket met meerdere werkbladen standaard op worker-threads. TXLSXWorkbook.ParallelParse staat bij levering op True en ParallelParseThreads op 0, wat één worker per logische processor betekent zoals het besturingssysteem die meldt, nooit meer workers dan er werkbladen te parsen zijn. Van de drie fasen van Open draait er maar één op die workers. Fase A is serieel: hij leest het workbook-onderdeel, de shared strings en de stijlen, maakt elk werkblad aan met naam en zichtbaarheid, en parset het relationships-bestand van elk werkblad zodat hyperlink- en tabeldoelen al geresolveerd zijn. Tegen de tijd dat een worker begint, is elke opslagtabel die hij raakt compleet en wordt hij alleen nog gelezen
Fase B geeft elk werkblad aan een worker. Workers claimen blad-indices uit een gedeelde teller met een interlocked increment, dus een werkmap met één groot blad en zeven kleine balanceert zichzelf zonder scheduler: wie klaar is met een klein blad pakt simpelweg de volgende index. De ZIP-container is het deel dat je niet naïef kunt delen, want een deflate-stream sleept status van het ene blok naar het volgende en twee threads kunnen dezelfde decompressor niet samen vooruit duwen. Elke worker opent daarom zijn eigen decompressor op zijn eigen blad-entry en stroomt de XML rechtstreeks in zijn eigen reader. De bestands-handle is de enige gedeelde bron, en de lock eromheen geldt telkens één seek-en-leesbeurt van gecomprimeerde bytes. Decompressie en parsing draaien beide parallel, en de XML van geen enkel werkblad staat ooit volledig geïnflateerd in het geheugen. Als het parsen eindigt, leest de worker zijn entry tot het einde zodat de ZIP-grootte- en CRC-controles alsnog draaien
Fase C keert terug naar één thread voor de onderdelen die bij elk werkblad horen: commentaren en threaded comments, drawings en grafieken, tabellen en printerinstellingen. In de meeste werkmappen zijn die klein naast de cel-XML
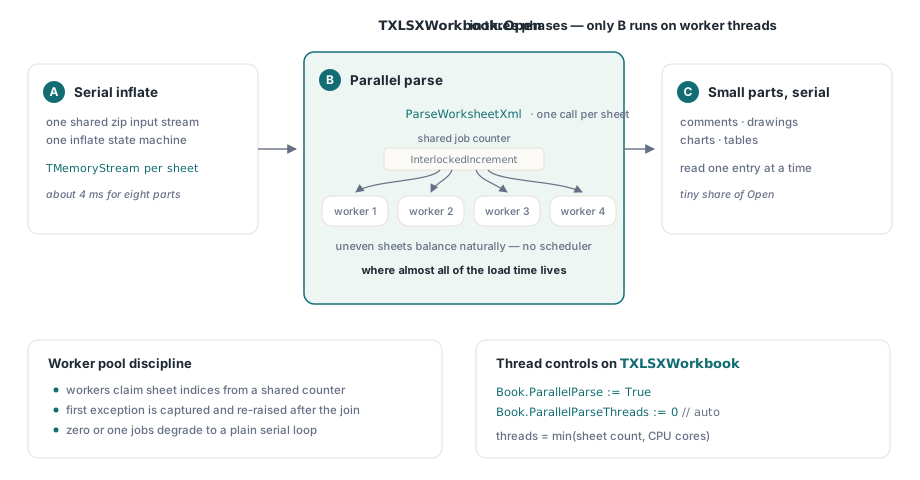
Fouten komen terug op de aanroepende thread. Krijgt een blad tijdens het parsen een exception, dan houdt de pool op met nieuwe indices uit te delen, wacht op de workers die nog draaien, en werpt vanuit Open de exception opnieuw op van het laagst genummerde blad dat faalde, zodat het rapport de bladvolgorde volgt en de aanroeper nooit te maken krijgt met een exception die uit een worker-thread ontsnapt. Met RecoveryMode op True wordt een blad dat niet parst overgeslagen, landt er een waarschuwing in Diagnostics en laden de overige bladen normaal. Zet u ParallelParse op False, dan draait dezelfde parser de werkbladen één voor één af en zijn de resultaten identiek
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // Beide waarden zijn de defaults; ze uitschrijven houdt de keuze
    // zichtbaar in code review
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = één worker per logische CPU, begrensd op het bladaantal
    Book.RecoveryMode := False;      // een blad dat niet parst, werpt vanuit Open op
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // elk blad is hier volledig geladen; lees cellen zoals gewoonlijk
  finally
    Book.Free;
  end;
end;
Waarom maken extra threads een allocatie-intensieve parser trager?
Werkblad-parsing bestaat grotendeels uit kleine allocaties, en het standaard geheugenbeheer van Delphi laat threads daar op hun beurt wachten. Een naïeve XML-reader produceert een string per elementnaam, nog een per attribuutnaam en -waarde, een Variant voor de cel en een string voor zijn tekst. Het standaard geheugenbeheer bewaart kleine blokken in pools per grootte en bewaakt elke pool met een lock. Een thread die de lock bezet vindt, gaat uit de weg en slaapt voor hij het opnieuw probeert. Als acht workers allemaal om hetzelfde handjevol miniem-formaten vragen, botsen ze voortdurend op dezelfde pools, en threads die er in de bron onafhankelijk uitzien, draaien in de praktijk achter elkaar aan
Dat verklaart beide symptomen uit de opening. De CPU-tijd blijft dicht bij de kloktijd omdat een slapende thread geen CPU verbruikt, en de threadmeting blijft vlak omdat de pool-locks, niet de kernen, het tempo bepalen. Twee threads kunnen het van één verliezen: elke allocatie betaalt nu voor het overhandigen van een lock tussen kernen, terwijl de seriële lus nooit concurrentie kent
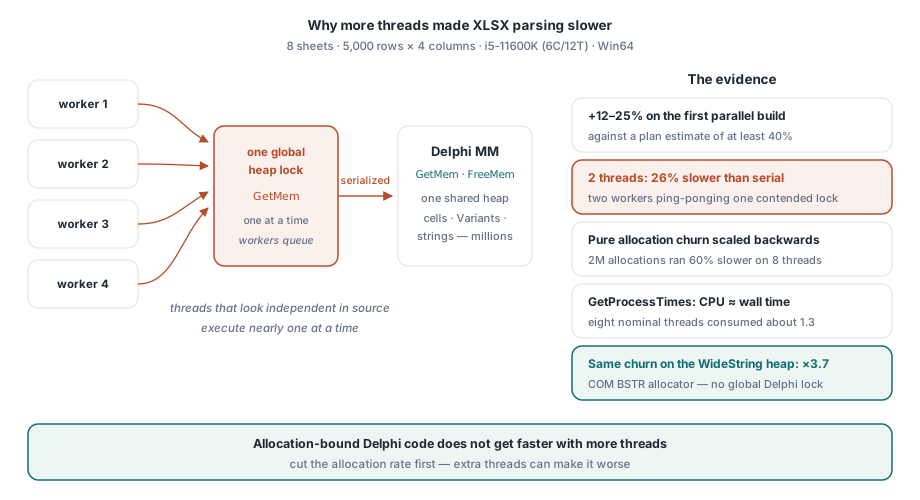
Eén stringtype staat op Windows buiten dit verhaal. Een WideString is een COM BSTR, toegewezen door de OLE-stringallocator van het systeem in plaats van door het geheugenbeheer van Delphi, dus WideString-verkeer staat nooit in de rij voor de Delphi-pools. HotXLS bewaart celtekst als WideString, wat voor parallel laden meer uitmaakt dan het ooit voor het seriële pad deed
De contendie zelf meten op uw eigen werkmappen
Twee getallen vertellen u of een laadbeurt allocatiegebonden is: hoe de kloktijd verandert als het workeraantal stijgt, en hoeveel CPU het proces in hetzelfde interval verbruikte. Blijft de CPU-tijd gedeeld door de kloktijd rond 1,0 terwijl acht workers nominaal bezig zijn, dan staan ze in de rij in plaats van te parsen. De meting hieronder opent hetzelfde bestand met één tot acht workers en print beide cijfers. Het is een meet-harness voor uw eigen testproject; alleen de TXLSXWorkbook-leden komen uit HotXLS
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// Eigen hulpfunctie: user + kernel-CPU-tijd van dit proces, in milliseconden
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // 100 ns-ticks naar ms
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 draait de kale seriële lus
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
Draai de meting meerdere keren en houd per workeraantal de beste waarde bij, want de eerste run betaalt ook voor een koude schijfcache. Een vlakke kloktijd-curve met CPU/klok rond 1 betekent dat het geheugenbeheer het plafond is. Zakt de kloktijd nog steeds terwijl CPU/klok richting het workeraantal klimt, dan is het bestand parse-gebonden en verdienen de extra workers hun plek
Een vlakke curve roept de volgende vraag op: welke allocaties zijn verantwoordelijk? Een memory-manager-wrapper die aanroepen per grootte telt, beantwoordt die vraag binnen enkele minuten, zonder profiler. De versie hieronder telt alleen GetMem en laat FreeMem en ReallocMem naar de oorspronkelijke manager wijzen, wat genoeg is om te zien waar het verkeer vandaan komt
// Diagnostiek die u aan uw eigen testharness toevoegt; geen deel van HotXLS
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // de small-block-churn die het bekijken waard is
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
Installeer de teller vlak vóór Open, haal hem er direct daarna weer af, en deel AllocCount door het aantal cellen in het bestand. Dat cijfer per cel is de waarde om van build tot build te volgen, en het aandeel blokken van 32 bytes of kleiner laat zien of korte strings de boel domineren. Check het vóór u een celobject-pool schrijft: elk celobject is één allocatie, en de kortlevende strings die tijdens het parsen van die cel ontstaan, overtreffen hem makkelijk meerdere keren
Waar de allocaties zich verstoppen in werkblad-XML
Een cel als <c r="B7" s="3" t="s"><v>42</v></c> oogt minuscule op schijf. Een rondborstige reader zet hem nog steeds om in een reeks verse strings: de elementnamen c en v, drie attribuutnamen, drie attribuutwaarden en de tekstinhoud. Elke UTF-8-token via de RTL omzetten voegt een tussenliggende UnicodeString toe voordat de uiteindelijke WideString er is. Geen van die strings overleeft de cel, en elk ervan is een tocht door het geheugenbeheer
De HotXLS XML-reader valt de twee grootste bronnen aan. Elementnamen in werkblad-XML komen uit een heel kleine vocabulaire (row, c, v, f, is), dus de reader houdt een korte cache bij van al eerder ontmoette namen, vergelijkt de ruwe bytes van elke nieuwe naam met die cache en geeft bij een match de gecachte string terug. De gecachte kopieën zijn opzettelijk AnsiString. AnsiString is reference-counted, dus het uitreiken van een gecachte instantie kost één tellerverhoging en helemaal geen allocatie. Een cache van WideString-namen zou niets opleveren: WideString heeft geen reference count en elke toewijzing betekent een nieuwe systeemallocatie
Attribuutnamen, attribuutwaarden en celtekst nemen de andere route. De reader decodeert UTF-8 rechtstreeks uit zijn scanbuffer in twee passen: de eerste telt UTF-16-code-eenheden, de tweede vult een WideString dat één keer wordt toegewezen op exact die lengte. Dat is één allocatie per token, en die belandt op de systeem-stringallocator in plaats van op de Delphi-pools. Character references zoals A en de vooraf gedefinieerde entiteiten lost de scanner op voordat de decodering begint, dus de decoder ziet alleen kale UTF-8. Voor bytereeksen die geen geldige UTF-8 zijn, kopieert de decoder de foutieve bytes één voor één door, waar de RTL-conversie ze zou laten vallen of vervangen, zodat een beschadigd bestand rond de foutplek nog leesbare ASCII oplevert. Geldige invoer decodeert beide keren tot dezelfde tekst
Beide trucs zijn over te nemen in uw eigen Delphi-parseercode. Strings cachen spaart alleen allocaties als het stringtype reference-counted is, en rechtstreeks in het doeltype decoderen scheelt de tijdelijke die de handige RTL-conversiefuncties bij elke aanroep aanmaken
Welke werkmappen winnen, en welke instellingen u kiest
Parallel parsing werkt op werkblad-granulariteit, dus de vorm van de werkmap bepaalt het merendeel van de uitkomst. Meerdere werkbladen van vergelijkbare grootte zijn het beste geval, inclusief de bestanden die u krijgt door een sjabloonwerkblad te dupliceren per regio of per maand. Een werkmap van één gigantisch blad parset op één worker, wat ParallelParseThreads ook zegt; voor die vorm past de streaming direct reader beter, omdat hij de hele werkmap nooit in het geheugen bouwt. Tijd aan commentaren, grafieken en drawings blijft in de seriële Fase C. Een bestand met nul of één blad om te parsen slaat de pool over en draait de kale seriële lus
Als alleen sommige bladen ertoe doen, zet u hun namen in SelectedSheets vóór het aanroepen van Open. De andere bladen worden nog steeds aangemaakt met naam en zichtbaarheid maar zonder cellen, de workers stappen erover heen, en LoadSheet vult er later één in als de gebruiker hem opent
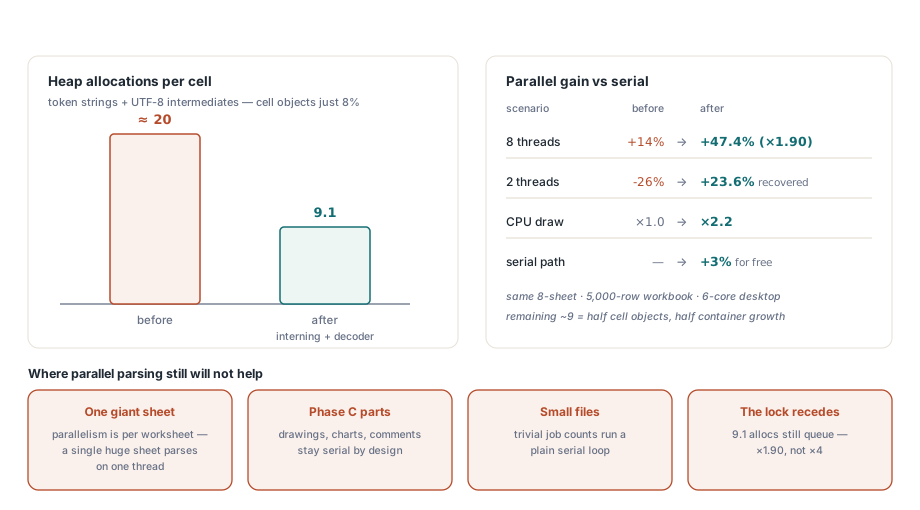
Laat ParallelParse aan staan voor desktop-tools en batchtaken die één werkmap tegelijk openen. Die default is de veiligste: resultaten komen overeen met het seriële pad, en één property zet het uit mocht er ooit een threading-vraag opduiken. Een server die al meerdere werkmappen tegelijk opent, is iets anders. Elke request-thread alloceert namelijk ook, dus elke extra parse-worker voegt een concurrent toe voor dezelfde geheugenbeheer-pools; zet daar ParallelParseThreads op 2 en verhoog pas als de meting hierboven, op die server onder zijn normale last, laat zien dat de extra workers zichzelf terugverdienen. Minder allocaties per cel tilt het plafond zonder het weg te nemen. Celobjecten en containergroei gaan nog steeds door de Delphi-pools, en dat is waarom de winst van acht workers ruim onder acht keer blijft. Voor de rest van de laad-en-opslag-toolkit, van stijlhergebruik tot bulk-rijcallbacks, zie de gids over prestaties van grote werkmappen in Delphi
De worker-pool, de ParallelParse- en ParallelParseThreads-schakelaars en de allocatiezuinige XML-reader worden allemaal geleverd in de HotXLS Delphi Excel Component, die XLS, XLSX en ODS rechtstreeks uit Delphi- en C++Builder-code leest en schrijft zonder Excel op de machine