In Excel levert ="a-b">"ab" TRUE op, en ="a~b"<"ab" levert ook TRUE op. Geef dezelfde paren aan CompareText van Delphi en beide antwoorden draaien om, want het koppelteken zit in code-point-volgorde onder de letters en de tilde erboven. Excel vergelijkt tekst met de hoofdletterongevoelige "woordsortering" van de Windows-gebruikerslocale, waarin koppeltekens en apostrofes alleen gelijkspel breken en elk ander leesteken vóór cijfers en letters sorteert
De symptommen hebben zelden het woord collation in de titel. Een COUNTIF(A:A,">M") die op de server wordt berekend telt twee rijen meer dan dezelfde formule in Excel. Een prijslijst die een rapportservice sorteert zet X-100 ergens neer waar Excel het niet zou doen. VLOOKUP("ABC",...) geeft #N/A terug terwijl de kolom heus abc bevat. Alle drie komen op dezelfde vraag uit: als beide operands tekst zijn, welke is dan kleiner? Excel heeft een precies antwoord, en dat is zelden wat Delphi-code standaard geeft
Welke regel gebruikt Excel om twee tekststrings te vergelijken?
Excel vergelijkt twee tekstwaarden met de woordsortering van de huidige Windows-gebruikerslocale, hoofdletterongevoelig. Woordsortering is de default collation van de NLS-vergelijkingsfuncties van Windows: letters vergelijken op hun linguïstische volgorde in plaats van op code points, dus é landt tussen e en f, en hoofd- en kleine letters vallen samen. Twee tekens krijgen een speciale behandeling. Het koppelteken - en de apostrof ' worden in de eerste passe overgeslagen, waardoor co-op direct naast coop belandt; pas als de overige tekens gelijk eindigen, beslist hun aanwezigheid, en hun positie, over de volgorde. Elk ander leesteken telt vol mee en sorteert vóór de cijfers, en de cijfers sorteren vóór de letters
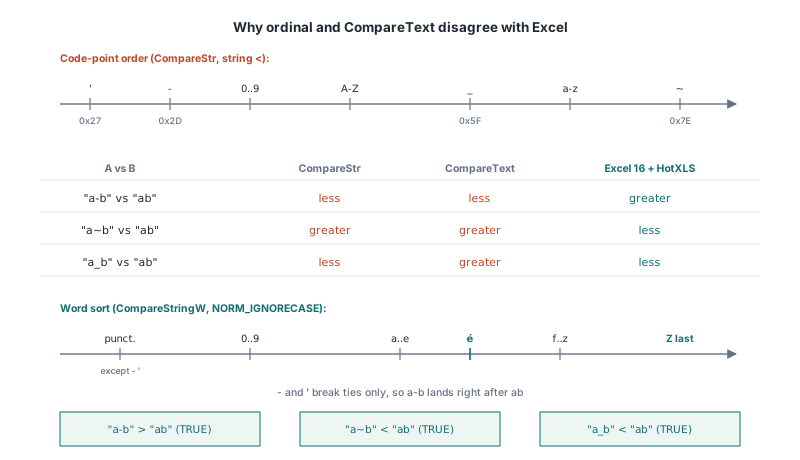
De tabel zet de uitspraak van Excel voor IF(A<B,...) tegen de twee vergelijkingen waar een Delphi-ontwikkelaar het vaakst als eerste naar grijpt
| A vs B | Excel / HotXLS | CompareStr (ordinaal) | CompareText |
|---|---|---|---|
"a-b" vs "ab" | groter | kleiner | kleiner |
"a'b" vs "ab" | groter | kleiner | kleiner |
"a~b" vs "ab" | kleiner | groter | groter |
"a_b" vs "ab" | kleiner | kleiner | groter |
"ab" vs "AB" | gelijk | groter | gelijk |
"é" vs "f" | kleiner | groter | groter |
"Z" vs "f" | groter | kleiner | groter |
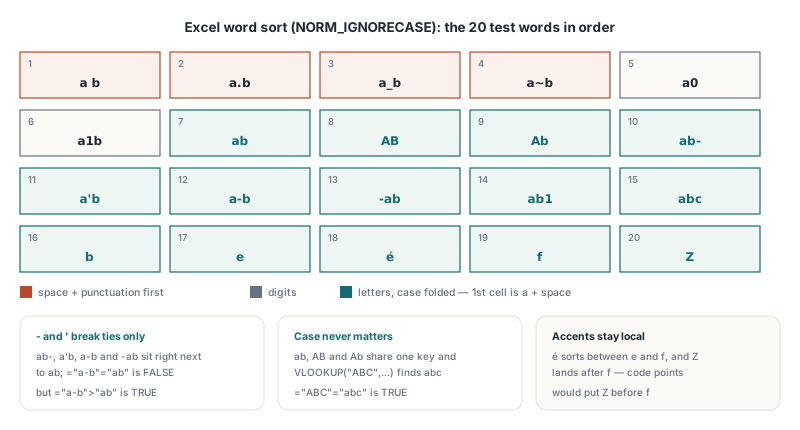
Twee gevolgen worden vaak gemist. Omdat het koppelteken alleen gelijkspel breekt, is ="a-b"="ab" FALSE: de twee strings zijn in een sortering directe buren en toch niet gelijk. En omdat hoofdletters volledig wegvallen, zijn ab, AB en Ab voor elke vergelijkingsoperator één sleutel. Onder een Engelse gebruikerslocale sorteert een kolom met 20 lastige woorden als a b, a.b, a_b, a~b, a0, a1b, ab / AB / Ab, ab-, a'b, a-b, -ab, ab1, abc, b, e, é, f, Z. Binnen de groep ab beslist de positie van het overgeslagen teken: koppelteken achteraan eerst, koppelteken vooraan laatst
Zelf de collation tegen Excel toetsen
De documentatie van Excel noemt de gebruikte collation nergens bij naam, dus de betrouwbare manier om dat op uw eigen machine te bevestigen is Excel een batch stringparen laten oordelen en die uitspraken vergelijken met CompareStringW onder verschillende vlaggensets. Zet paren in twee kolommen, laat Excel per rij =IF(A1<B1,-1,IF(A1=B1,0,1)) evalueren en draai dezelfde paren door de API. Paren die de moeite waard zijn mengen ASCII-leestekens, cijfers, beide letterkasten, spaties, letters met accenten zoals é, ß en ä, CJK-tekens, full-width-vormen en de vaste spatie, met genoeg near-misses die op één teken verschillen. Willekeurige woorden uit een woordenlijst zijn een slecht sample, want kale letters sorteren onder elke regel in dit artikel identiek
De vlaggensets geven duidelijk verschillende resultaten:
- Alleen
NORM_IGNORECASE, metLOCALE_USER_DEFAULT, is de kale woordsortering en de regel die Excel volgt - Voeg
SORT_STRINGSORTtoe en u schakelt over naar string sort, waarin het koppelteken en de apostrof gewone symbolen met vol gewicht zijn, zodat elk paar in de stijl vana-b/abde andere kant op uitvalt - Voeg
NORM_IGNOREWIDTHtoe en een full-width-letter wordt gelijk aan zijn half-width-vorm, terwijl Excel die twee uit elkaar houdt
Eén valkuil zit in de testopzet zelf. Excel ziet een apostrof die u vooraan in een cel typt als het prefix "opslaan als tekst", dus een cel waarvan de hele invoer ' is eindigt leeg, en elk paar dat zo wordt gebouwd meldt een mismatch die niets met collation te maken heeft. Bouw zulke paren met stringliterals in de formule (="'"), of sla ze over
Waarom zitten CompareText en ordinale vergelijking ernaast?
CompareText en ordinale vergelijking zitten naast de volgorde van Excel omdat ze UTF-16 code units vergelijken, en code-point-volgorde strooit leestekens rond het alfabet. Het koppelteken is U+002D en de apostrof U+0027, beide onder elke letter, dus een ordinale vergelijking noemt "a-b" kleiner dan "ab" terwijl Excel het koppelteken als gelijkspelbreker behandelt. De tilde is U+007E, boven elke letter, waardoor "a~b" groter uitvalt, het omgekeerde van Excel. CompareText voegt daar nog een eigen vervorming aan toe: de functie vouwt alleen a..z naar hoofdletters en vergelijkt dan code units, en omdat het laag streepje (U+005F) tussen de hoofdletter- en kleinletterranges ligt, schuift dat vouwen "a_b" van onder "ab" naar erboven. Geen van beide functies heeft enig besef dat é tussen e en f hoort
De gebruikelijke Delphi-tools vallen aan beide kanten van de lijn:
CompareStr, de string-operator<enTComparer<string>.Defaultzijn ordinaal en hoofdlettergevoelig, dusTArray.Sort<string>zonder comparer zetZvóórfCompareTextenSameTextzijn ordinaal na alléén-ASCII-hoofdlettervouwingAnsiCompareTextenWideCompareTextin de Delphi-RTL op Windows roepenCompareString(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...)aan, dezelfde aanroep die bij Excel past. Een gesorteerdeTStringListmet zijn defaults (UseLocaleTrue,CaseSensitiveFalse) loopt viaAnsiCompareTexten is het dus ook met Excel eens- Op POSIX-doelen leidt de Delphi-RTL
AnsiCompareTextvia een ICU-collator, een ander algoritme met andere leestekenregels. DeAnsiCompareTextvan Free Pascal op Windows converteert naar de ANSI-codepagina en roeptCompareStringAaan, waarbij elk teken verloren gaat dat die codepagina niet kan representeren
De locale-bewuste RTL-functies zitten op Windows dus bij toeval goed, puur door hoe ze vandaag geïmplementeerd zijn. Code die met Excel moet overeenkomen, maakt de API-aanroep expliciet en zegt dat er ook bij. Het lastigere probleem verschijnt in elke formule-engine waar elk codepad grijpt wat toevallig het dichtstbij is: omzetten naar hoofdletters en code points vergelijken in de operatoren = en <, een hoofdlettergevoelige Variantvergelijking in de tak > / < van COUNTIF-criteria, weer een andere binnen VLOOKUP (precies de reden waarom VLOOKUP("ABC",A1:A20,1,FALSE) abc niet vindt), en een locale-aanroep in de bereiksortering. Elk pad is op zichzelf verdedigbaar. Samen leveren ze drie verschillende volgordes op over dezelfde kolom
Eén vergelijking achter formules, lookups en sorteren in HotXLS
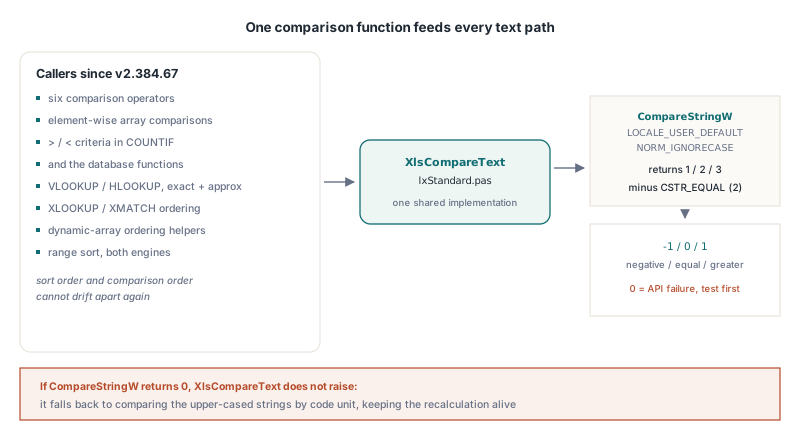
HotXLS stuurt elke tekst-tegen-tekst-vergelijking in zijn berekenings- en sorteercode door één functie, XlsCompareText in lxStandard.pas, die CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...) aanroept en er CSTR_EQUAL van aftrekt. De zes vergelijkingsoperators gebruiken hem, net als elementsgewijze vergelijkingen in arrayformules, de takken >, <, >= en <= van criteria in COUNTIF-stijl en de databasefuncties, VLOOKUP en HLOOKUP in exacte en benaderende modus, de ordening achter de dynamic-arrayfuncties en XLOOKUP / XMATCH, en SortRange op zowel TXLSWorksheet als TXLSXWorksheet. De bereiksortering op dezelfde functie zetten was het beslissende ontwerppunt. Benaderende VLOOKUP op tekst geeft alleen zinvolle antwoorden als de kolom gesorteerd was in de volgorde waarin de lookup vergelijkt, en doordat één functie wordt gedeeld kunnen die twee volgordes niet meer uit elkaar drijven
De snelste manier om de regel vanuit Delphi te zien is TXLSXWorkbook.Calculate, dat een formulestring tegen het actieve werkblad evalueert en het resultaat als Variant teruggeeft
uses
  System.Variants, lxHandleX;

var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Sheets.Add('Data');  // Calculate evalueert tegen het actieve werkblad
    Writeln(VarToStr(Book.Calculate('="a-b">"ab"')));   // True: het koppelteken breekt alleen gelijkspel
    Writeln(VarToStr(Book.Calculate('="a-b"="ab"')));   // False: gelijkspel gebroken, niet gelijk
    Writeln(VarToStr(Book.Calculate('="a~b"<"ab"')));   // True: leestekens eerst
    Writeln(VarToStr(Book.Calculate('="ABC"="abc"')));  // True: hoofdletters genegeerd
  finally
    Book.Free;
  end;
end;
Woordsortering gaat pas gelden zodra beide operands tekst zijn. Gemengde typen volgen een vaste rangschikking waarin elk getal onder elke tekstwaarde staat en elke tekstwaarde onder elke boolean, zoals beschreven in het artikel over vergelijkingsketens, lege operands en SUMIF. Wildcard-criteria zoals "a*" of "=ab" zijn patroon- en gelijkheidstesten met eigen regels, behandeld in de gids over Excel-wildcards in COUNTIF, MATCH en DSUM; de collation die hier wordt besproken bepaalt de ordeningsoperators
Het volgende voorbeeld laadt de 20 woorden in kolom A van een werkblad, controleert drie criteriumtellingen en een lookup, en sorteert daarna de kolom met TXLSXWorksheet.SortRange. De verwachte tellingen volgen direct uit de eerder getoonde sorteervolgorde: elf woorden sorteren na de groep ab, elf sorteren vóór a-b, en de drie leden van de groep ab komen bij die elf voor >=AB
const
  Words: array [0..19] of string = ('ab', 'a-b', 'a~b', 'a_b', 'AB', 'a b',
    'ab1', 'ab-', '-ab', 'abc', 'a''b', 'Ab', 'b', 'a.b', 'a1b', 'a0',
    #$00E9, 'e', 'f', 'Z');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Words');
    for i := 0 to High(Words) do
      Sheet.Cells[i + 1, 1].Value := WideString(Words[i]);

    // Verwacht uit de woordsorteringsvolgorde: 11, 11, 14
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">ab")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,"<a-b")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">=AB")')));

    // Vindt abc: de lookup vergelijkt hoofdletterongevoelig, zoals Excel dat doet
    Sheet.Cells[1, 3].Formula := '=VLOOKUP("ABC",A1:A20,1,FALSE)';
    Book.Recalculate;
    Writeln(VarToStr(Sheet.Cells[1, 3].Value));                // abc

    // Eén sleutelkolom, oplopend: a b, a.b, a_b, a~b, a0, a1b, ab, AB, Ab, ...
    Sheet.SortRange(1, 1, 20, 1, [1], [False]);
    for i := 1 to 20 do
      Writeln(VarToStr(Sheet.Cells[i, 1].Value));
  finally
    Book.Free;
  end;
end;
SortRange draait een stabiele merge sort, dus ab, AB en Ab, die als gelijk vergelijken, houden de relatieve volgorde die ze vóór de sortering hadden. Lege cellen gaan naar de onderkant, of de sleutel nu oplopend of aflopend is, en dat is precies waar Excel ze zet
Hoe match ik de sorteervolgorde van Excel in mijn eigen Delphi-code?
Om de tekstvolgorde van Excel buiten een workbook te reproduceren, roept u CompareStringW aan met LOCALE_USER_DEFAULT en NORM_IGNORECASE, en laat u SORT_STRINGSORT en NORM_IGNOREWIDTH weg. Let op de retourwaarde. De API geeft geen getekend resultaat terug; hij geeft CSTR_LESS_THAN (1), CSTR_EQUAL (2) of CSTR_GREATER_THAN (3) terug, en 0 als de aanroep faalt. Twee aftrekken geeft de gebruikelijke conventie negatief / nul / positief, maar pas nadat het geval 0 is afgehandeld, anders wordt een mislukte aanroep -2 en leest als "kleiner dan"
uses
  Winapi.Windows, System.SysUtils, System.Generics.Defaults,
  System.Generics.Collections;

// De tekstvolgorde van Excel: woordsortering van de gebruikerslocale, hoofdletterongevoelig
function ExcelCompareText(const A, B: string): Integer;
var
  R: Integer;
begin
  R := CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE,
    PWideChar(A), Length(A), PWideChar(B), Length(B));
  if R = 0 then
    RaiseLastOSError;          // 0 is een falen, geen vergelijkingsresultaat
  Result := R - CSTR_EQUAL;    // 1/2/3 worden -1/0/1
end;

var
  Keys: TArray<string>;
begin
  Keys := ['abc', 'a-b', 'AB', 'a~b', '-ab', 'ab'];
  TArray.Sort<string>(Keys, TComparer<string>.Construct(
    function(const L, R: string): Integer
    begin
      Result := ExcelCompareText(L, R);
    end));
  // a~b, ab / AB (gelijk, willekeurige volgorde), a-b, -ab, abc
end;
Staat HotXLS al in de uses-clausule, dan is lxStandard.XlsCompareText publiek en geeft dezelfde volgorde terug. De twee verschillen alleen bij een mislukte API-aanroep: de functie hierboven gooit een exception, terwijl XlsCompareText terugvalt op het vergelijken van de naar hoofdletters gevouwen strings op code unit, zodat een herberekening nooit halverwege wordt afgebroken. Voor een losse sortering is een exception de betere keuze, want een stilletjes verkeerde volgorde is lastiger terug te vinden
TArray.Sort is niet stabiel, dus gelijke sleutels zoals ab en AB kunnen in willekeurige volgorde uitkomen. Doet de oorspronkelijke volgorde van gelijke sleutels ertoe, sorteer dan een indexarray en gebruik de oorspronkelijke positie als secundaire sleutel
Soms moet een kolom opzettelijk níét de volgorde van Excel volgen. Onderdeelnummers zijn het klassieke geval: X-100 en X100 zijn verschillende codes en moeten op code point sorteren. SortRange heeft een overload die een TXLSSortCompareEvent neemt, gedeclareerd als function(const Left, Right: Variant): Integer of object, en gebruikt die in plaats van de ingebouwde vergelijking
uses
  System.SysUtils, System.Variants, lxStandard, lxHandleX;

type
  TPartNumberOrder = class
    function Compare(const Left, Right: Variant): Integer;
  end;

function TPartNumberOrder.Compare(const Left, Right: Variant): Integer;
begin
  // Een eigen comparer krijgt ook lege cellen (als Null): plaats ze zelf
  if VarIsNull(Left) or VarIsNull(Right) then
    Exit(Ord(VarIsNull(Left)) - Ord(VarIsNull(Right)));
  Result := CompareStr(VarToStr(Left), VarToStr(Right));   // ordinaal, hoofdlettergevoelig
end;

var
  Sheet: TXLSXWorksheet;   // een gevuld werkblad, rijen 2..501, kolommen A..D
  Order: TPartNumberOrder;
begin
  // ...
  Order := TPartNumberOrder.Create;
  try
    // gesleuteld op kolom A, oplopend
    Sheet.SortRange(2, 1, 501, 4, [1], [False], xlsSortByRows,
      xlsSortExcelLike, Order.Compare);
  finally
    Order.Free;
  end;
end;
Met een eigen comparer geeft SortRange de rauwe sleutelwaarden door en laat de plaatsing van lege cellen aan u over, vandaar dat de comparer hierboven eerst Null afhandelt. Voor een aflopende sleutel maakt de sortering het retour van de comparer negatief, dus in die richting schuiven lege cellen naar de top tenzij de comparer daar rekening mee houdt. Een kolom die zo gesorteerd is, staat niet meer in de volgorde die benaderende VLOOKUP of een binary-search XLOOKUP verwacht; wat er in die modi misgaat op data die in een andere volgorde is gesorteerd, staat in de gids over de binary-search-modi van XLOOKUP en XMATCH
Waarom kan hetzelfde workbook op een andere machine anders sorteren?
Een workbook kan op een andere machine anders sorteren omdat de tekstvolgorde van Excel afhangt van de Windows-gebruikerslocale, en HotXLS volgt die afhankelijkheid met opzet. Woordsortering is taalspecifiek. De Zweedse collation zet ä bijvoorbeeld na z, terwijl Engels en Duits haar naast a houden, dus een bestand dat een collega in Stockholm herberekent kan een andere COUNTIF(...,">y") teruggeven dan hetzelfde bestand op een desktop in Chicago. HotXLS geeft LOCALE_USER_DEFAULT door zodat zijn antwoorden op dezelfde machine gelijk zijn aan die van Excel. Een vaste locale vastpinnen oogt netter en zou HotXLS op elke anders geconfigureerde machine laten afwijken van Excel
Voor generatie aan de serverkant volgen daaruit drie praktische gevolgen:
- De locale die telt is die van het account waaronder het proces draait. Een Windows-service of IIS-application pool gebruikt misschien een andere regionale instelling dan de desktop van de ontwikkelaar, dus resultaten die in de IDE worden waargenomen zijn niet automatisch wat productie berekent
- Gecachte formuleresultaten die in het bestand worden weggeschreven weerspiegelen de locale van de genererende machine. Excel herberekent met zijn eigen locale, dus een waarde kan veranderen zodra het bestand elders wordt geopend en herberekend; Excel doet met zijn eigen bestanden precies hetzelfde
- Locales verschillen vooral op letters met accenten, op letterparen die sommige talen als één letter behandelen en op niet-Latijnse schriften. Testdata van kale Engelse woorden leggen het verschil nooit bloot, dus zet een paar namen als
ÅngströmenÖbergin het sample
Het pad dat Excel volgt, is het Windows-pad: elke Win32- en Win64-build, of die nu met Delphi, C++Builder, of Lazarus en Free Pascal is gecompileerd, roept dezelfde CompareStringW aan. Richt een build zich op een niet-Windows-platform, dan gebruikt XlsCompareText de WideCompareText van de RTL, waarvan de volgorde uit de eigen collation-bibliotheek van dat platform komt
Gewone woorden sorteren onder elke regel hetzelfde, waardoor een verkeerde collation de test doorgaans overleeft totdat codes met koppeltekens, leestekens of klantnamen met accenten opduiken. HotXLS geeft op die invoer het antwoord van Excel, in zowel de XLS- als de XLSX-engine, van de vergelijkingsoperators tot aan SortRange. Ondersteunde Delphi- en C++Builder-versies, licenties en de proefdownload staan op de HotXLS Delphi Excel component-pagina