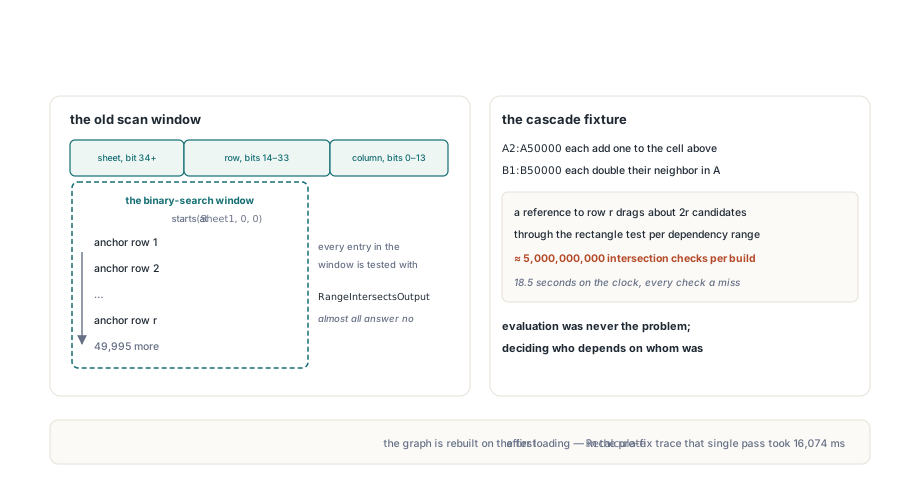
Een blad met 50.000 formules in kolom A, die elk één optellen bij de cel erboven, en nog eens 50.000 in kolom B die hun buurman verdubbelen, is ongeveer zo saai als een spreadsheetmodel kan zijn. Het evalueren kost 100.000 optellingen en vermenigvuldigingen. Het uitzoeken van de evaluatievolgorde kost veel meer als de edge-builder op de voor de hand liggende manier is geschreven: zoek elke formule vanaf de bovenkant van het gerefereerde blad tot de gerefereerde rij, test elk op overlap en houd de treffers bij. Voor dit ene blad komt dat neer op ruwweg vijf miljard rechthoektests, en bijna elke test antwoordt nee
Die vijf miljard is rekenkunde, geen stopwatchmeting. Een referentie naar rij r sleept zo'n 2r kandidaten in het zoekvenster, één per kolom voor elke rij erboven, en dat sommeren over 100.000 referenties landt in de miljarden. Het interessante is dat het venster echt bij de bovenkant van het blad moet beginnen, en dat om een reden die niets met luiheid te maken heeft
Waar een herbouwde dependency graph zijn tijd verliest
De herberekeningsengine van HotXLS bouwt zijn formule-afhankelijkheidsgraaf opnieuw zodra de formuletopenologie verandert: de eerste Recalculate nadat een werkmap is geladen of gegenereerd, en de eerste na het herschrijven van formules, het toevoegen of verwijderen van bladen of het klonen van een cellenblok. Beide workbook-klassen, TXLSWorkbook en TXLSXWorkbook, bouwen daarvoor een TXLSDepGraph uit de unit lxDepGraph. Elke formulecel wordt één knooppunt met een anker (Row, Col) en een uitvoerrechthoek die loopt tot (OutRow2, OutCol2). Bij een gewone formule is die rechthoek de ankercel zelf
Knooppunten staan geordend op een gepakte 64-bit sleutel uit XLSDepMakeKey: de kolom zit in bits 0–13, de rij in bits 14–33 en de bladindex vanaf bit 34. Sorteren op die sleutel geeft blad-gemajorde, rij-gemajorde volgorde, dus het vinden van de laatste formule die voor een referentie kan meespelen is één binaire zoekactie op (Sheet2, Row2, 16383). De eerste is het probleem. De ondergrens moet (Sheet1, 0, 0) zijn, de absolute bovenkant van het gerefereerde blad, en alles tussen de twee grenzen wordt kandidaat
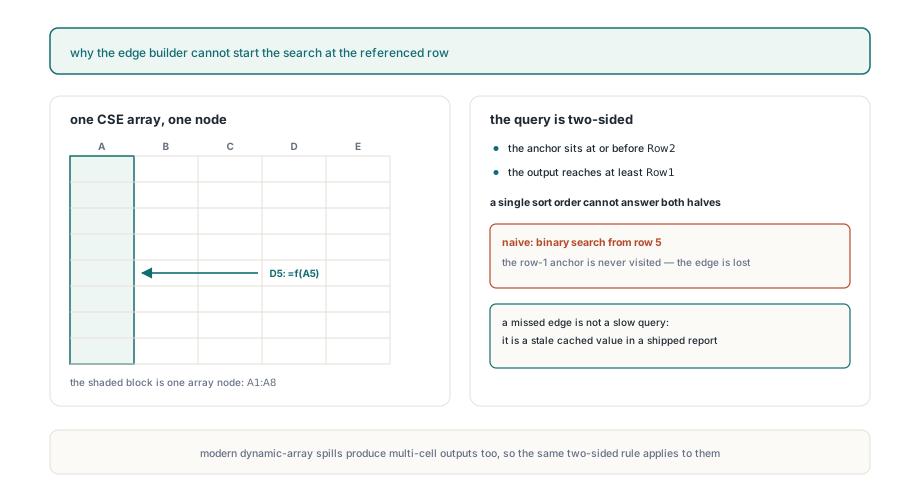
Waarom kan de zoektocht niet bij de gerefereerde rij beginnen?
Een array-formule die boven een bereik verankerd is, kan cellen erin bezitten. In een TXLSXWorkbook is een CSE-array in A1:A8 één knooppunt waarvan het anker A1 is en waarvan de uitvoer tot rij 8 reikt, zoals het artikel over incrementele herberekening en de dependency graph beschrijft. Een formule in D5 die alleen A5 leest, heeft nog steeds een edge van dat knooppunt nodig. Begin de binaire zoekactie op rij 5, dan wordt het anker op rij 1 nooit bezocht, wordt de edge nooit vastgelegd en kan D5 geëvalueerd worden vóór de array waar hij van afhangt. Het symptoom is een verouderde cachewaarde in het opgeslagen bestand, en dat valt veel moeilijker op dan een trage herberekening
De echte query heeft dus twee kanten. Een knooppunt is kandidaat wanneer zijn anker op of vóór Row2 ligt en zijn uitvoer minstens Row1 bereikt, op een blad binnen de referentie en met overlappende kolommen. Sorteren op anker beantwoordt de eerste helft. Over de tweede helft zegt ankerorde niets, want een formule op rij 3 kan één cel uitvoeren of duizend rijen. What-if-datatabellen hebben dezelfde vorm: TXLSXWorkbook registreert elke datatabel als één knooppunt dat zijn hele resultaatgebied bestrijkt. Dynamic-array-formules nemen een andere weg en worden als volatile gemarkeerd, zodat ze bij elke passage opnieuw worden berekend; het artikel over dynamic array spill-formules beschrijft hoe spilled ranges zich gedragen
TXLSDepGraph is een publieke klasse, dus het geval is makkelijk te reproduceren zonder werkmap. Bladindices zijn 1-based, rijen en kolommen 0-based, gelijk aan de coördinaten van de calculator. De probe hieronder registreert de array-wortel en de lezer, bouwt de edges, en voert bovendien een omgekeerde puntreferentie-keten uit door hetzelfde graaftype om de teller te laten zien waarop de volgende secties steunen
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // CSE-array: anker A1 (rij 0, kol 0), uitvoer tot A8 (rij 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5 (rij 4, kol 3) leest alleen A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, de A1-wortel
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: de A1-wortel en D5 zelf
  finally
    G.Free;
  end;

  // Keten A1..A100000, elke cel leest de cel erboven, van onder naar boven toegevoegd
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
Subbomen snoeien op hun grootste uitvoerrij
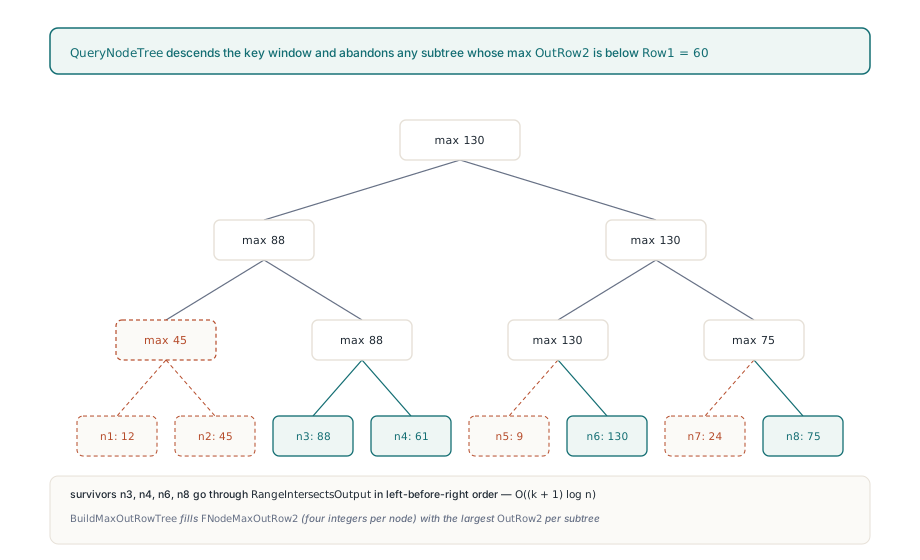
TXLSDepGraph.BuildEdges houdt de ankersortering voor de bovengrens aan en beantwoordt de ondergrens met een max-verrijkte segment tree over de gesorteerde volgorde. Elke tree-entry bewaart de grootste OutRow2 van alle knooppunten eronder. De query loopt alleen binnen het sleutelvenster naar beneden en laat elke subtree vallen waarvan de opgeslagen max boven Row1 ligt, want geen enkele formule in die subtree kan de gerefereerde rijen bereiken. Knooppunten die overleven krijgen nog steeds de volledige rechthoektest, dus blad-overspanning en kolommen worden exact als voorheen gecontroleerd
De techniek is klein genoeg om integraal te laten zien. De schets hieronder is een minimale versie die voor dit artikel is geschreven, met eigen namen; geen daarvan is HotXLS-API, en de arrays mag de lezer zelf vullen vanuit een lijst van uitvoerrijen die al op ankorsleutel gesorteerd is
uses
  System.Math, System.Generics.Collections;

// Alleen een schets: een max-verrijkte segment tree over knooppunten gesorteerd op ankorsleutel.
// OutRow2[i] is de laatste uitvoerrij van het i-de knooppunt in gesorteerde volgorde.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// Verzamelt, van links naar rechts, elk knooppunt in [Lo, Hi) waarvan de uitvoer Row1 bereikt
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // buiten het venster, of niets bereikt Row1
  if L = R then
  begin
    Hits.Add(L);                 // de aanroeper draait nog steeds de volledige rechthoektest
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // eerst links
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // houdt de scanvolgorde vast
end;

// Eenmaal bouwen met BuildMax(Ix, 1, 0, Count - 1),
// dan per referentie Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits) aanroepen
Per referentie daalt het werk van de grootte van het venster naar O((k + 1) log n), waar k het aantal knooppunten is waarvan de uitvoer de gerefereerde rijen echt bereikt. Terug op het openingsmodel: een referentie van Br naar Ar test nu twee rechthoeken, Ar en Br zelf, en een referentie van Ar naar de cel erboven test de twee knooppunten op die rij. Met de hand komt dat neer op zo'n 200.000 tests voor de hele bouw in plaats van vijf miljard
Dezelfde edges, in dezelfde volgorde
De links-vóór-rechts-recursie is belangrijker dan hij lijkt. Overlevende knooppunten worden in exact de volgorde bezocht die een kale lus over het venster ook zou volgen, dus de arrays Dependents en Precedents van elk knooppunt vullen zich in dezelfde volgorde, en de topologische volgorde die eruit wordt opgebouwd komt bij elke run hetzelfde uit. Die volgorde is niet alleen interne boekhouding: wanneer de graaf actueel is, schrijft de XLSX-writer xl/calcChain.xml in de volgorde waarin FullTopoOrder teruggeeft, dus een niet-deterministische bezoekvolgorde zou zichtbaar worden als ruis in diffs tussen twee opslagbeurten van een ongewijzigde werkmap
Ook de edge-soorten houden hun regels. Referenties in het lookup-array-argument van VLOOKUP, MATCH, XLOOKUP en vergelijkbare functies leveren lookup-scan-edges op, die dirtiness doorgeven maar buiten cyclusdetectie blijven. Als een knooppunt zowel een harde referentie als een lookup-referentie naar hetzelfde precedensknooppunt heeft, onderdrukt een eerst vastgelegde harde edge de latere scan-edge, en behoudt een eerst vastgelegde scan-edge zijn plek terwijl de harde edge toch wordt toegevoegd. Juist die volgorde houdt lookup-bereiken weg van valse circulaire referenties, en hij houdt alleen stand als de gesnoeide wandeling kandidaten in scanvolgorde bezoekt
De property EdgeCandidateChecks maakt het snoeien waarneembaar. Hij telt de uitvoerrechthoeken die de meest recente BuildEdges-aanroep echt getest heeft en zet terug op nul bij het begin van elke bouw. In de probe hierboven meldt de omgekeerde keten 99.999, één test per referentie, hoewel de knooppunten van onder naar boven waren toegevoegd en de sortering ze allemaal moest herschikken. AddNode markeert zowel de sortering als de edges als verouderd, zodat de volgende BuildEdges of NodeIndexOf de index opnieuw bouwt in plaats van hem bij te plakken
Waar de resterende kost zit
De boom snoeit alleen op rijen, en die keuze bepaalt waar een groot model nog voor betaalt
- Kolommisses worden betaald bij de bladeren: de 2.626 formules die
A100:Z200vullen bereiken allemaal rij 100, dus een referentie naarAA100:AA200test elk van hen af op de kolommen - Hele-kolom- en andere brede referenties hebben echt veel precedents; de index schaft de verspilde tests af, en het bouwen van de echte edges blijft evenredig met hun aantal
- Een referentie die over meerdere bladen loopt, opent een venster dat het hele eerste blad bestrijkt, dus formules daar met diepe uitvoer komen tot aan de bladtest; de edges komen hetzelfde uit en alleen het snoeien is zwakker
- De boom kost vier integers per knooppunt, zo'n 1,6 MB bij 100.000 formules, en elke topologieverandering betaalt bij de volgende edge-bouw een volledige O(n log n) hersortering plus een O(n)-bouwsessie van de boom
Rijen zijn de juiste enige dimensie om te indexeren. Gegenereerde rapporten, grootboeken en financiële modellen groeien naar beneden, dus de rijafstand is waar bijna alle verspilde kandidaten vandaan komen, terwijl een kolommiss door de rechthoektest wordt afgestreept in een handjevol integervergelijkingen. Een tweede dimensie in de boom zou elke query ingewikkelder maken om tests te sparen die al goedkoop zijn
Aan de aanroepkant is de dure stap de herbouw, en waarde-wijzigingen triggeren hem niet. Recalculate bouwt de graaf bij zijn eerste aanroep; latere aanroepen her-evalueren alleen formules stroomafwaarts van gewijzigde waarden, plus de volatile. Alle formules eerst wegschrijven en één keer herberekenen is het patroon om na te jagen. De harness hieronder meet beide soorten passage op de klassieke engine, waar Recalculate het aantal formulecellen teruggeeft dat hij niet kon evalueren; draai hem op de hardware waar de batchjob straks staat, want absolute tijden hangen sterk van de machine af
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // keten van 49.999 schakels in kolom A
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // 50.000 dependents in kolom B
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // bouwt de graaf, evalueert alles
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // waarde-wijziging: de graaf wordt hergebruikt
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // alleen de vervuilde subgraaf
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
In dit model her-evalueert de waardepass nog steeds alle 99.999 formules, want de hele kolom A hangt aan A1; wat hij overslaat is de graafbouw. Een formulecel overschrijven met een kale waarde is iets anders, want dat verandert de topologie en de volgende Recalculate bouwt de graaf vanaf nul opnieuw
Dezelfde kwadratische vorm in gekloonde gedefinieerde namen
Rapportbanden verbergen hetzelfde patroon op een andere plek. TXLSXWorksheet.CloneRangeTo kopieert gedefinieerde namen die rechtstreeks naar een bereik in het gekloonde blok wijzen, en elke kopie heeft een naam nodig die uniek is in zijn scope: Total_2, Total_3, enzovoorts. Een zoektocht die bij elke kopie opnieuw bij _2 begint, peilt elke keer één kandidaat extra, dus een blad dat uit honderden gekloonde banden is opgebouwd, spendeert een kwadratisch aantal naamzoektochten aan het benaming alleen
TXLSXDefinedNames voorkomt dat met een suffixhint in zijn naamindex, één per basisnaam en scope. De volgende zoektocht begint bij het suffix dat de vorige teruggaf en controleert dat eerst opnieuw, want de aanroeper mag die naam ook niet toevoegen. Een naam verwijderen, hernoemen via Name, verplaatsen met SheetIndex of de collectie leegmaken, smijt de index samen met alle hints weg, dus de volgende kloon gaat terug naar het eerste vrije suffix en vult elk gat dat de wijziging opende
Voor Delphi- en C++Builder-toepassingen die grote spreadsheets genereren of herberekenen, gebruikt de HotXLS Excel-component voor Delphi en C++Builder deze geïndexeerde afhankelijkheidsgraaf in de herberekeningsengine van zowel zijn klassieke als zijn XLSX-workbook-klasse