Een gedefinieerde naam die naar een hele kolom verwijst, leest Excel als één cel wanneer hij in een scalaire positie staat: =Vertical+1 in rij 7 betekent "de cel van rij 7 van Vertical", niet het hele gebied. De HotXLS Delphi Component past die impliciete doorsnijding in v2.382.4 op twee niveaus toe, tijdens de evaluatie en tijdens het extraheren van afhankelijkheden, omdat een leningtemplate met 4805 formules liet zien dat de waarde goed krijgen niet genoeg is. Wanneer de afhankelijkheidswalker de naam naar zijn volledige gebied uitklapt, sluit een formule stroomafwaarts die op een cel van dat gebied voedt een cyclus die niet bestaat, en weigert TXLSXWorkbook.Recalculate de hele workbook
De template in kwestie is een standaard aflossingsworkbook voor een lening. Met elke gecachte waarde vergiftigd naar 777 en een volledige Recalculate-run gaven beide engine-architecturen 23 terug, de code lxErrorRef voor een circulaire verwijzing. 3842 van de 4805 formules kwamen niet overeen met de onafhankelijke verwachting, B18 bevatte #VALUE!, E18 stond nog steeds op 777, en het aantal betalingen in J7 had de placeholders gelezen in een onvoltooide balanskolom. Achter één retourcode zaten drie afzonderlijke defecten verscholen, en dit artikel loopt ze alle drie langs met de code die ze heeft verholpen
Waarom veroorzaakt een scalaire verwijzing naar een kolomnaam een valse cyclus?
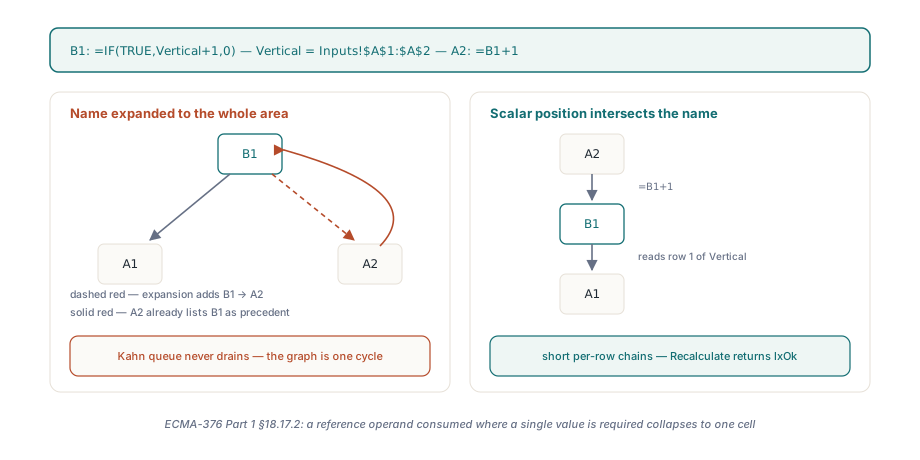
Omdat een afhankelijkheidsgraaf alleen randen kent, en een rand van een formule naar een gebied van 480 rijen zijn 480 randen, waarvan er één terugwijst via een cel die van de formule afhangt. Neem =IF(TRUE,Vertical+1,0) in B1 met Vertical gedefinieerd als Inputs!$A$1:$A$2, en =B1+1 in A2. Excel evalueert B1 als A1+1 en A2 als B1+1, een simpele keten. Een walker die B1 vastlegt als afhankelijk van A1:A2 maakt A2 tot precedent van B1, A2 vermeldt B1 al als precedent, en de Kahn-wachtrij die de incrementele herberekening in HotXLS aandrijft, ziet geen van beide knopen ooit in-degree nul bereiken. Dit is het patroon waarvan leningtemplates gemaakt zijn: elke perioderij verwijst naar benoemde kolommen voor de balans, de rente en het aantal betalingen, elke naam omvat het hele schema, en elke rij schrijft ook in die kolommen. Klap de namen uit en de graaf is één grote sterk samenhangende component. Evalueer ze met impliciete doorsnijding en de graaf is een reeks korte ketens, één per rij, precies wat ECMA-376 Part 1 §18.17.2 beschrijft voor een verwijzingsoperand dat gebruikt wordt waar één waarde vereist is
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Scalaire positie: Vertical klapt samen tot A1 omdat de formule in rij 1 staat
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Een naam waarvan de definitie een andere naam is, doorsnijdt nog steeds, dus dit is A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Argument van referentieklasse: het hele gebied wordt opgeteld, geen doorsnijding
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // Rij 6 ligt buiten A1:A2, de doorsnijding is leeg en IFERROR vangt dat op
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Vóór v2.382.4 was deze tak onbereikbaar: B1 -> A2 -> B1 was een cyclus
    end;
  finally
    Book.Free;
  end;
end;
Hoe bepaalt HotXLS dat een argument scalair is?
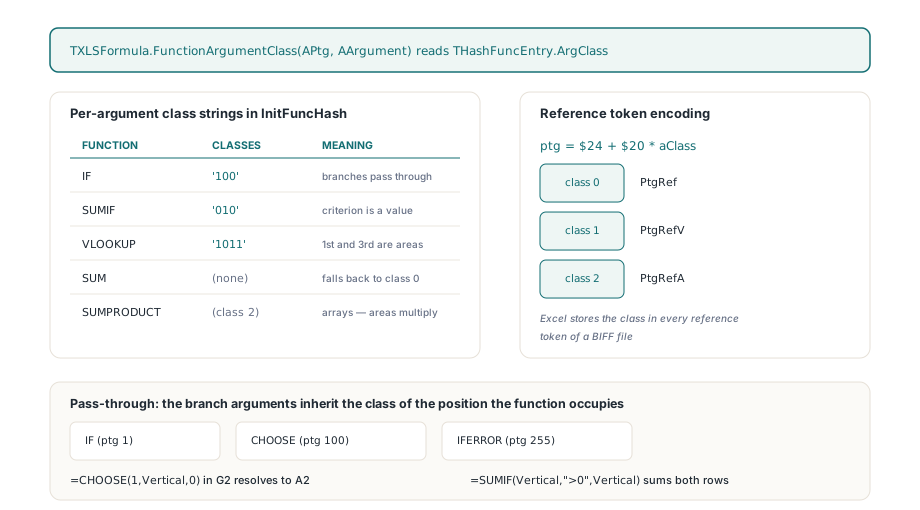
HotXLS leest het antwoord uit de functietabel en niet uit de vorm van het argument. Elk item in TXLSFormula.InitFuncHash wordt geregistreerd via THashFunc.SetValue met een optionele klassestring per argument: 'IF' draagt '100', 'SUMIF' draagt '010', 'VLOOKUP' draagt '1011', en 'SUM' draagt er geen, dus al zijn argumenten vallen terug op klasse 0 op functieniveau. De nieuwe TXLSFormula.FunctionArgumentClass(APtg, AArgument) stelt die byte beschikbaar via THashFuncEntry.ArgClass, en een resultaat van 1 betekent waardeklasse. Het zijn dezelfde drie klassen die [MS-XLS] §2.2.2 aan operandtokens toekent, en de encoder hing er al van af: bij het schrijven van een verwijzing berekent hij de ptg als $24 + $20 * aClass, wat PtgRef oplevert voor klasse 0, PtgRefV voor klasse 1 en PtgRefA voor klasse 2. Een BIFF-bestand dat Excel schrijft bewaart die klasse in elk verwijzingstoken, dus een engine waarvan de tabel met de spec overeenkomt kan "is dit argument scalair" beantwoorden zonder naar de data te kijken. Het middelste argument van SUMIF is het criterium, een waarde; het eerste en het derde zijn gebieden, verwijzingen. SUMPRODUCT is geregistreerd met klasse 2 op functieniveau, array, en daarom vermenigvuldigt =SUMPRODUCT(Vertical,Vertical) nog steeds het hele gebied
Drie functies raadplegen hun eigen tabelitem niet voor iets na het eerste argument. IF (ptg 1), CHOOSE (ptg 100) en IFERROR (ptg 255) geven door wat ze selecteren, dus hun takargumenten erven de klasse van de positie die de functie zelf inneemt. Die ene regel is wat =CHOOSE(1,Vertical,0) in G2 naar A2 laat verwijzen terwijl =SUMIF(Vertical,">0",Vertical) ernaast nog steeds beide rijen optelt, en het is de regel die een aflossingsschema het meest gebruikt, want de periodecellen leunen op IF om te testen of de lening nog openstaat
De klasse door de afhankelijkheidswalk dragen
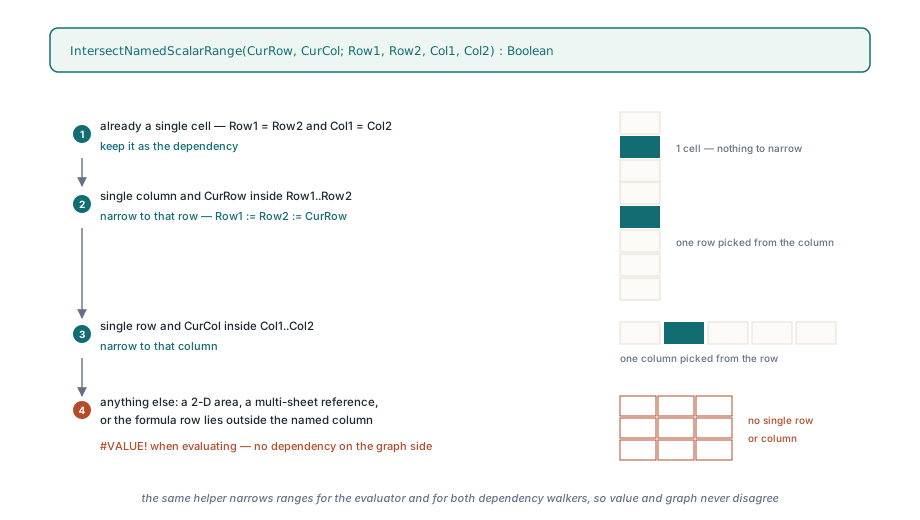
De afhankelijkheidsextractor in lxCalc.pas is een recursieve Walk over de gecompileerde syntaxisboom, en hij bestaat twee keer, één keer in TXLSCalculator.ExtractDependencies voor de graaf per workbook en één keer in ExtractWorkspaceDependencies voor de graaf over workbooks heen. v2.382.4 geeft beide walkers twee extra parameters. AScalar begint op True bij de wortel van een formule, wordt voor elk functiekind opnieuw berekend uit FunctionArgumentClass, en gaat onveranderd door voor de takargumenten van ptg 1, 100 en 255. ANameRoot wordt alleen True wanneer de walker afdaalt in de gecompileerde definitie van een naam, en hij overleeft alleen via SA_GROUP-knopen, de haakjes, zodat een naam gedefinieerd als =A1:A2+1 niet voor een gewoon gebied wordt aangezien. Wanneer beide flags True zijn bij een SA_RANGE-knoop, beperkt AddResolvedRange het gebied met dezelfde helper die de evaluator gebruikt voordat hij de afhankelijkheid vastlegt. De helper is kort genoeg om volledig te citeren
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // is al een cel
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // enkele kolom: neem deze rij
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // enkele rij: neem deze kolom
    Result := True;
  end;
end;
Alles wat de helper afwijst, een tweedimensionaal gebied, een verwijzing over meerdere bladen of een formule waarvan de rij buiten de benoemde kolom valt, levert #VALUE! op aan de evaluatiekant en helemaal geen afhankelijkheid aan de graafkant, wat Excel ook doet bij een lege doorsnijding. De evaluatiekant zit in TXLSCalculator.GetValueItemName: die stript SA_GROUP-wrappers van de gecompileerde definitie, en als de wortel een SA_RANGE is roept hij GetRangeInfo aan, doorsnijdt, en haalt de ene cel op via FGetValue in plaats van de hele definitie te evalueren. Externe verwijzingen blijven op het oude pad, want er is geen lokale rij om tegen te doorsnijden. Waar de opslag en scope van een naam vandaan komen, staat in het artikel over gedefinieerde namen en formules over bladen heen; het punt hier is alleen wat de engine doet zodra de naam is opgelost
Waarom las MATCH over een half berekende kolom 777?
Omdat het opzoekmatrix-argument van MATCH een scanverwijzing is, en scanverwijzingen waren bewust uitgesloten van de evaluatieorde. Het artikel over opzoekscans introduceerde TXLSDepRange.LookupScan en sloot af met een paragraaf "Wat je opgeeft door scanranden uit de ordening te houden": een opzoekformule kan draaien voordat elke cel in zijn bereik opnieuw is berekend en verouderde waarden lezen. In een interactieve sessie convergeert dat op de volgende ronde. In een batchherberekening van een vergiftigde template gebeurt dat niet, en PaymentCount, gedefinieerd als =MATCH(0.01,Balances,-1)+1, las de 777-placeholders die nog in de balanskolom stonden en gaf een periodeaantal terug dat niet kon kloppen
TXLSDepGraph.TopoOrder behandelt scanranden nu als zachte ordeningsranden. Naast de harde in-degree houdt hij een ScanInDeg-array bij, die per knoop de vuile scanprecedenten telt en die waarde verlaagt zodra die precedenten worden uitgevoerd, met de lijsten ScanPrecedents, ScanDependents en ScanPrecedentCount die de eerdere wijziging al bijhield. Bij elke iteratie scant de Kahn-wachtrij zijn klaarvenster voor de eerste knoop waarvan ScanInDeg nul is en verwisselt die naar de kop; als elke klaar knoop nog op een scanprecedent wacht, wordt de kop in zijn stabiele volgorde eruit gehaald. Scanranden komen nooit in de harde in-degree, dus een zelfverwijzende VLOOKUP over zijn eigen kolom blijft legaal, maar een opzoeking die op een afrondbaar precedent kan wachten doet dat nu. De regressie die dit vastpint, LookupScan_WaitsForDirtyFormulaValues, vergiftigt drie balancelcellen naar 777 en verwacht dat PaymentCount als 3 terugkomt, zet de invoer daarna op nul en verwacht dat =IFERROR(PaymentCount,99) de #N/A ziet en 99 teruggeeft
Waar kwam de afkapping op vier decimalen vandaan?
Uit Delphi Variant-rekenkunde, en alleen op geneste posities. De binaire operatoren in TXLSCalculator.GetValueItem kopieerden een + of - op het hoogste niveau al naar twee Double-locals, dus =B1-A1 was in orde. Binnen =IF(TRUE,B1-A1,0) liep dezelfde aftrekking als Value := Value - SubValue op twee Variants, en wanneer de ene operand een Int64-celwaarde was en de andere een Double, was het resultaat dat we zagen een Currency, een fixed-pointtype met vier decimalen, dus 1066.1854641400994 min 120 kwam terug afgekapt op vier decimalen. Over een schema waar elke betaling uit de vorige rij wordt samengesteld, loopt die fout door honderden perioden voordat hij de totalen bereikt
// TXLSCalculator.GetValueItem, tak voor binaire rekenkunde (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Gemengde Int64/Double Variant-rekenkunde kan promoveren naar Currency.
// Spreadsheet-rekenkunde moet floating-point-precisie behouden.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
De bewaking loopt voor SA_ADD, SA_SUB, SA_MUL en SA_DIV alle vier, en de regressie Arithmetic_MixedInt64AndDoubleKeepsPrecision zet Int64(120) in A1 en 1066.1854641400994 in B1, en controleert het geneste verschil en de som op 1E-10 en het product en quotiënt op 1E-8 en 1E-12. HotXLS beweert niet elke promotieregel te kennen die de RTL op gemengde Variant-types toepast over compilerversies heen; het beweert dat spreadsheet-rekenkunde IEEE-double is, en het maakt nu beide operanden double voordat de operator ze ziet, wat de vraag wegneemt
Wat de fix garandeert, en wat niet
Na v2.382.4 geven beide engine-architecturen lxOk terug voor de vergiftigde template, komen alle 4805 gecachte waarden binnen 1E-7 overeen met de onafhankelijke rij-per-rij-verwachting, en houden de asserties stand dat de caches echt vergiftigd waren, dat de bronhash onveranderd is en dat elke formule nog aanwezig is. Er is geen iteratie aangezet en geen foutcode onderdrukt om daar te komen. Een echte cyclus via een naam, =B1 in A1 terwijl B1 nog Vertical leest, geeft nog steeds een fout terug, en de test NamedScalarRanges_IntersectWithoutFalseCycles eindigt met precies die assertie
De grenzen zijn het waard om gewoon te benoemen. Impliciete doorsnijding geldt alleen voor een naam waarvan de gecompileerde definitie, na het strippen van haakjes, een gebied van één kolom of één rij op één blad is; een tweedimensionale naam in een scalaire positie is #VALUE!, net als in Excel, en een functie die de tabel niet kent krijgt klasse 0 van FunctionArgumentClass, dus zijn naamargumenten worden nog volledig uitgeklapt. De zachte ordening is een voorkeur, geen garantie: een cyclus met alleen scanranden evalueert nog in stabiele volgorde en leest wat er gecacht is, en dat is het gedrag dat het opzoekscan-artikel bewust accepteerde. En het resultaat over de hele template is geverifieerd tegen een onafhankelijk verwachtingsscript, niet tegen een andere spreadsheet-engine, omdat de referentie-officesuite de originele template niet binnen een budget van 60 seconden klaar kreeg met herberekenen. HotXLS is een native spreadsheetcomponent voor Delphi en C++Builder die XLS, XLSX, ODS en CSV leest, herberekent en schrijft zonder geïnstalleerde Excel; de naamdoorsnijding, de argumentklassetabel en de zachte scanordening gelden voor elk formaat omdat de rekenengine gedeeld is, en de actuele functiedekking staat op de productpagina van de HotXLS Delphi spreadsheet component