HotXLS reproduceert Excel-trendline-vergelijkings- en R-squared-labels in Delphi via XLSTrendlineEquationLabel in de unit lxStandard. De functie fit de punten van de eigenareeks voor lineaire, exponentiële, logaritmische, polynomiale (orde 2 tot 6), power- en moving average-trendlines, en geeft dezelfde tekst terug die Excel in DataLabel.Text meldt, codepunt voor codepunt, of False wanneer de fit ongedefinieerd is
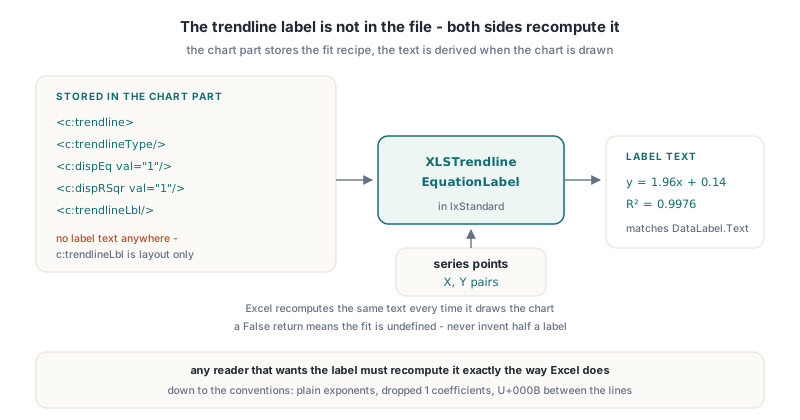
De reden dat dit überhaupt een functie nodig heeft is dat het label niet in het bestand staat. Een XLSX-grafiek bewaart een c:trendline-element met een c:trendlineType, de schakelaars c:dispEq en c:dispRSqr en een optionele c:trendlineLbl voor positie en opmaak, maar ECMA-376 DrawingML Charts geeft het label geen eigen tekst. Excel herberekent y = 1.96x + 0.14 elke keer dat hij de grafiek tekent. Elke Delphi-code die die tekst wil tonen, exporteren, doorzoeken of vergelijken zonder Excel te starten, moet hem ook herberekenen, en wel precies zoals Excel dat doet, tot aan de spatiëring rond het minteken
Waarom formatteert u de regressiecoëfficiënten niet gewoon zelf?
Met de hand geformatteerde coëfficiënten matchen bijna nooit het Excel-label, want het label volgt verschillende kleine conventies die makkelijk te missen en makkelijk tegen te controleren zijn. HotXLS heeft die conventies bevroren uit live Excel COM-teruglezingen van DataLabel.Text op een spreidingsgrafiek, en daarna de formatter tegen die oracle geschreven in plaats van tegen intuïtie
De conventies die in de praktijk bijten:
- Exponenten zijn kale tekens in de labeltekst. Het polynomiale label leest
x2, nietx², en het power-label leestx0.9732; de verhoogde look is een renderattribuut van de grafiek, geen deel van de string - Het enige niet-ASCII-teken is de U+00B2 superscript-twee in het prefix
R² = - Een coëfficiënt van exact 1 of -1 valt weg, dus Excel schrijft
y = x + 3, niety = 1x + 3 - Termen worden via hun tekens met spaties samengevoegd (
+en-), terwijl een vooraanstaande negatieve coëfficiënt een kale min krijgt, als iny = -0.0429x2 + 2.2171x - 0.16 - Wanneer Excel beide regels toont, voegt
DataLabel.Textze samen met U+000B, een vertical tab, geen CR/LF-paar
De getalnotatie is ook begrensd. XLSTrendlineEquationLabel print nul als 0, schakelt over op wetenschappelijke notatie met één cijfer zoals 2E+06 wanneer de orde van grootte onder 0.0001 of op ten minste 1000000 zit, en gebruikt anders vaste notatie met vier decimals tot 99.9999, één minder per verdere gehele cijfer, met afgekapte volgnullen. Daarom verschijnt 1.96 als 1.96 en niet als 1.9600
XLSTrendlineEquationLabel aanroepen vanuit Delphi
XLSTrendlineEquationLabel neemt de trendlinesoort als integer-ordinaal van TXLSXChartTrendlineType, een polynomiale orde, een open array van TXLSTrendlineLabelPoint-records met velden X en Y, en de twee weergaveschakelaars aan. Hij geeft de vergelijkings- en R-squared-strings terug via out-parameters als WideString, waarbij een string leeg blijft wanneer zijn schakelaar uit staat. Het orderargument telt alleen voor xlsxTrendPolynomial; geef 0 mee voor de andere soorten
uses
  lxStandard, lxHandleX;

procedure ShowFiveTrendlines;
const
  YS: array[0..4] of Double = (2.1, 3.9, 6.2, 8.1, 9.8);
var
  Points: array[0..4] of TXLSTrendlineLabelPoint;
  Eq, R2: WideString;
  I: Integer;
begin
  for I := 0 to 4 do
  begin
    Points[I].X := I + 1;
    Points[I].Y := YS[I];
  end;

  // Lineair: Eq = 'y = 1.96x + 0.14', R2 = 'R' + #$00B2 + ' = 0.9976'
  if XLSTrendlineEquationLabel(Ord(xlsxTrendLinear), 0, Points,
    True, True, Eq, R2) then
    Writeln(Eq, ' | ', R2);

  // Polynoom orde 2: 'y = -0.0429x2 + 2.2171x - 0.16', R2 0.9983
  if XLSTrendlineEquationLabel(Ord(xlsxTrendPolynomial), 2, Points,
    True, True, Eq, R2) then
    Writeln(Eq, ' | ', R2);

  // Exponentieel: 'y = 1.6767e0.3812x', R2 0.9386
  if XLSTrendlineEquationLabel(Ord(xlsxTrendExponential), 0, Points,
    True, True, Eq, R2) then
    Writeln(Eq, ' | ', R2);

  // Dezelfde tekst die Excel in DataLabel.Text stopt wanneer beide regels worden getoond
  Eq := Eq + #$000B + R2;
end;
De vijf waarden in dat voorbeeld zijn de bevroren Excel-oracle die de HotXLS-testsuite voor elke familie controleert. De logaritmische fit komt terug als y = 4.7635ln(x) + 1.4589 met R² = 0.9519, en de power-fit als y = 2.0719x0.9732 met R² = 0.9978. Wijkt uw output op dezelfde data van Excel af, dan zijn library en oracle het oneens, en dat is een bug die het melden waard is, geen afrondingsvoorkeur
Hoe berekent Excel R-squared voor exponentiële en power-trendlines?
Voor het trendline-label is R-squared de gekwadrateerde Pearson-correlatie tussen de gefitte waarden en de werkelijke Y-waarden in de originele dataruimte, en XLSTrendlineEquationLabel berekent hem op dezelfde manier. De coëfficiënten van een exponentiële, logaritmische of power-fit komen nog steeds uit gewone kleinste-kwadraten op log-getransformeerde data: ln(y) tegen x voor exponentieel, y tegen ln(x) voor logaritmisch, en ln(y) tegen ln(x) voor power. Alleen het goodness-of-fit-getal wordt terug gemeten in het natuurlijke domein
Dit is het detail dat de meeste reimplementaties verkeerd doen, want de handboekaanpak meet R-squared in de getransformeerde ruimte waar de lijn is gefit. Op de oracle-populatie laat het verschil zich al zien in de tweede decimal. De exponentiële fit in getransformeerde ruimte geeft 0.9477, terwijl het label van Excel, live teruggelezen, R² = 0.9386 zegt, de correlatie in het natuurlijke domein. Een labelgenerator die zijn regressiestatistieken uit de getransformeerde ruimte hergebruikt print het verkeerde getal op de eerste grafiek die een gebruiker vergelijkt
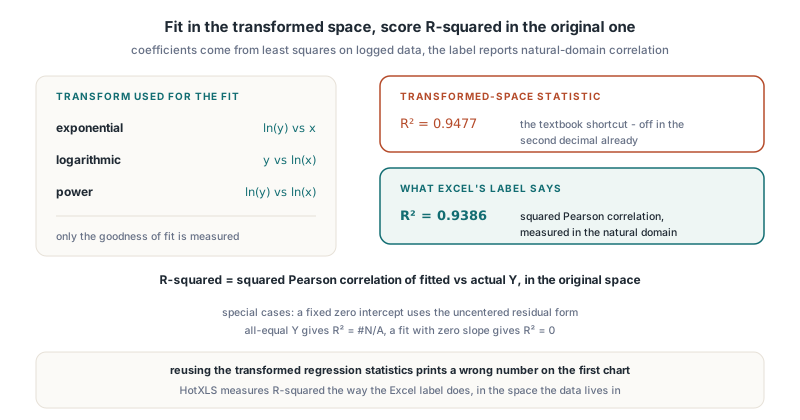
Twee speciale gevallen veranderen de formule. Een lineaire trendline met een vast snijpunt van nul gebruikt de ongecentrerde residuele vorm, 1 minus de residukwadratensom over de som van gekwadrateerde Y-waarden, wat matcht met wat Excel voor die configuratie toont. Een populatie waarvan alle Y-waarden gelijk zijn heeft geen variantie te verklaren, dus het resultaat is R² = #N/A naast een constante vergelijking als y = 5. Een niet-constante populatie waarvan de fit toevallig helling nul heeft krijgt in plaats daarvan R² = 0
Vaste intercepts en de tweede overload
De tweede overload van XLSTrendlineEquationLabel voegt InterceptSet: Boolean en Intercept: Double vóór de outputparameters toe, wat het c:intercept-element van de trendline en de eigenschappen InterceptSet en Intercept van TXLSXChartTrendline weerspiegelt. Excel biedt alleen een vaste intercept voor lineaire, exponentiële en polynomiale trendlines, en de functie handhaaft dezelfde regel: een vaste intercept op een logaritmische of power-fit geeft False terug, en een exponentiële fit heeft een positieve intercept nodig omdat de fit met diens logaritme werkt
procedure LabelForTrendline(Trend: TXLSXChartTrendline;
  const Points: array of TXLSTrendlineLabelPoint);
var
  Eq, R2: WideString;
begin
  if not XLSTrendlineEquationLabel(Ord(Trend.TrendlineType), Trend.Order,
    Points, Trend.DispEq, Trend.DispRSqr, Trend.InterceptSet,
    Trend.Intercept, Eq, R2) then
  begin
    // Ongedefinieerde fit: verzijn geen label
    Writeln('No label for this trendline');
    Exit;
  end;
  if Eq <> '' then Writeln(Eq);
  if R2 <> '' then Writeln(R2);
end;

procedure AddQuadraticThroughOrigin(Series: TXLSXChartSeries);
var
  Trend: TXLSXChartTrendline;
begin
  Trend := Series.AddTrendline(xlsxTrendPolynomial);
  Trend.Order := 2;
  Trend.DispEq := True;
  Trend.DispRSqr := True;
  Trend.InterceptSet := True;
  Trend.Intercept := 0;
end;
De eigenschappen van de trendline zelf rechtstreeks in de overload voeden houdt het label in de pas met wat het werkboek Excel zal laten tekenen. Wanneer InterceptSet op False staat, wordt de waarde Intercept genegeerd, dus de eigenschap onvoorwaardelijk meegeven is veilig. Een vaste intercept verlaagt ook de punteis met één: een polynoom van orde n heeft normaal n + 1 punten nodig, maar slechts n wanneer de constante term is vastgepind
Welke X-waarden gebruikt een Line chart-trendline werkelijk?
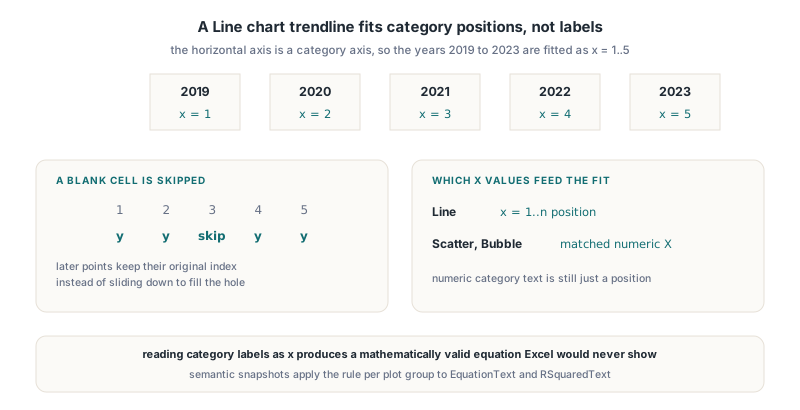
Een trendline op een gewone Line chart fit tegen de 1-based categoriepositie, niet het categorielabel, ook wanneer de labels getallen zijn. Excel behandelt de horizontale as van een Line chart als een categorie-as, dus een reeks uitgezet over de jaren 2019 tot 2023 wordt gefit als x = 1..5 en de intercept van de vergelijking weerspiegelt dat. Scatter- en Bubble-grafieken zijn anders: die fitten tegen de gematchte numerieke X-waarden van elk punt
HotXLS heeft dit op de harde manier geleerd. De eerste versie van de semantische snapshotprojectie las numerieke categorietekst als de werkelijke x, wat een wiskundig geldige vergelijking opleverde die Excel nooit zou tonen. De opvolgende fix verplaatste Line-fits naar de originele categoriepositie voor elke categorie, numeriek of niet, en zette ook vast wat er met gaten gebeurt: een lege Y-cel valt buiten de fit, maar latere punten houden hun originele index in plaats van omlaag te schuiven om het gat te vullen. Achter de kalenderaccurate datumasticks in HotXLS-grafieken zit hetzelfde onderscheid tussen categorieposities en echte waarden
uses
  Math, lxStandard, lxHandleX;

// Values bevat een Line-reeks in categorievolgorde; NaN markeert een lege cel
function LinePointsFromCategories(const Values: array of Double):
  TArray<TXLSTrendlineLabelPoint>;
var
  I, N: Integer;
begin
  SetLength(Result, Length(Values));
  N := 0;
  for I := 0 to High(Values) do
  begin
    if IsNan(Values[I]) then
      Continue;                  // sla de lege cel over, houd latere indices aan
    Result[N].X := I + 1;        // 1-based categoriepositie
    Result[N].Y := Values[I];
    Inc(N);
  end;
  SetLength(Result, N);
end;
Deze stap verkeerd doen en alle andere conventies in dit artikel zijn verspild, want het label is dan correct geformatteerde tekst voor de verkeerde regressie. Werkboek-semantische snapshots in HotXLS passen de regel al per plotgroep toe wanneer ze de eigenschappen EquationText en RSquaredText uitzenden, dus een snapshot van een geïmporteerde grafiek draagt de labeltekst die Excel zou tonen, naast de rest van de bewaarde ChartML voor geïmporteerde Excel-grafieken
Wanneer geeft XLSTrendlineEquationLabel False terug?
XLSTrendlineEquationLabel geeft False terug en laat beide strings leeg wanneer de fit ongedefinieerd is, in plaats van een gedeeltelijk of gegokt label te publiceren. De functie zendt nooit de helft van een vergelijking uit, dus een True-resultaat betekent altijd dat beide gevraagde strings compleet zijn
- Minder dan twee punten, een trendsoort buiten 0..5, of een polynomiale orde buiten 2..6
- Een niet-positieve X voor logaritmische of power-fits, of een niet-positieve Y voor exponentiële of power-fits, want beide hebben een logaritme nodig
- NaN of oneindige invoer, of enige X, Y of intercept met een orde van grootte boven 1E50
- Te weinig punten voor de polynomiale orde, alle X-waarden gelijk voor een niet-polynomiale fit zonder vaste intercept, of een singulier polynoomstelsel
- Gefitte waarden die het eindige bereik verlaten (boven 1E100) of exponenten die zouden overlopen
Moving average is de bewuste uitzondering. Excel stelt geen vergelijkings- of R-squared-tekst bloot voor een moving average-trendline, ook niet wanneer de opgeslagen schakelaars dispEq en dispRSqr aan staan, dus de functie geeft True terug met beide strings leeg, wat de aanroeper correct vertelt dat er niets te tekenen valt
Numerieke stabiliteit en huidige grenzen
Polynomiale trendlines zijn waar naïeve code cijfers verliest. Rauwe normaallijkvergelijkingen voor een fit van zesde orde over X-waarden in de duizenden zijn slecht geconditioneerd, dus HotXLS centreert en schaalt X voordat hij het stelsel opbouwt, lost het op met Gauss-Jordan-eliminatie en partiële pivotering, en pas daarna ontvouwt hij de coëfficiënten terug naar de originele variabele. Lineaire fits en de R-squared-correlatie gebruiken incrementeel gemiddelde- en variantieoptelling om dezelfde reden, en een intercept die slechts floating-point-ruis is ten opzichte van de data wordt op nul gesnapt zodat het label niet eindigt op + 4E-17
De eerlijke grenzen zitten in de formattering. De functie levert de default labelgetallen van Excel; een custom LabelNumberFormat op het trendline-label wordt door TXLSXChartTrendline vastgehouden maar niet toegepast op de berekende tekst. Superscript-stijling van exponenten in gerenderde output en automatische labelplaatsing zijn apart werk, en fits van zeer hoge graad over data met grote offsets of bijna-collineariteit kunnen nog steeds als singulier worden geweigerd in plaats van opgelost. Voor een library die met Excel moet meegaan, is weigeren de veiligere misser
FAQ
Bewaart het XLSX-bestand de trendline-vergelijkingstekst
Nee. Het c:trendline-element bewaart de fitsoort, orde of periode, de optionele intercept, forecasts en de schakelaars c:dispEq en c:dispRSqr, en c:trendlineLbl bewaart labellay-out en -opmaak. Excel berekent de vergelijkings- en R-squared-tekst op rendertijd, en daarom berekent HotXLS hem met XLSTrendlineEquationLabel
Waarom toont het polynomiale label x2 in plaats van superscript
Omdat dat is wat de DataLabel.Text van Excel bevat. De exponent is een kale cijfer in de string en Excel past de verhoogde opmaak toe wanneer hij de grafiek tekent. Het teken U+00B2 verschijnt alleen in het prefix R² = van de R-squared-regel
Kan ik labels berekenen voor grafieken gebouwd met de klassieke XLS-engine
XLSTrendlineEquationLabel woont in lxStandard en wordt door beide HotXLS-engines gedeeld, dus hij werkt met elke puntenset die u kunt extraheren. Automatische projectie van de labeltekst in semantische snapshots dekt momenteel OOXML-grafieken; voor andere bronnen bouwt u de array TXLSTrendlineLabelPoint zelf en volgt u de categoriepositieregel voor Line charts
Trendline-labelberekening, grafiekauthoring en de rest van het Excel-objectmodel worden geleverd in HotXLS, de native Delphi-spreadsheetcomponent voor XLS en XLSX, zonder dat er tijdens run time een Excel-installatie nodig is