Een Reed-Solomon-encoder die zijn generatorpolynoom eerst de constante term opslaat en daarna deelt met de leidende term eerst, berekent helemaal geen error correction. HotPDF shipped precies dat in vier 2D-barcode-encoders, QR, Data Matrix, PDF417 en Aztec, en elk symbool dat ze produceerden droeg een checkblok dat geen enkele conforme scanner kon gebruiken
Het interessante deel is niet de rekenkundige uitglijder. Het is de voortplanting. Eén encoder werd eerst geschreven, zijn delingslus werd in de volgende drie gekopieerd, en elk nieuw formaat erfde een defect dat nooit tegen één gepubliceerd testvector was gevalideerd. Symbolen rendereerden nog, finder-patronen stonden op de juiste plek, afmetingen klopten. Alleen de bytes die een 2D-barcode een smeerplek laten overleven waren garbage
Eén omgekeerd polynoom, in vier encoders gekopieerd
De grondoorzaak is een opslagvolgorde-mismatch binnen de synthetische delingslus. Alle vier de HotPDF-encoders bouwen het generatorpolynoom met coëfficiënten van laag naar hoog, dus Gen[0] houdt de constante term en Gen[High(Gen)] houdt de monische leidende coëfficiënt. De delingslus indexeerde Gen[J] voorwaarts terwijl hij de boodschap doorliep, wat rekenkundig identiek is aan delen door het omgekeerde polynoom. Er was een tweede consequentie die de eerste verborg: omdat de leidende coëfficiënt nooit op positie I landde, werd Work[I] nooit gewist, dus de deling reduceerde in feite niets. De lus termineerde nog steeds en vulde de staart nog steeds met een array van exact de juiste lengte
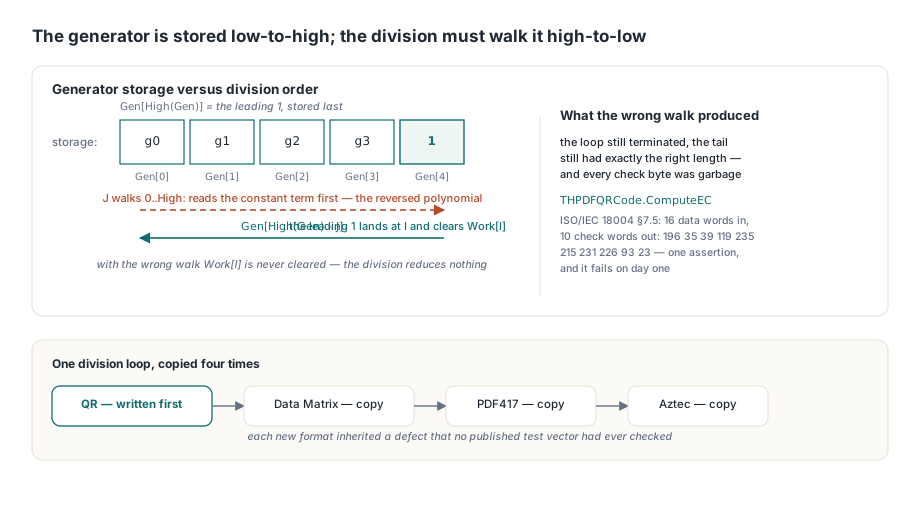
// THPDFQRCode.ComputeEC in de unit HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] is de constante term
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] is de leidende 1 die Work[I] wist; Gen voorwaarts
  // doorlopen deelt in plaats daarvan door het omgekeerde polynoom
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
De fix is de enkele indexexpressie Gen[High(Gen) - J]. Daarna reproduceert THPDFQRCode.ComputeEC het uitgewerkte voorbeeld van ISO/IEC 18004 §7.5: het version 1-M byte-mode blok 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 levert de tien checkwoorden 196 35 39 119 235 215 231 226 93 23 op. Dat is één assertie, en hij zou op dag één gefaald hebben
Waarom verloor het Aztec-symbool ook zijn payload?
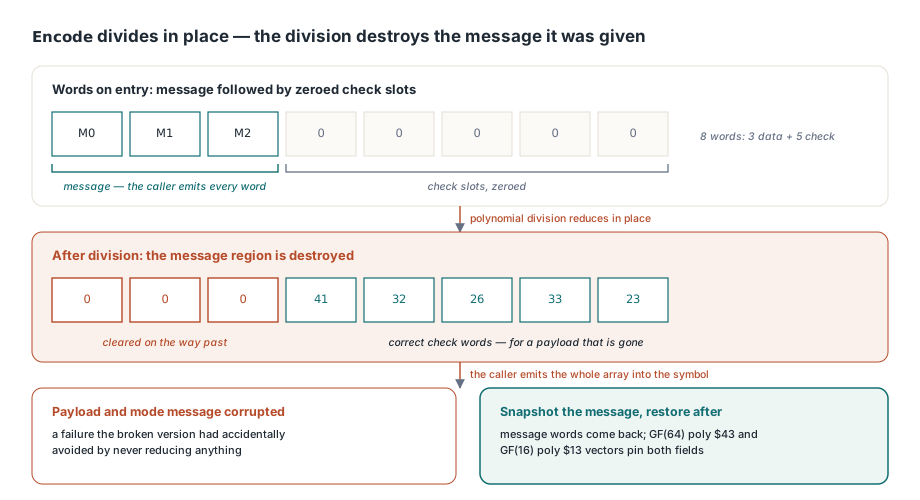
Aztec droeg een zwaardere versie van dezelfde bug omdat TAztecGF.Encode in-place deelt. De routine ontvangt Words met daarin de boodschap gevolgd door op nul gezette checkwoord-sleuven, en de caller emitteert die hele array in het symbool. Polynoomdeling vernietigt het deeltal terwijl het reduceert, dus zodra de lus was gefixt om werkelijk te reduceren, werden de boodschapwoorden onderweg overschreven. Payload en mode-message kwamen allebei beschadigd uit, een falen dat de gebroken versie toevallig had vermeden door nooit iets te reduceren
// TAztecGF.Encode in de unit HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// De deling wist het boodschapgebied, maar de caller emitteert de hele
// array in het symbool, dus de datawoorden moeten terugkomen
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec gebruikt twee verschillende velden, en de regressie-fixture oefent beide. In GF(64), het veld van een zes-bits symbool dat uit primitief polynoom $43 is gebouwd, produceren de woorden 12 45 3 met vijf checkwoorden 41 32 26 33 23 terwijl de leidende drie onaangeroerd blijven. In GF(16), het veld van de mode-message met primitief polynoom $13, produceren de woorden 5 9 de woorden 11 15 6 8. Beide draaien via de HPDFAztecTestEncode-hook tegen ISO/IEC 24778
Waarom heeft Data Matrix twee fixes nodig in plaats van één?
THPDFDataMatrix.ComputeEC stapelde een tweede, onafhankelijke fout bovenop de gedeelde: hij bouwde het generatorpolynoom met wortels die bij α^0 beginnen, terwijl ISO/IEC 16022 Annex E wortels vanaf α^1 specificeert. Alleen de delingsindex fixen geeft de checkwoorden 146 107 90 179 128 voor het standaardvoorbeeld, die er elk bit even plausibel uitzien als de correcte en nog steeds onleesbaar zijn. Beide defecten moesten weg voordat de getallen klopten
// THPDFDataMatrix.ComputeEC in de unit HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]: de wortels lopen alpha^1..alpha^ECCount, niet vanaf alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
Het referentiepunt is klein genoeg om in een comment te houden. De string '123456' encodeert naar de ASCII-codewoorden 142 164 186, een 10x10-symbool draagt vijf checkwoorden, en het correcte blok is 114 25 5 88 102. HPDFDataMatrixTestComputeEC stelt de klassemethode achter de {$IFDEF HPDF_TESTING}-gate beschikbaar, dus de fixture assert die vijf waarden zonder een encoder te instantiëren of een pagina te renderen. Het Galois-veld zelf, door InitDMTables over primitief polynoom $12D in de DMExp- en DMLog-tabellen gebouwd, was de hele tijd correct, en dat is precies waarom de bug zich zo goed verborg
PDF417 deelt over een priemveld, waar tekens er toe doen
PDF417 had vier wijzigingen nodig in plaats van één, want GF(929) is een priemveld en geen binaire extensieveld: optellen is geen xor, aftrekken is geen optellen, en het teken van elke generatorfactor is echte rekenkunde in plaats van notatie. Elke factor moet (x - 3^i) zijn, wat in code vermenigvuldigen met 929 - GF929Pow(3, I) betekent; de reductiestap moet aftrekken; de wortels lopen vanaf 3^1 volgens ISO/IEC 15438 §5.5; en Factor moet vóór de binnenste lus in een lokale worden vastgezet, want de J = 0-pass schrijft Work[I] en zou anders de vermenigvuldiger onder zichzelf vandaan veranderen. HPDFPDF417TestComputeEC pind het gecorrigeerde resultaat vast: de codewoorden 5 453 178 121 239 met vier error-correction-woorden geven 452 327 657 619
// THPDFPDF417.ComputeEC in de unit HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // de factor is (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // vastzetten: J = 0 herschrijft Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
De Data Matrix-finder was binnenstebuiten geïnstalleerd
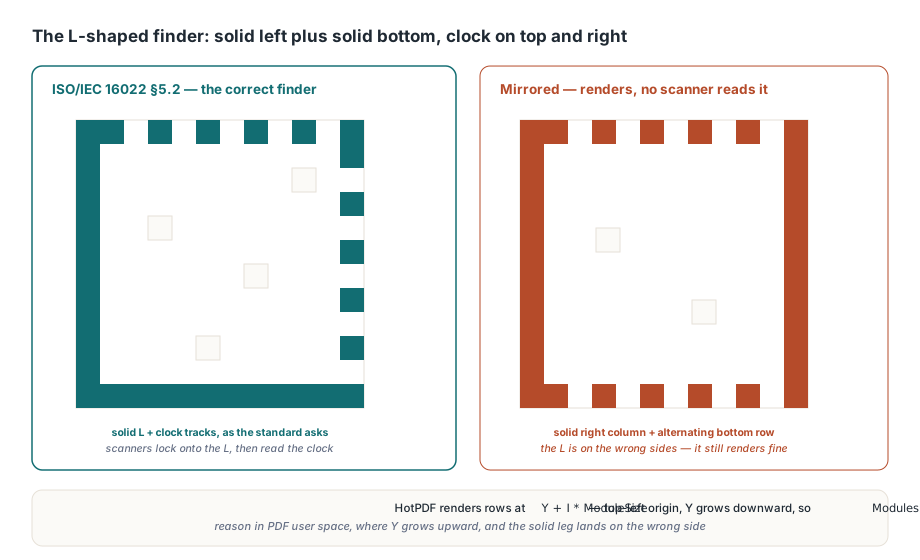
Correcte checkwoorden redden geen symbool waarvan het finder-patroon is gespiegeld, en dezelfde release moest ook dat fixen. De plaatsingscode tekende een volle linkerkolom, een volle rechterkolom en afwisselende modules langs de boven- en onderrij, terwijl ISO/IEC 16022 §5.2 om een volle linkerkolom plus een volle onderste rij vraagt, de L-vormige finder, met de afwisselende kloktrack langs de bovenste rij en de rechterkolom. Wat dit makkelijk achterstevoren laat krijgen is de coördinatenconventie: HotPDF rendert module-rijen op Y + I * ModuleSize, wat top-left-oorsprong-semantiek is, dus Modules[Size - 1, *] is de onderste rij van het geprinte symbool. Iedereen die in PDF user space redeneert, waar Y omhoog groeit, zet de volle poot aan de verkeerde kant en ziet op het scherm niets verdachts
Waarom slaagden vier gebroken encoders jarenlang de tests?
Omdat de tests structuur asserten en de defecten in de rekenkunde zaten. De bestaande QR-, Data Matrix- en Aztec-gevallen checkten finder-modules, timing-patronen en symboolafmetingen, die allemaal werkelijk correct waren; geen enkele test had ooit een checkwoord tegen een gepubliceerd vector vergeleken. De tweede reden generaliseert verder. HotPDF levert een ingebouwde QR-decoder mee, en hem gebruiken om de encoder te valideren voelt als een voor de hand liggende round trip, behalve dat deze decoder data-codewoorden leest en geen Reed-Solomon-correctie uitvoert, dus hij las exact terug wat de encoder schreef en meldde succes. Wanneer een encoder en een decoder een aanname delen, bewijst een round-trip-test dat ze het eens zijn, niet dat een van beide gelijk heeft. Een error-correcting code moet worden gevalideerd tegen vectoren die in de standaard zijn gedrukt, nooit tegen je eigen decoder. De fixture THPDFBarcodeECCTests houdt nu één test per formaat, elk genoemd naar wat hij vastpindt, en elk bereikt de rekenkunde via een hook die alleen onder {$IFDEF HPDF_TESTING} compileert:
QRCheckWordsMatchISO18004Exampleassert de tien checkwoorden van het version 1-M byte-mode voorbeeldDataMatrixCheckWordsMatchISO16022Exampleassert 114 25 5 88 102 voor de codewoorden 142 164 186PDF417CheckWordsMatchGF929Referenceassert 452 327 657 619 over GF(929) met wortels 3^1 tot en met 3^4AztecCheckWordsKeepMessageAndMatchReferenceassert de checkwoorden en dat de boodschapwoorden de in-place deling overleven
Vier vragen vangen het meeste van deze familie in elke encoder die je onderhoudt. Stemt je generator-opslagvolgorde overeen met je delingsindex-volgorde, en kun je de regel aanwijzen die het bewijst? Beginnen de wortels waar de standaard zegt, α^1 voor Data Matrix en 3^1 voor PDF417? Herstelt een in-place deling daarna het boodschapgebied? Vergelijkt minstens één test checkwoorden, in plaats van module-aantallen, tegen een getal dat in een specificatie is gedrukt? Scope doet er ook toe wanneer je beslist wat je met bestaande artefacten doet. Symbolen die vóór v2.748.0 zijn gegenereerd renderen en scannen vaak onder ideale omstandigheden, want een schoon beeld heeft geen correctie nodig om gelezen te worden; wat ze verloren is de schadetolerantie die de hele reden is om deze formaten te kiezen. Langlevende labels en gearchiveerde documenten die getroffen symbolen dragen zijn het hergenereren waard in plaats van het spot-checken met een telefooncamera. De encoders zitten in de barcode-ondersteuning in HotPDF, naast het QR-decodepad en de oriëntatie-afhandeling ervan en de rapport-output-laag die symbolen op een pagina plaatst; de volledige barcode-API-referentie wordt meegeleverd met de HotPDF Delphi Component voor Delphi en C++Builder