HotPDF converteert HTML naar PDF-pagina's via THPDFHTMLImporter.RenderHTML5, een geversioneerd paged-media-profiel met een echte DOM, een echte CSS-cascade, tabellen, pagina-einden en optionele AcroForm-generatie op basis van HTML-formulierelementen. Het draait volledig in-process: geen browser-engine, geen Chromium, geen externe converter, en standaard helemaal geen bestands- of netwerktoegang
De reden dat er een apart toegangspunt bestaat in plaats van een verbeterde RenderHTML is compatibiliteit. De oudere methode rendert al jaren facturen en brieven in productieomgevingen, en een soepelere DOM met een volledige cascade verandert de output van documenten die op het oude gedrag zijn afgestemd. Dus behoudt de oude methode zijn exacte semantiek en leeft al het nieuwe achter RenderHTML5, waarvan de profielversie wordt gerapporteerd door HTML5ProfileVersion en waarvan de ondersteunde mijlpalen worden vermeld door HTML5ProfileMilestones
Wat voegt het HTML5-profiel eigenlijk toe?
Vier mogelijkheden zijn in de praktijk belangrijk. Een structurele DOM waarin html en body containers zijn in plaats van tekstnodes. Een CSS-cascade met correcte precedentie. Tabellay-out. En expliciete controle over pagina-einden, wat "paged media" betekent: HTML is ontworpen voor een scrollend viewport, en het omzetten ervan in pagina's vereist beslissen waar inhoud mag afbreken
Het punt over containers klinkt als een implementatiedetail en is in werkelijkheid het verschil tussen werken en niet werken. Als de rootelementen als tekstcontainers worden behandeld, valt de hele DOM tijdens het parsen samen tot één tekstblok, en wordt elke stylesheetregel, pagina-einde, tabel en formuliersubboom daarna op niets toegepast. Elke HTML-renderer die van een gestructureerd document één ongedifferentieerde muur van tekst maakt, heeft precies deze fout gemaakt
Cascadevolgorde, uitgeschreven
CSS-precedentie is geen enkele sortering. HotPDF past normale declaraties uit overeenkomende regels toe op volgorde van specificiteit en vervolgens brondsvolgorde, past daarbovenop inline normale declaraties toe, dan de !important-declaraties uit overeenkomende regels, en tot slot inline !important. Vier passes, in die volgorde
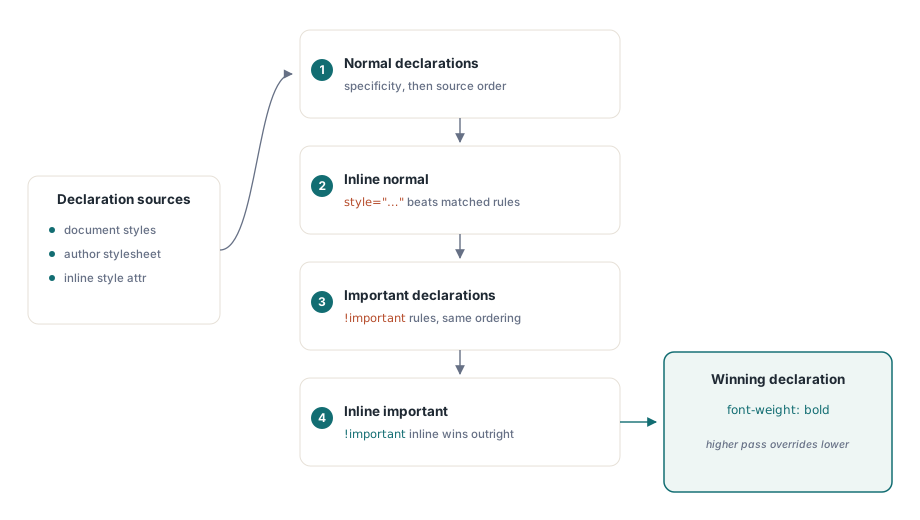
Implementaties die dit versimpelen tot "laatste wint" krijgen de gewone gevallen goed en de interessante gevallen verkeerd, wat erger is dan ze uniform verkeerd doen, omdat de fout alleen optreedt in templates die !important gebruiken om een basisstylesheet te overschrijven — precies de templates geschreven door mensen die verwachten dat de cascade werkt:
uses
  HPDFDoc, HPDFHTMLImport;

var
  Pdf: THotPDF;
  Importer: THPDFHTMLImporter;
  Html, Css: WideString;
begin
  Pdf := THotPDF.Create(nil);
  Importer := THPDFHTMLImporter.Create(Pdf);
  try
    Pdf.FileName := 'statement.pdf';
    Pdf.BeginDoc;

    Importer.Margin := 56;              // punten
    Importer.BaseFontName := 'Arial';
    Importer.BaseFontSize := 10;
    Importer.CreateAcroForms := False;  // besturingselementen renderen, geen velden aanmaken

    Css := '@page { margin: 56pt } ' +
           'table { border-collapse: collapse } ' +
           'tr.total { page-break-inside: avoid; font-weight: bold }';
    Html := LoadTemplate('statement.html');

    if not Importer.RenderHTML5(Html, Css) then
      raise Exception.Create('nothing was emitted - check the markup');

    Pdf.EndDoc;

    Writeln(Format('profile=%d nodes=%d rules=%d layout ops=%d',
      [Importer.Statistics.ProfileVersion,
       Importer.Statistics.ParsedNodeCount,
       Importer.Statistics.CSSRuleCount,
       Importer.Statistics.LayoutOperationCount]));
  finally
    Importer.Free;
    Pdf.Free;
  end;
end;
Het tweede argument is een auteursstylesheet die wordt toegepast naast wat het document zelf meedraagt, wat de nette manier is om huisregels zoals paginamarges en widow-controle af te dwingen zonder elk template te bewerken
Waarom haalt de importeerder nooit iets op?
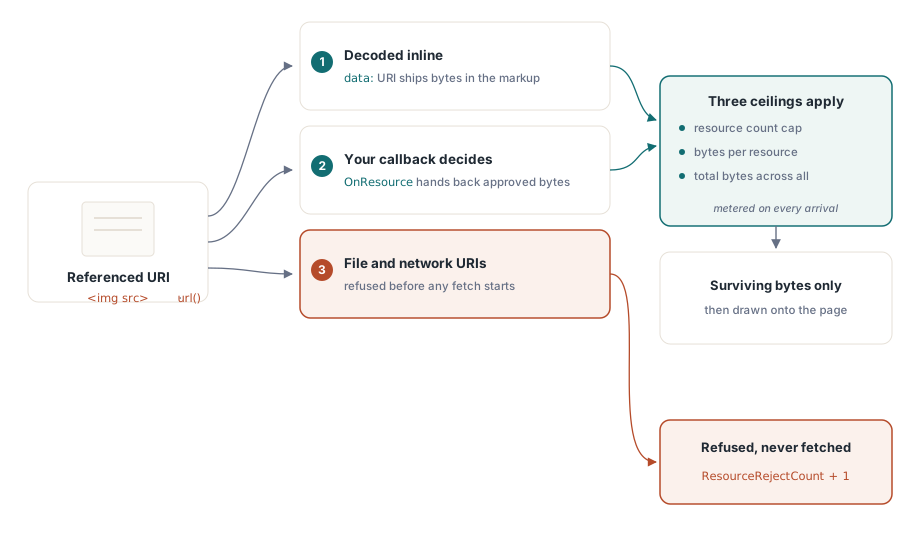
Een HTML-naar-PDF-converter die externe verwijzingen oplost is een server-side request forgery-engine in het kostuum van een documentgenerator. Richt hem op door de gebruiker aangeleverde markup en hij zal gretig http://169.254.169.254/ of een file-URL van uw applicatieserver ophalen en het resultaat inbedden in een PDF die iemand downloadt
HotPDF leest daarom standaard noch bestanden noch het netwerk. Afbeeldingen en andere resources komen op precies twee manieren binnen: als data:-URI's binnen de markup, of via de OnResource-callback, waar uw code beslist wat een URI betekent en de bytes aanlevert:
procedure TReportForm.SupplyResource(Sender: TObject;
  const URI: WideString; ResourceKind: THPDFHTMLResourceKind;
  var Data: TBytes; var ContentType: string; var Handled: boolean);
begin
  Handled := False;
  // Alleen leveren vanuit een goedgekeurde lokale asset-directory. Geef de URI
  // nooit door aan een HTTP-client, en voeg hem nooit samen met een pad
  // zonder eerst te valideren
  if StartsText('asset:', URI) then
  begin
    Data := LoadAssetBytes(Copy(URI, 7, MaxInt));
    ContentType := 'image/png';
    Handled := Length(Data) > 0;
  end;
end;
Elke resource die wel binnenkomt, wordt nog steeds afgezet tegen drie afzonderlijke plafonds: hoeveel resources, hoeveel bytes elk, en hoeveel bytes in totaal. Een callback die trouw teruggeeft wat er ook gevraagd wordt, kan niet worden overgehaald om geheugen uit te putten door een document dat dezelfde afbeelding van 50 MB tweehonderd keer aanroept
Vier budgetten, één faalmodus
Parsernodes, CSS-regels, lay-outbewerkingen en resources worden onafhankelijk gemeten, omdat ze onafhankelijk falen. Een document kan klein zijn en pathologisch duur om op te maken; een ander kan ondiep zijn met een stylesheet ontworpen om selectormatching te laten ontploffen. Het uitputten van één ervan werpt EHPDFHTMLImportBudget op, een eigen exceptieklasse zodat budgetuitputting apart kan worden opgevangen van misvormde input
Statistieken worden gereset bij het begin van elke RenderHTML5-aanroep, dus de cijfers beschrijven één import in plaats van de levensduur van het importer-object. In een dienst die niet-vertrouwde templates rendert, logt u ParsedNodeCount, LayoutOperationCount en ResourceRejectCount per document: een stijgend afwijzingsaantal betekent meestal dat een templateauteur assets aanroept die uw callback niet herkent, en een aantal lay-outbewerkingen dicht bij het plafond betekent dat het volgende, iets grotere document zal mislukken
Kiezen tussen HTML-import en de lay-out-API
HTML-import wint wanneer de inhoud als HTML wordt opgesteld door mensen die geen Delphi-ontwikkelaars zijn, wanneer templates vaker veranderen dan code, of wanneer dezelfde inhoud ook per e-mail moet worden verstuurd. De declaratieve lay-outboom beschreven in declaratieve PDF-lay-out met tagged output wint wanneer het document door uw eigen code op basis van data wordt gegenereerd, wanneer u automatisch PDF/UA-structuur moet uitvoeren, of wanneer nauwkeurige controle over paginering belangrijker is dan gebruiksgemak bij het opstellen
Ze sluiten elkaar niet uit. Een veelvoorkomende vorm is HTML-import voor de body van een rapport, waarbij kop, voettekst en handtekeningblokken direct worden getekend, omdat dat vaste geometrie is die geen template zou moeten bezitten. Tabellen zijn het enige gebied waar het de moeite waard is beide te meten: complexe financiële tabellen pagineren soms beter via het speciale tabeltraject beschreven in het genereren van tabellen in PDF
Stel CreateAcroForms bewust in. Uit, renderen HTML-formulierelementen als statische afbeeldingen, wat een afgedrukte verklaring wil. Aan, worden ze echte interactieve AcroForm-velden, wat een invulbaar formulier wil, en het veldgedrag dat daarop volgt wordt behandeld in het toevoegen van formuliervelden aan een geladen PDF
HTML-import, declaratieve lay-out en de directe teken-API richten zich allemaal op hetzelfde documentobject in Delphi en C++Builder; de volledige functielijst staat op de HotPDF Delphi PDF component-pagina