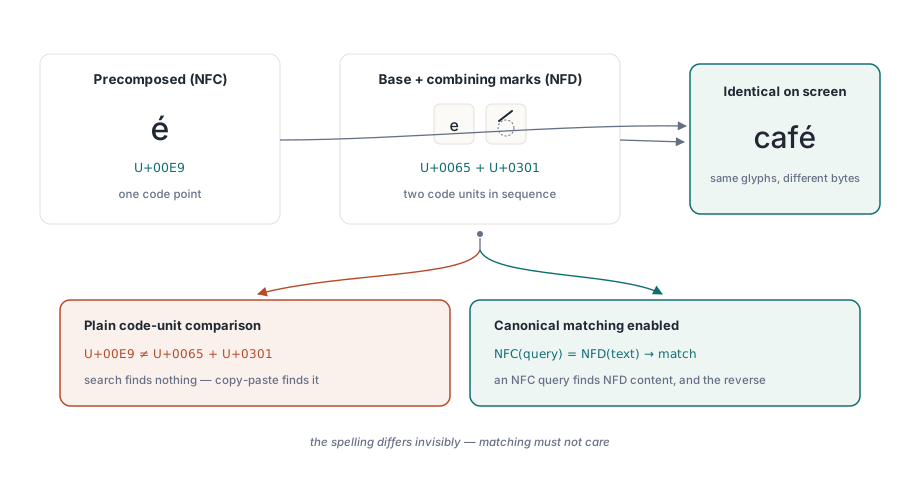
Een gebruiker typt Müller in een zoekveld, krijgt niets, kopieert dezelfde naam uit de PDF, plakt haar terug in het veld en krijgt plotseling treffers. Bekijk beide strings in de debugger en Length geeft 6 voor de getypte en 7 voor de geplakte. Het getypte woord draagt U+00FC, één voorgecomponeerde ü; het document bewaart een kale u gevolgd door U+0308 COMBINING DIAERESIS. Beide renderen als dezelfde glyphs, en een vergelijking op code-eenheden zal ze nooit gelijk achten
Waarom vergelijken er identiek uitziende strings ongelijk?
Unicode staat opzettelijk meer dan één codering toe voor hetzelfde abstracte teken, en noemt die coderingen canoniek equivalent. Unicode Standard Annex #15 definieert twee normalisatievormen die voor zoeken van belang zijn: NFC, die voorgecomponeerde codepoints verkiest, en NFD, die elk voorgecomponeerd teken splitst in een basisletter plus haar combinerende tekens in een vaste volgorde. Latijnse letters met diakritische tekens bestaan in beide vormen. Dat geldt ook voor Hangul-lettergrepen, die kunnen verschijnen als één voorgecomponeerde lettergreep of als een reeks van twee of drie aaneenschakelende jamo
Welke vorm in een PDF belandt, hangt af van de software die haar produceerde, het platform waarop die draaide, en soms van hoe de ToUnicode-map van een font is gebouwd. Een document dat op de ene machine is getypt en op de andere is bewerkt, kan beide vormen op dezelfde pagina mengen. Geen ervan is zichtbaar voor de zoekende persoon. Diens toetsenbord en invoermethode produceren meestal NFC, dus alle gedecomponeerde content in het bestand wordt van diens kant onvindbaar
De voor de hand liggende work-around is het probleem in dezelfde emmer te gooien als case folding: beide kanten kleine letters, accenten strippen, vergelijken. Dat breekt om een structurele reden. Case folding en accentstripping zijn een-op-een op het niveau van code-eenheden, dus de gefolde tekst heeft exact dezelfde lengte als het origineel en een treffer op positie 17 in de gefolde kopie is een treffer op positie 17 in de geëxtraheerde tekst. Normalisatie verandert lengtes. Eén voorgecomponeerde letter wordt twee of drie code-eenheden, een gedecomponeerde reeks klapt terug naar één, Hangul-lettergrepen zetten uit naar jamo, en na die transformatie wijzen de posities die u terugkrijgt niet meer naar de tekst die u had geëxtraheerd
Zoeken met soCanonicalEquivalent in PDF Library for Delphi
In PDF Library for Delphi laat het lid soCanonicalEquivalent van TPDFlibSearchOptions SearchText de canonieke decomposities van de zoekopdracht en de paginattekst vergelijken, dus een NFC-zoekopdracht vindt NFD-content en een NFD-zoekopdracht vindt NFC-content. De optie maakt deel uit van een set, wat betekent dat ze combineert met soWholeWord, soCaseSensitive, soWildcards en soDiacriticInsensitive zonder aparte API:
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // vult ContextBefore / ContextAfter
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // leeg paginabereik = elke pagina

    // Found telt elke treffer; alleen de eerste Length(Hits) zijn gekopieerd
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
Twee details in die lus laten mensen struikelen. SearchText geeft het totale aantal treffers terug ook wanneer de buffer kleiner is, dus tot Found - 1 itereren op een groot document loopt voorbij het einde van een array van 500 elementen; klem af met Min of schakel over op SearchTextEach, die elke treffer aan een callback geeft en helemaal geen buffer nodig heeft. En MatchText is het hele tekstblok dat de treffer bevatte, met MatchStart als 1-based index daarin, dus het gevonden woord zelf is de Copy die hierboven staat
Draai dat tegen een bestand dat Bäcker gedecomponeerd bewaart en de geprinte lengte is 7, tegen een NFC-bestand is ze 6. Dezelfde zoekopdracht, dezelfde optieset. De slice is altijd de tekst zoals ze in het document zit
Waar de treffer in de originele tekst landt
Die laatste eigenschap maakt genormaliseerd zoeken bruikbaar voor alles wat verder gaat dan een ja/nee-antwoord. PDF Library for Delphi legt, voor elke code-eenheid die de normalisator produceert, het begin en het einde vast van de originele UTF-16-range waaruit ze kwam. Een recursieve decompositie erft de range van haar ouder, een compositie voegt de ranges van haar invoeren samen, en zodra een treffer wordt gevonden scant de zoekopdracht het gemapte interval naar de kleinste start en het grootste einde
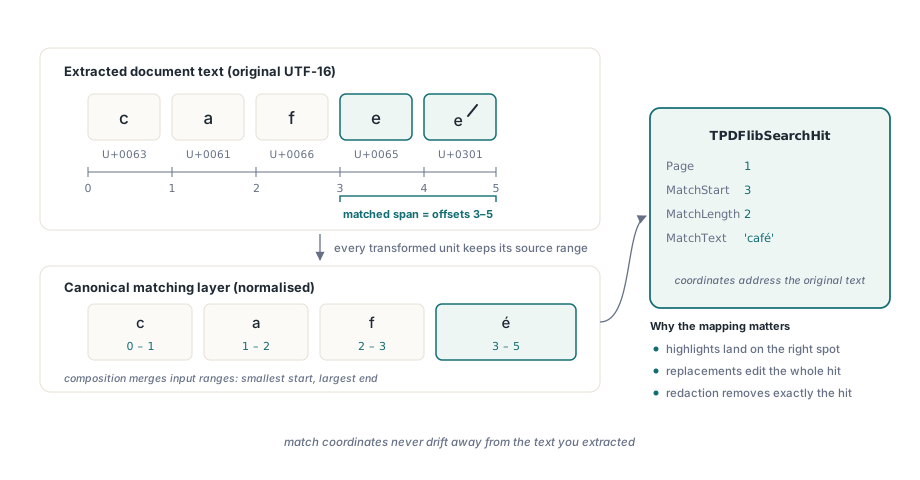
Daardoor adresseren MatchStart, MatchLength, ContextBefore, ContextAfter en beide vervangingsingangspunten de geëxtraheerde tekst die de aanroeper al heeft. Een zoekopdracht die kon zeggen "in dit blok zit een treffer" maar niet precies waar, zou voor een teller prima zijn en voor al het andere verkeerd: highlights zouden per geaccentueerde letter een teken of twee afdrijven, en een vervanging zou de verkeerde tekstreeks herschrijven
De normalisator zit in de bibliotheek. Ze draagt compacte tabellen mee voor canonieke decompositie, compositie en canonieke combining class uit Unicode 15.1, past de algoritmische regels voor Hangul toe in plaats van tabelentries, en herschikt combinerende tekens tijdens NFD op stabiele wijze. Er wordt geen extern databestand geladen en geen normalisatieaanroep van het besturingssysteem gedaan, dus een Windows-service, een Linux-daemon en een Free Pascal-build geven voor hetzelfde bestand identieke treffers terug. Dat vinden wij beter, ook al zou het besturingssysteem het werk op Windows kunnen doen: een zoekindex gebouwd op de ene server en bevraagd op de andere mag nooit van mening verschillen omdat de twee machines verschillende Unicode-versies draaiden
De optie staat standaard uit, en dat is een redelijke standaard. De NFD-tekst en haar positiekaart bouwen kost tijd, en een zoekopdracht over uitsluitend ASCII-facturen heeft haar nooit nodig. Zodra soCanonicalEquivalent is gezet, houdt elk tekstblok twee getransformeerde kopieën bij, één met combinerende tekens en één zonder, dus een batch zoekopdrachten over hetzelfde blok normaliseert haar één keer. Gewone case folding blijft op het goedkopere een-op-een-pad
Wat gaat er mis wanneer een treffer middenin een teken eindigt?
Canonieke equivalentie antwoordt op "is dit dezelfde tekst", maar zegt niets over waar een treffer mag stoppen. Zoek in een gedecomponeerde café naar cafe met alleen soCanonicalEquivalent en de eerste vier code-eenheden matchen; de combinerende acute die volgt blijft buiten de treffer. soWholeWord vangt dat niet, want diens woordtekens volgen identificatorregels (ASCII-letters, cijfers en onderstrepingsteken) en een combinerend teken telt als grens. De highlight dekt cafe, en een vervanging laat een verdwaald accent zweven boven wat er hierna komt
Hetzelfde gebeurt ruim buiten de Latijnse accenten. Een vlag-emoji is twee regional indicator-codepoints. Een familie-emoji is meerdere personen verbonden door zero-width joiners. Een Devanagari-conjunct is een medeklinker, een virama en nog een medeklinker, en een Vietnamese klinker kan twee gestapelde tekens dragen. Alles buiten het Basic Multilingual Plane is in UTF-16 een surrogatepaar, en een helft eraf snijden levert een ongepaarde surrogate op die veel tekstpijplijnen vervangen door U+FFFD
soGraphemeClusters eist dat beide einden van elke treffer, letterlijk of joker, vallen op de grenzen van uitgebreide grafeemclusters zoals gedefinieerd in Unicode Standard Annex #29. De segmentering dekt CR/LF-paren, besturingstekens, Hangul-lettergreepsoorten, Extend en SpacingMark, Prepend, emoji-ZWJ-reeksen, regional-indicator-paren en Indische conjunct-breuken, en hij legt nooit een grens binnen een surrogatepaar. Met de vlag aan matcht cafe een gedecomponeerde café helemaal niet meer; voeg soDiacriticInsensitive toe als accentblind matchen is wat u eigenlijk wilt
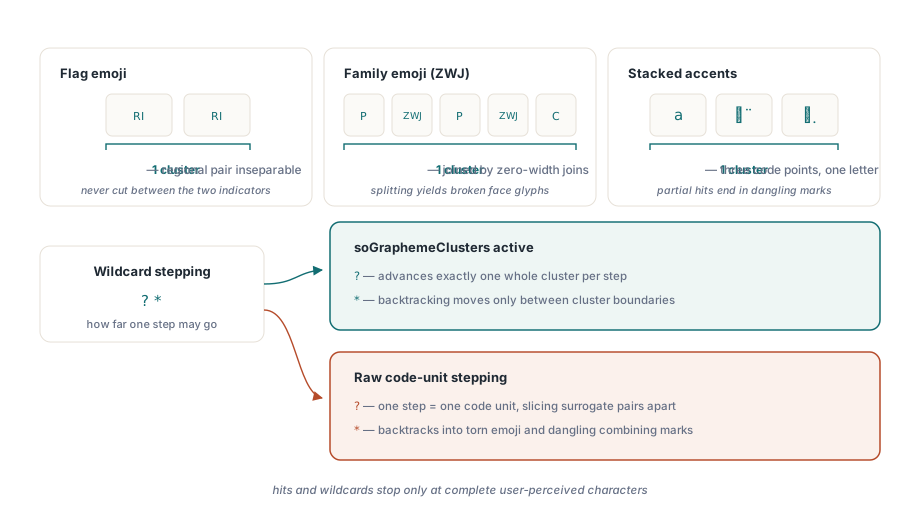
Wildcards zijn waar de vlag resultaten het zichtbaarst verandert. Onder soCanonicalEquivalent wordt de paginattekst in NFD vergeleken, dus côté wordt c o U+0302 t e U+0301, ongeacht hoe het bestand haar bewaarde. Zonder soGraphemeClusters verbruikt de ? in c?té exact één code-eenheid, de o, verwacht daarna een t en vindt U+0302. Geen treffer. Met de vlag schuift ? één heel cluster op en beweegt ook de backtracking voor * alleen tussen clustergrenzen:
// "?" stapt één door de gebruiker waargenomen teken, dus dit matcht côté
// of de PDF haar nu voorgecomponeerd of gedecomponeerd bewaarde
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// De vervanging gebruikt dezelfde clusterveilige ranges, dus zij
// splitst nooit een emoji en laat geen verdwaald accent achter
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent herschrijft de tekst binnen de paginacontent en geeft het aantal treffers terug dat ze verving. Geeft ze nul terug, dan zegt GetLastUnicodeReplacementDiagnostics waarom, bijvoorbeeld dat een treffer niet kon worden terug gemapd naar de content die haar tekende. Het andere ingangspunt, SearchAndReplaceText, accepteert dezelfde optieset en tekent de vervanging in plaats daarvan over het gevonden blok
Per werkbelasting een optieset kiezen
Drie combinaties dekken de meeste toepassingen. Voor een zoekveld voor eindgebruikers in een documentviewer, gebruik soCanonicalEquivalent plus soDiacriticInsensitive: beide coderingsvormen matchen, en ook geaccentueerde en ongeaccentueerde spellingen, wat mensen na jaren webzoeken verwachten. Voor juridische of compliance-review, waar een vals positief iemand een middag kost, gebruik soCanonicalEquivalent met soCaseSensitive en soWholeWord en laat accentvouw uit, zodat equivalentie exact blijft terwijl ze negeert hoe het bestand haar toevallig codeerde
Voor alles dat het document verandert, voeg elke keer soGraphemeClusters toe. Dit is de ene plek die we niet aan smaak zouden overlaten. Een zoekopdracht die een range één code-eenheid te kort teruggeeft, misleidt alleen de lezer van de resultaten; een vervanging of verwijdering die dezelfde range gebruikt schrijft de fout in het bestand, en niemand merkt het tot de pagina opnieuw wordt geprint of geëxtraheerd. Verwijdering die content moet vernietigen in plaats van bedekken is een eigen onderwerp, behandeld in echte redactie en contentverwijdering
Lopen meerdere termen tegen hetzelfde document, geef dan de voorkeur aan SearchTextBatch. Hij evalueert elke niet-lege zoekopdracht terwijl de tekstblokken van een pagina in het geheugen staan, dus elke pagina wordt één keer geëxtraheerd en elk blok één keer genormaliseerd, en elke zoekopdracht draagt haar eigen optieset:
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // Hangul: NFC of jamo in het bestand
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
Treffers komen terug geordend op pagina, dan blok, dan zoekopdracht, en QueryIndex is de zero-based positie in de array die u doorgaf. SearchTextBatchEach is de callbackvorm voor resultatensets die u vooraf niet van grootte kunt voorzien. Hoe tekstblokken in de eerste plaats worden geëxtraheerd, staat beschreven in tekstzoeken en pagina-elementen enumeratie
Scripts waar canonieke equivalentie niet optioneel is
Voor Koreaans beslist canonieke equivalentie of een naam überhaupt wordt gevonden, want voorgecomponeerde lettergrepen en gedecomponeerde jamo komen beide voor in echte documenten. Vietnamees stapelt een toonteken bovenop een klinker die al een breve of circumflex kan dragen, dus de compositievorm hangt volledig van de producent af. Voor Devanagari, Bengaals en de andere Indische scripts beslissen de conjunctregels of een treffergrens landt op een plek die een lezer kan herkennen. Japans en Chinees zijn aan de zoekkant betrekkelijk makkelijk, al geldt dat niet voor de opmaakkant, zoals behandeld in verticaal schrijven voor Japans en Chinees
Ons advies is ronduit. Bevat het corpus een andere taal dan Engels, zet dan eerst soCanonicalEquivalent aan en zet haar pas uit nadat u haar op uw eigen documenten hebt getimed en de kosten onaanvaardbaar vindt. Het falen dat ze voorkomt, landt precies op de namen waar uw gebruikers het vaakst naar zoeken
Dezelfde Unicode-bewuste engine drijft zoeken, extractie, vervanging en redactie vanuit Delphi, C++Builder en Free Pascal; optiesets, de batch-API en de rest van de teksttoolkit staan vermeld op de productpagina van PDF Library for Delphi