Je voegt een nieuw labelbereik toe aan een handboek van een leverancier zodat de appendix App-a, App-b leest in plaats van A-1, A-2, slaat op, en opent het bestand opnieuw. De paginabox zegt nog steeds A-1. Open de catalogus in een teksteditor en de /PageLabels-dictionary laat de reden zien: hij draagt een /Kids-array die van de producent is geërfd en, vlak ernaast, een verse /Nums-array met jouw bereik. ISO 32000-1 laat een nummerboom-root één van die sleutels hebben, nooit allebei, en een reader die /Kids op de root aantreft daalt daarin af en kijkt niet verder
Hoe een PDF paginalabelbereiken opslaat
Paginalabels zijn de strings die een viewer in zijn paginabox toont in plaats van de fysieke pagina-index, en ISO 32000-1 §12.4.2 bewaart ze in een nummerboom onder de catalogussleutel /PageLabels. Elke sleutel is een 0-based pagina-index waar een labelbereik begint. Elke waarde is een labeldictionary met hooguit drie invoer: /S voor de nummerstijl (D, R, r, A of a), /P voor een prefixstring, en /St voor het nummer van de eerste pagina in het bereik, dat default 1 is. Een bereik loopt tot de volgende sleutel. De specificatie eist ook een invoer voor pagina-index 0, dus elke pagina in het document valt binnen een of ander bereik
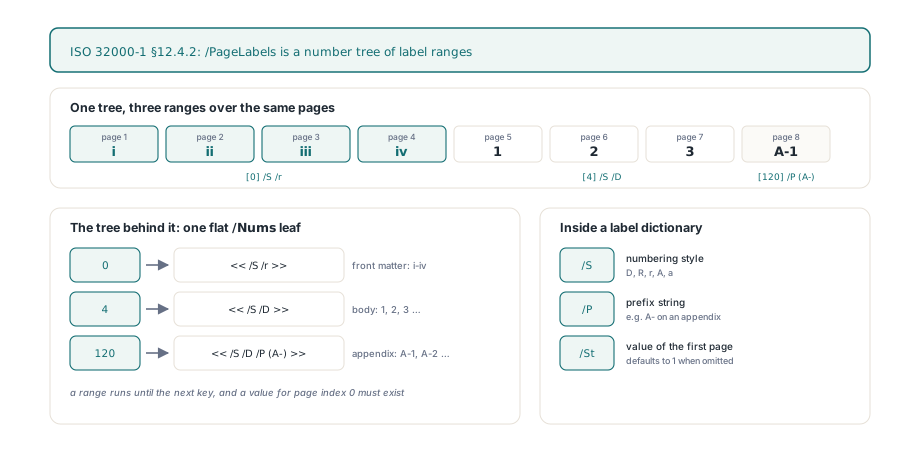
In PDF Library for Delphi is de schrijver TPDFlib.AddPageLabels(Start, Style, Offset, Prefix), en die landt met drie regels op die dictionary die het waard zijn te onthouden. Start is 1-based net als elk ander pagina-argument in de library, en hij gaat als Start - 1 de boom in. Style loopt van 0 tot 5: 0 schrijft helemaal geen /S, dus het label is alleen de prefix (handig voor één pagina met label Cover), en 1 tot 5 worden D, R, r, A en a. Een stijl buiten 0..5 laat de aanroep 0 teruggeven en laat het document onaangetast. Offset wordt alleen /St als hij groter dan nul is; geef 0 door en de sleutel blijft weg, wat elke reader als 1 leest
Een typisch boek uit een opmaakgereedschap heeft drie bereiken nodig: kleine romeinse cijfers voor het voorwerk, arabische getallen voor de kern, en een appendix met prefix
uses
  PDFlibrary;

var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Pagina's 1-4: i, ii, iii, iv (kleine romeinse cijfers)
    Lib.AddPageLabels(1, 3, 1, '');
    // Pagina's 5-120: 1, 2, 3 ... (decimaal, herstartend bij 1)
    Lib.AddPageLabels(5, 1, 1, '');
    // Vanaf pagina 121: A-1, A-2 ... (decimaal met een prefix)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
Paginalabels bestaan sinds PDF 1.3, dus elke aanroep vraagt het document ook om zijn uitvoerversie naar minstens 1.3 te tillen. Heb je de versie vastgezet met LockSaveVersion, dan wordt dat verzoek genegeerd en blijft de lock staan, want de library overrulet geen versie die je met opzet hebt gekozen. Zet je sowieso een lock, zet hem dan op 1.3 of hoger in elke taak die labels schrijft
Waarom verdwijnt een nieuw bereik als de root /Kids heeft?
Het bereik verdwijnt omdat ISO 32000-1 §7.9.7 (Tabel 37) de root van een nummerboom ofwel /Kids ofwel /Nums geeft, nooit allebei, en readers /Kids kiezen zodra die er staat. Producenten die lange documenten schrijven splitsen de boom vaak in tussenliggende knopen, elk met een /Limits-paar, die hangen aan een root met alleen /Kids. Een invoegroutine die alleen /Nums kent kijkt naar die root, vindt geen array, maakt er één naast de bestaande /Kids, en laat het nieuwe bereik daarin vallen. De schrijfactie slaagt. Het bestand blijft parsable. Elke viewer daalt vervolgens via /Kids af, ziet de oorspronkelijke drie bereiken van de producent, en raakt de verdwaalde array nooit aan, precies het handboeksymptoom uit de openingsalinea
De uitweg is stoppen met de root te behandelen als een container die zomaar een tweede ingang kan laten uitgroeien. Vindt AddPageLabels /Kids op de root, dan loopt hij eerst elke leaf van de bestaande boom van links naar rechts langs en verzamelt elke sleutel met zijn labeldictionary, en bouwt daarna één vlakke /Nums-array uit die lijst. /Kids, /Limits en een eventuele achtergebleven /Nums worden van de root gehaald voordat de vlakke array wordt vastgemaakt, en pas dan gaat het nieuwe bereik erin met een gewone gesorteerde insert. Ook /Limits verwijderen telt mee: Tabel 37 staat het alleen op tussenliggende knopen en leaves toe, en een root die hem houdt is malformed, ook als er nu /Nums in staat
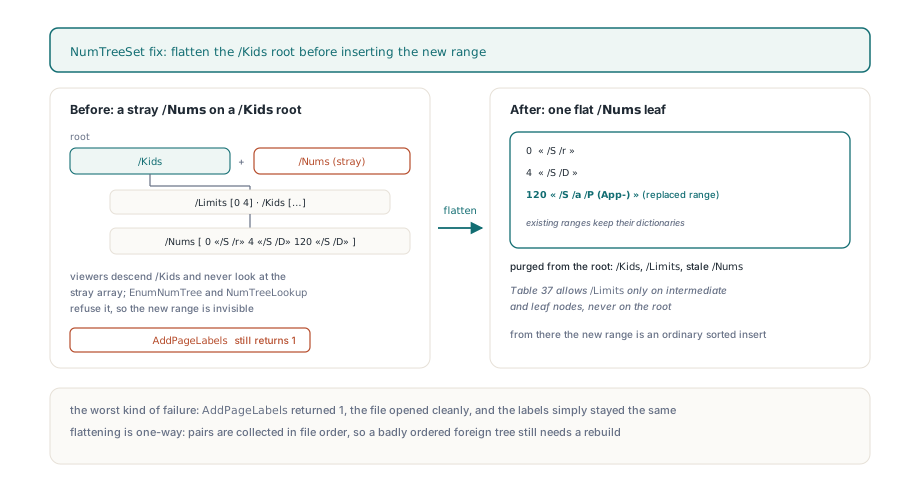
Eén bijeffect is makkelijk te missen. Bereikt een bestand je al kapot, met beide sleutels op de root omdat een eerder gereedschap de naïeve insert maakte, dan volgt de leafwalk /Kids precies zoals een viewer dat zou doen, dus de bereiken uit de verdwaalde array worden niet meegenomen. Een viewer toonde die bereiken ook nooit, dus de labels na de bewerking matchen wat readers al zagen
De afgeplatte boom wordt daarna niet herbouwd in gebalanceerde /Kids-knopen, en voor deze specifieke boom vinden wij dat de juiste keuze. Balanceren betaalt zich terug bij namenbomen met duizenden bestemmingen of ingesloten bestanden. Een paginalabelboom heeft één invoer per labelbereik, en zelfs een groot naslagwerk heeft zelden meer dan een paar dozijn nodig; een enkele leaf is ook wat de meeste producenten schrijven als ze niet om het splitten zelf splitten. Een herbalanceringspas zou code toevoegen die bij elke opslag fout kan gaan, voor een opzoekingwinst die niemand kon meten op een boom zo klein
// Label de appendix opnieuw in een bestand waarvan de /PageLabels-root /Kids gebruikt
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // bv. A-1
  // Zelfde startpagina als het bestaande bereik, dus zijn waarde wordt vervangen
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
  begin
    WriteLn('After: ', Lib.GetPageLabel(121));  // App-a
    WriteLn('Front: ', Lib.GetPageLabel(2));    // ii, ongewijzigd
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  end;
end;
Omdat het nieuwe bereik op dezelfde pagina-index als een bestaande sleutel begint, vervangt de insert de dictionary van die sleutel in plaats van een tweede invoer voor pagina-index 120 toe te voegen. De romeinse en decimale bereiken uit de leaves van de producent komen mee met hun oorspronkelijke dictionaries, inclusief eventuele /St-waarden
De leafwalk moet ook misvormde bomen overleven. Een /Kids-invoer die terugwijst naar een van zijn eigen voorouders, of twee takken die een leaf delen, duikt op in bestanden uit beschadigde pijplijnen. De traversatie onthoudt welke knopen hij al heeft bezocht, dus een cyclus wordt één keer gelopen en daarna losgelaten, en een gedeelde leaf levert zijn bereiken één keer aan. Dezelfde kwesties voor namenbomen staan behandeld in naamboomcycli, slechte /Limits en grote leaves aanpakken
Een /Nums-array per paar doorlopen
Een /Nums-array is een vlakke reeks afwisselende invoer, [key0 value0 key1 value1 ...], en alleen de even posities zijn sleutels. Die indeling lokt een klassieke fout uit. Een lus die één element per stap neemt en vraagt "is dit een getal?" vergelijkt waarden alsof het sleutels zijn zodra een waarde toevallig numeriek is. Wint die vergelijking een kleiner-dan-test, dan landt het invoegpunt op een oneven index, valt het nieuwe paar middenin een bestaand paar, en wisselen alle latere sleutels en waarden van plaats
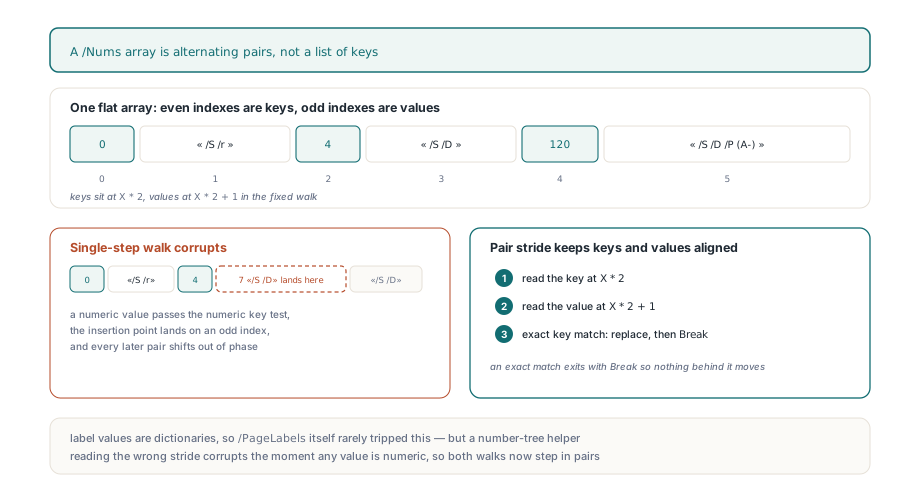
Paginalabelwaarden zijn dictionaries, dus de bug verstopt zich op /PageLabels zelf. Hij komt boven water op de dag dat dezelfde helper wordt hergebruikt voor een nummerboom waarvan de waarden kale getallen zijn, en niets in de syntax van de array waarschuwt welk soort je vasthoudt. PDF Library for Delphi leest sleutels op index X * 2 en waarden op X * 2 + 1, zowel in de leafwalk als in de insert, en een exacte sleutelmacth vervangt de waarde en stopt de scan. Schrijf je eigen nummerboomcode tegen ruwe objecten, kopieer dan eerst die pas voordat je ergens anders over nadenkt
Labels teruglezen met GetPageLabel
TPDFlib.GetPageLabel(Page) geeft het label voor een 1-based pagina terug, en zijn twee terugvallen gedragen zich met opzet verschillend. Een document zonder enige /PageLabels-invoer geeft het decimale paginanummer terug, zodat een aanroeper de functie onvoorwaardelijk voor weergave kan gebruiken. Een document dat een boom heeft maar geen bereik dat de gevraagde pagina dekt, geeft een lege string terug. Dat tweede geval is wat een bestand oplevert dat de verplichte invoer voor pagina-index 0 overslaat: de eerste pagina's hebben in de zin van de specificatie geen label, en een lege string meldt dat eerlijker dan een verzonnen getal zou doen. Begin je labelset altijd op pagina 1
Letterstijlen volgen de PDF-specificatie in plaats van spreadsheetkolommen. Na Z komt AA, dan BB, dan CC; de letter herhaalt zich in plaats van over te dragen, dus pagina 53 van een A-bereik is AAA. Romeinse cijfers worden in hoofdletters gegenereerd voor R en in kleine letters voor r, en de prefix wordt in beide gevallen ongewijzigd voorgeplakt
var
  P: Integer;
  Data: WideString;
begin
  // Snelle audit van wat een viewer in zijn paginabox zal tonen
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // Optiewaarde 4 exporteert alleen de labelbereiken, één PageLabelBegin
  // blok per bereik
  Data := Lib.ExportDocumentData(4);
  // ... bewerk de tekst, of draag hem naar een ander bestand ...
  // De eerste labelrecord leegt bestaande bereiken, daarna wordt elke record
  // herhaald via AddPageLabels; geeft de toegepaste records terug
  WriteLn(Lib.ImportDocumentData(Data, 4), ' label ranges applied');
end;
Voor bulkbewerkingen schrijft ExportDocumentData met optiewaarde 4 elk bereik als een PageLabelBegin-blok gevolgd door PageLabelNewIndex (de 1-based startpagina), PageLabelStart, een optionele PageLabelPrefix en PageLabelNumStyle-regels, met namen als LowercaseRomanNumerals en DecimalArabicNumerals. ImportDocumentData behandelt de eerste labelrecord die hij tegenkomt als een volledige vervanging: hij roept één keer ClearPageLabels aan, wat de hele /PageLabels-invoer uit de catalogus haalt, en voert daarna elke record aan AddPageLabels. De herbouwde boom is vanaf het begin een enkele leaf, dus een tekstrondje door een /Kids-vormig origineel komt terug in dezelfde vlakke vorm die de herlabelroute oplevert
Leafvolgorde en paginaverplaatsingen na het herlabelen
Afplatten houdt de bereiken in de volgorde waarin hij ze aantreft. §7.9.7 eist sleutels in oplopende volgorde, maar bestanden met leaves in de verkeerde volgorde doen zeker de ronde, en GetPageLabel past het laatste bereik in die volgorde toe waarvan de sleutel op of onder de pagina-index zit. Voor een bestand dat zijn bereiken aangeeft als [0 roman, 120 A-, 4 decimal], met het decimale bereik startend bij 1, lost pagina 122 op naar het decimale bereik en leest 118 waar je A-2 verwachtte. Laat de pagina-voor-pagina-audit hierboven zulke labels zien, plak ze dan niet dicht met nog een AddPageLabels-aanroep. Roep ClearPageLabels aan en schrijf de volledige set opnieuw in oplopende volgorde; vier aanroepen zijn goedkoper dan uitrekenen welk bereik wint
Labels zijn ook gebonden aan pagina-indices, niet aan paginaobjecten. Alles wat het paginanaantal of de volgorde verandert, laat de bereiken precies waar ze stonden, wijzend naar welke pagina's er nu op die indices zitten. Een in-place wissel zoals pagina's vervangen met behoud van objectnummers houdt het aantal vast, dus de labels blijven uitgelijnd. Een merge zoals interleaved duplexscans colleren levert een nieuwe paginareeks op, en die uitvoer verdient een vers geschreven set bereiken na de merge, startend op pagina 1
De labelaanroepen, de /Kids-afvlakting en de documentdata-export en -import die hierboven staan, maken deel uit van PDF Library for Delphi, die zich richt op Delphi, C++Builder en Lazarus; de referentie-invoer voor AddPageLabels zet de stijlwaarden en retourcodes in één tabel