Een LZW-encoder-dictionary loopt altijd één entry voor op de decoder die zijn output zal lezen, dus de twee kanten kunnen geen enkele codebreedte-drempel delen. PDFlibPas geeft TPLLZWEncoder en TPDFLZWDecompressor aparte drempels die uit dezelfde EarlyChange-flag zijn afgeleid, en die voorsprong van één entry is de hele reden dat de flag überhaupt bestaat
Bijna elke handgeschreven LZW-implementatie gaat op dezelfde plek de fout in. Je schrijft eerst de decoder, want die heb je nodig om bestanden te openen. Het werkt. Daarna schrijf je de encoder, spiegel je de decoderlogica regel voor regel omdat LZW symmetrisch is, draai je een round-trip-test en hij slaagt. Je shipt. Zes maanden later opent een klant je output in een viewer die niet van jou is, en vanaf ergens midden in de stream is het garbage. De spiegel was de bug: de twee helften van LZW zijn niet symmetrisch, en doen alsof ze dat wel zijn levert streams op die alleen je eigen code kan lezen
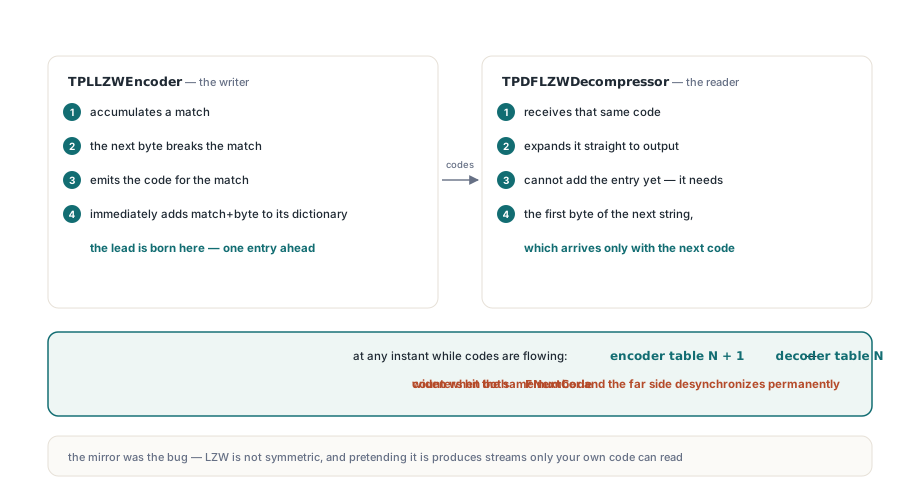
Waarom heeft de encoder een andere drempel nodig dan de decoder?
Omdat de encoder elke dictionary-entry één stap eerder leert dan de decoder kan. Dat is geen ontwerpkeuze in PDFlibPas; het zit inherent in hoe LZW werkt, en elke correcte implementatie moet er ergens voor compenseren. Loop de lus door en je ziet waar de voorsprong vandaan komt. De encoder accumuleert een match, ontdekt dat de volgende byte hem breekt, emitteert de code van de match en voegt match-plus-byte direct aan zijn dictionary toe. De decoder ontvangt dezelfde code en expandeert hem, maar kan de bijbehorende entry nog niet toevoegen, want de nieuwe entry heeft de eerste byte van de volgende string nodig, die pas met de volgende code arriveert. Op elk moment dat codes stromen bevat de encodertabel dus één entry meer dan de decodertabel. Verbreden beide kanten de code van 9 naar 10 bits wanneer hun eigen FNextCode hetzelfde getal raakt, dan verbreden ze één code uit elkaar en desynchroniseert de bitreader aan de andere kant permanent. In TPDFLZWDecompressor.ResetDictionary wordt de decoderdrempel één keer berekend en in FChangeCode opgeslagen:
// TPDFLZWDecompressor.ResetDictionary: de decoderkant van de drempel
FCodeSize := FInitialCodeSize;                 // 9 voor PDF LZWDecode
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // verbreden wanneer FNextCode 511 raakt
else
  FChangeCode := FBitMask + 1;                 // verbreden wanneer FNextCode 512 raakt
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
De decode-lus verbreedt direct nadat hij een entry append, test (FNextCode = FChangeCode) and (FCodeSize < 12) en herberekent zowel FBitMask als FChangeCode voor de nieuwe breedte. Negen bits kantelen bij 511 of 512, tien bits bij 1023 of 1024, elf bits bij 2047 of 2048, en twaalf bits is het plafond waarop het dictionary met een ClearCode moet worden gespoeld in plaats van gegroeid. De encoder kan geen van die getallen hergebruiken. Zijn GrowCodeSize telt er één bij op om voor de voorsprong te compenseren, dus met EarlyChange aan verbreedt hij bij 512 terwijl de decoder bij 511 verbreedt:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 bij 9 bits
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 bij 9 bits
  // De decoder voegt zijn laatste hangende entry toe voordat hij EOI leest.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;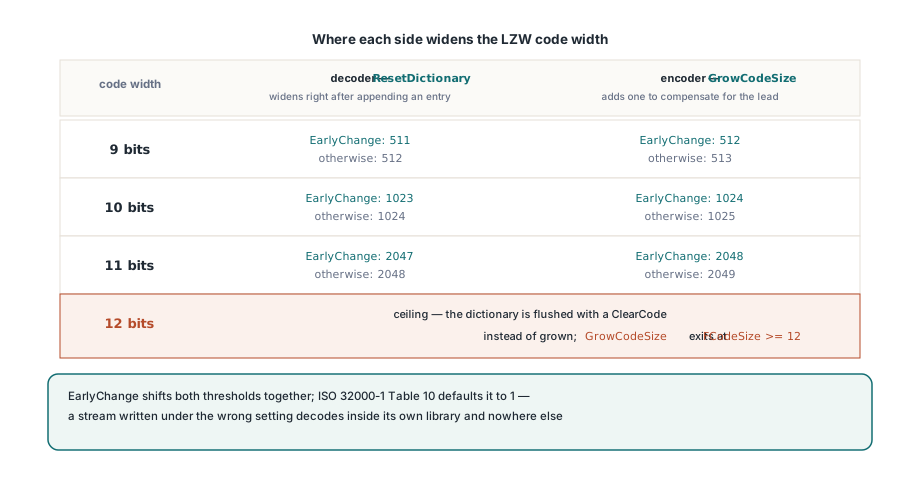
De laatste datacode is waar de twee kanten elkaar eindelijk ontmoeten
Het einde van de stream is de enige plek waar de encoder moet stoppen met voorlopen en als de decoder moet denken, en daar is de parameter FinalDataCode op GrowCodeSize voor. Emitteer de EOI-code op de verkeerde breedte en alles ervoor is nog perfect valide, dus het defect verstopt zich achter duizenden correcte bytes. De volgorde gaat zo. De encoder emitteert zijn laatste datacode en voegt, anders dan bij elke eerdere iteratie, daarna niets aan zijn eigen dictionary toe, want er is geen volgende byte meer over om de match mee te verlengen. De decoder doet het tegenovergestelde: hij ontvangt die laatste code en kan pas nu de entry completeren die hij sinds de vorige code vasthield. Bij de laatste stap haalt de decoder in, de voorsprong krimpt naar nul, en de breedte waarmee hij EOI zal lezen wordt beslist door een entry die de encoder nooit maakte. Dec(ChangeCode) is de encoder die voor exact één aanroep doet alsof hij de decoder is:
// TPLLZWEncoder.Compress, de staart van de stream
EmitCode(CurCode);      // laatste datacode, op welke breedte ook actueel
GrowCodeSize(True);     // mag verbreden via de verlaagde drempel
EmitCode(FEOICode);     // EOI op de breedte die de decoder daadwerkelijk leest
FlushBits;
FlushOutput;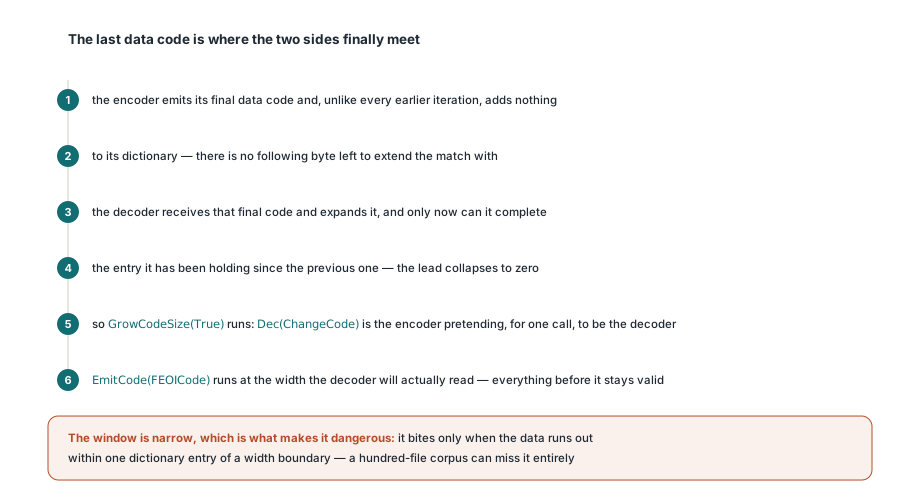
Het venster waarin dit er toe doet is smal, en dat is precies wat het gevaarlijk maakt. Het bijt alleen wanneer de data toevallig binnen één dictionary-entry van een breedtegrens opraakt, dus een corpus van honderd testbestanden kan het volledig missen terwijl één klantbestand er elke keer op loopt. Grensgevallen in Compress moeten bewust gestuurd worden: knutsel inputs waarvan het dictionary op 510, 511 en 512 entries landt, en lees de geëmitteerde EOI-bitbreedte dan met de hand uit de stream in plaats van hem af te leiden uit een succesvolle decode
Waarom kan een slaagende round-trip-test toch een gebroken stream verbergen?
Omdat twee implementaties die dezelfde fout maken het met elkaar eens zijn. Verbreden je encoder en je decoder allebei één code te vroeg, of allebei één code te laat, dan blijven ze in lockstep, reproduceert de round trip de input byte voor byte en is de suite groen terwijl de stream die je produceerde door niets anders leesbaar is. Dat is het meest waardevolle om uit de hele oefening mee te nemen: voor LZW is zelfconsistentie als bewijs niets waard. Self round-tripping kan dus niet de primaire test zijn, en PDFlibPas valideert het LZW-pad op drie andere manieren. Handgebouwde codestreams waarvan het verwachte bitpatroon met de hand is uitgeschreven, zodat de assertie over de bytes gaat in plaats van over het resultaat van het decoden ervan. Bidirectionele interoperabiliteit tegen onafhankelijke implementaties, waarbij streams die deze encoder produceerde elders worden gedecodeerd en streams die elders zijn geproduceerd door TPDFLZWDecompressor worden gedecodeerd. En differential decoding: dezelfde bytes twee keer lezen met EarlyChange in beide standen, zodat een stream die onder de verkeerde instelling schoon decodeert je vertelt dat de breedtegrenzen nooit zijn aangeraakt:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // bewust de verkeerde regel voor PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A moet overeenkomen met de bron; B moet dat NIET doen. Komt B ook overeen,
// dan was de input te kort om een codebreedtegrens te kruisen.
Externe inputs geven deze dekking pas echt. Het huidige testmateriaal kruist de breedtes 9, 10, 11 en 12 bits en dwingt 34 dictionary-resets af in één stream, de enige realistische manier om te bewijzen dat het ClearCode-pad op het 4095-plafond überhaupt werkt. Worden je fixtures nooit groter dan een paar kilobytes, dan is geen van die code ooit gedraaid. En wanneer een fix verandert wat je encoder produceert, behandel de oude output dan als gebroken in plaats van als een compatibiliteitsbaseline die behouden moet blijven; een stream die codebreedtes verkeerd mixt is geen legacy-formaat, het is een bug die toevallig naar schijf is geschreven
PDF zegt 1, TIFF zegt het hangt ervan af
PDFlibPas zet EarlyChange standaard op True bij zowel TPLLZWEncoder als TPDFLZWDecompressor, omdat ISO 32000-1 Tabel 10 EarlyChange definieert als een LZWDecode-decodeparameter met een defaultwaarde van 1, wat betekent dat de codelengte één code vroeg toeneemt. Dat is gespecificeerd in ISO 32000-1 sectie 7.4.4.2 naast de predictor-parameters, en een PDF die het andere gedrag wil moet expliciet /EarlyChange 0 in zijn /DecodeParms-dictionary zetten. TIFF is de reden dat de flag een property is in plaats van een constante: TIFF 6.0 sectie 13 beschrijft LZW-compressie zonder dezelfde ondubbelzinnige uitspraak, en encoders in het wild hebben er historisch over gesplitst, wat zeer waarschijnlijk de reden is dat de PDF-specificatie de parameter überhaupt een naam gaf. Op een TIFF-naar-PDF-pipeline is de instelling dus geen ding dat je aan weerszijden kunt hardcoden. Wat de TIFF-kant ook bleek nodig te hebben, moet expliciet in de PDF /DecodeParms worden meegenomen, of je converteert een bestand dat prima opende naar een bestand dat dat niet doet. Dezelfde zorg geldt voor FillOrder, waar foTop en foBottom selecteren aan welk uiteinde van de byte de bitreader vult, en voor TIFF Predictor 2 horizontale differencing, die TPDFLZWParms via Predictor, Colors, BitsPerComponent en Columns doorgeeft. Onze notities over de ingebouwde TIFF-decoder voor BigTIFF en tiled layouts hardenen dekken de rest van dat pad
Twee kleinere valkuilen die een naam verdienen
Beide zijn makkelijk verkeerd te bedraden wanneer je de encoder- en decoderobjecten zij aan zij open hebt en aanneemt dat de symmetrie daar ook geldt:
InitialCodeSizebetekent niet hetzelfde op beide klassen.TPLLZWEncoder.InitialCodeSizeis de wortelsymboolbreedte, gevalideerd van 2 tot en met 8, waarbijInitDictionaryFClearCodeafleidt als1 shl FInitialCodeSizeenFCodeSizeopFInitialCodeSize + 1zet.TPDFLZWDecompressor.InitialCodeSizeis de eerste codebreedte, gevalideerd van 2 tot en met 9, waarbijResetDictionaryFClearCodeafleidt als1 shl (FCodeSize - 1). Voor gewone 8-bit PDF-data zijn de defaults respectievelijk 8 en 9 en merk je er niets van; zet je ze allebei met de hand op hetzelfde getal, dan heb je een mismatched paar gebouwd- Ongetrouwde LZW decoden is een geheugenveiligheidsprobleem voordat het een correctheidsprobleem is, want de dictionary-indices komen rechtstreeks uit het bestand.
TPDFLZWDecompressorwijst elke code boven 4095 of op of bovenFNextCodeaf, weigert entries boven 4095 toe te voegen, checkt de resterende input in bits vóór elkeGetNextCodeen steltSawExplicitEOIbeschikbaar zodat een caller een netjes afgesloten stream van een stream die alleen opraakte aan bytes kan onderscheiden. Een afgekapte stream is geen gedeeltelijk succes. Het bredere overzicht in een Pascal PDF-parser tegen kwaadaardige bestanden hardenen dekt de klasse defect die deze guards sluiten
Wat dit je oplevert
LZW ziet er symmetrisch uit en is het niet. Het encoder-dictionary loopt één entry voor door de body van de stream en de voorsprong verdwijnt bij de laatste code, dus een correcte implementatie draagt twee drempels plus één speciaal geval, en de EarlyChange-flag verschuift beide drempels samen. Sta je er aan een van beide één code naast, dan produceer je output die valide is totdat hij het plots niet meer is, zonder fout en zonder exception ergens, alleen een viewer die ergens ruis rendert. De eerlijke grens is dat niets hiervan van binnenuit testbaar is: niets in je eigen suite kan een correcte stream van een consistent foute onderscheiden, dus de interoperabiliteitscheck is geen optionele extra pass, het is het enige echte bewijs dat je ooit zult krijgen. Beide klassen zitten in de PDF Library for Delphi, die ook de omliggende structuurwerk afhandelt die in onze notities over object streams en cross-reference streams staat, voor Delphi en C++Builder over de compilerversies die de library ondersteunt