Een FDF-annotatie-importeerder kan het aantal gelezen items teruggeven zonder ook maar één ervan aan het document toe te voegen: elk item geteld, elk item weggegooid. TPDFlib.ImportAnnotationsFromFDFString in losLab PDF Library leest sleutels in willekeurige volgorde, parseert /Rect correct en onafhankelijk van de landinstelling en geeft het aantal werkelijk toegevoegde annotaties terug, terwijl de bijbehorende exporter de echte /Rect van de annotatie wegschrijft, zodat exporteren, importeren en nogmaals exporteren byte-identieke FDF oplevert. De rest van deze notitie legt uit hoe één verkeerde beginoffset een perfecte stille mislukking produceert, welke drie andere valkuilen erachter schuilen en hoe je een import zelf controleert in plaats van een retourwaarde te vertrouwen
Het scenario is alledaags. Een reviewer voorziet een contract van aantekeningen, de opmerkingen reizen als FDF-bestand (Acrobat noemt het Export Comments) en je Delphi-service voegt ze met een FDF-importaanroep samen in een schone kopie. De aanroep geeft 7 terug, het log meldt "7 opmerkingen geïmporteerd", de job gaat op groen en de uitgaande PDF bevat geen enkele opmerking. Geen exception, geen waarschuwing, en het getal leek geloofwaardig omdat het het echte aantal items in het bestand was. Dat is de ergste vorm die een bug kan aannemen: een functie wiens enige succes-signaal een teller is die onafhankelijk van het werk dat hij beweert te rapporteren wordt bijgehouden
Waarom kan een FDF-import succes melden zonder iets toe te voegen?
Omdat een naamlezer op de verkeerde plek kan beginnen en een teller buiten de code kan leven die het werk doet. Een sleutelzoeker die de positie onmiddellijk na /Subtype teruggeeft landt op de witruimte vóór de waarde. Een ReadName die op die spatie begint en stopt bij het eerste witruimteteken stopt voordat hij iets gelezen heeft, dus elk subtype komt leeg terug. Een helper als AddAnnotationToPage die weigert een annotatie te bouwen zonder subtype maakt op zichzelf de juiste defensieve keuze, maar als het een procedure zonder retourwaarde is en de Inc(Result) van de aanroeper erbuiten zit, veranderen de twee bewakingen samen "er werkte niets" in "alles werkte". De correcte naamlezer slaat witruimte over, eist de leadende / van een PDF-name-object en stopt bij elk scheidingsteken, inclusief [, ( en ), dus /Subtype/Text en /Subtype /Text leveren beide Text op; zo leest losLab PDF Library namen
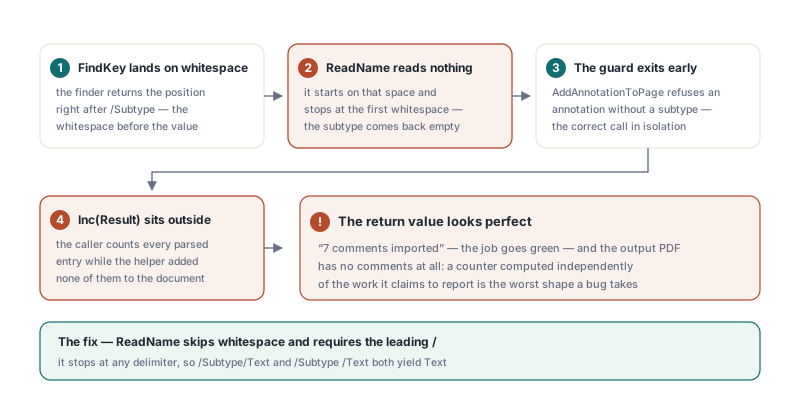
Ook de retourwaarde verdient meer zorg dan dat. Een importeerder die voor elke goed gevormde dictionary in de /Annots-array verhoogt rapporteert nog steeds te veel wanneer een item een buiten bereik vallende 0-based /Page of een ontbrekend /Subtype heeft, die beide worden overgeslagen. In losLab PDF Library geven ImportAnnotationsFromFDFString en ImportAnnotationsFromFDF het aantal werkelijk toegevoegde annotaties terug, net als de XFDF-import: de FDF-helper AddAnnotationToPage geeft een Boolean terug en de teller beweegt alleen bij succes. Het document meten blijft de sterkere controle, want die klopt ongeacht welke code het getal produceerde, dus de schets hieronder vergelijkt AnnotationCount op elke pagina voor en na de import
function TotalAnnotations(Lib: TPDFlib): Integer;
var
  Page, Saved: Integer;
begin
  Result := 0;
  Saved := Lib.SelectedPage;
  for Page := 1 to Lib.PageCount do
    if Lib.SelectPage(Page) = 1 then
      Inc(Result, Lib.AnnotationCount);   // per geselecteerde pagina, widgets inbegrepen
  Lib.SelectPage(Saved);
end;

var
  Lib: TPDFlib;
  Before, Reported, Added: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contract.pdf', '');
    Before := TotalAnnotations(Lib);
    Reported := Lib.ImportAnnotationsFromFDF('review-comments.fdf');
    Added := TotalAnnotations(Lib) - Before;
    if Added <> Reported then   // gelijk wanneer elk item op een pagina terechtkwam
      Writeln(Format('Importer reported %d, %d landed on a page', [Reported, Added]));
    Lib.SaveToFile('contract-reviewed.pdf');
  finally
    Lib.Free;
  end;
end;
Nog drie valkuilen achter de eerste
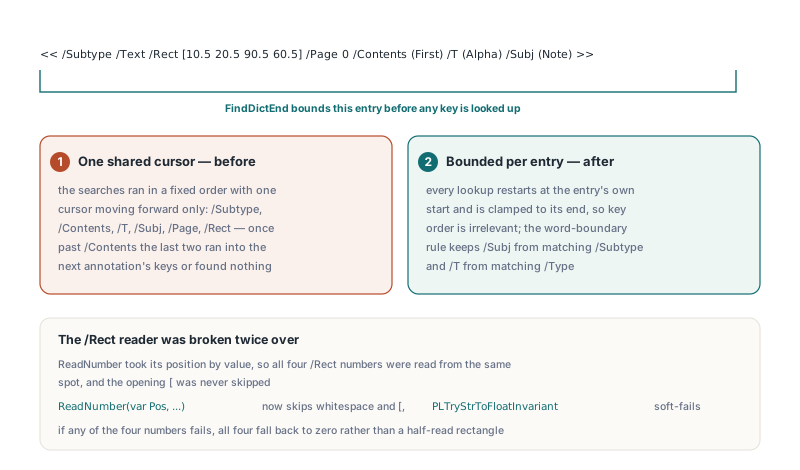
Alleen het subtype repareren legt nog drie valkuilen bloot in hetzelfde soort parser, elk onzichtbaar zolang er nooit een annotatie een pagina bereikt. Ten eerste: een ReadNumber die zijn positie als value-parameter neemt leest dezelfde plek vier keer wanneer hij achter elkaar voor de vier /Rect-getallen wordt aangeroepen, en als hij de openings-[ niet overslaat leest hij in de praktijk helemaal niets. Ten tweede: een FindKey die één vooruit schuivende cursor over alle opvragingen deelt is afhankelijk van sleutelvolgorde. Een exporter schrijft mogelijk /Subtype, /Rect, /Page, /Contents, /T, /Subj terwijl de importeerder zoekt in de volgorde /Subtype, /Contents, /T, /Subj, /Page, /Rect; zodra de cursor /Contents is gepasseerd loopt de zoektocht naar /Page en /Rect voorbij het huidige item en vindt hij of niets of de sleutels van de volgende annotatie, dus de importeerder kan niet eens de uitvoer van zijn eigen exporter lezen. Ten derde: getallen die via een routine worden geparseerd die de decimale scheider van het systeem volgt, zoals PLStrToFloat, breken op machines met een komma-landinstelling. ISO 32000-1 §12.7.7 definieert FDF als PDF-objectsyntaxis en dictionary-sleutels zijn in PDF ongeordend (§7.3.7), dus elke FDF-parser die een sleutelvolgorde aanneemt is per definitie fout, ongeacht welke tool het bestand produceerde
losLab PDF Library zet eerst een grens om elk item. FindDictEnd loopt van de openings-<< naar de bijpassende >>, houdt geneste dictionaries bij en slaat de bodies van letterlijke strings met hun backslash-escapes over, zodat een >> in een opmerking als (see section >> 4) het item niet voortijdig kan beëindigen. Elke sleutelopvraging begint daarna aan het eigen begin van het item en is beperkt tot zijn einde, wat sleutelvolgorde irrelevant maakt en voorkomt dat één annotatie de /Page van een andere leent. De sleutelvergelijking accepteert ook een scheidingsteken direct na de naam, want /Contents(Hi) is even geldig als /Contents (Hi), terwijl de woordgrensregel verhindert dat /Subj het begin van /Subtype matcht en /T dat van /Type. ReadNumber neemt zijn positie als var-parameter, slaat witruimte en [ over en parseert met PLTryStrToFloatInvariant, dat bij een misvormd token zacht faalt in plaats van te raisen. Als één van de vier rechthoekgetallen faalt, vallen alle vier terug op nul in plaats van een halfgelezen rechthoek op te leveren
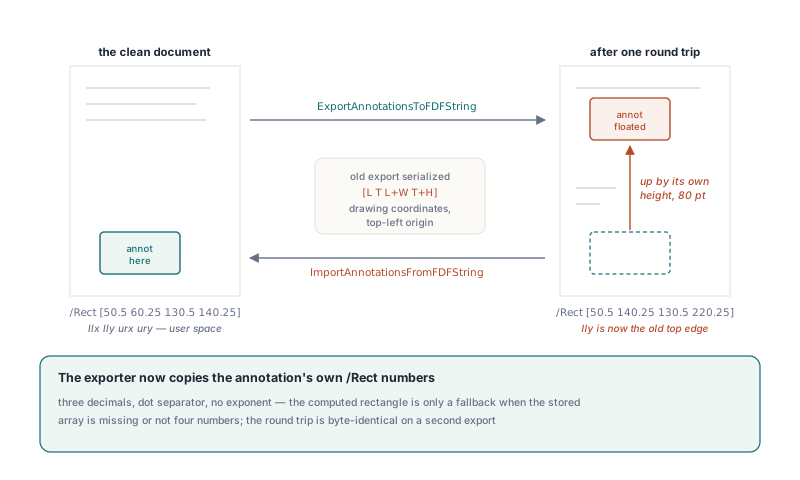
Waarom schuift elke annotatie bij een FDF-roundtrip om zijn eigen hoogte?
Omdat het makkelijk is een rechthoek in het verkeerde coördinaatmodel weg te schrijven. De /Rect van een annotatie is [llx lly urx ury] in default user space (ISO 32000-1 §12.5.2, met rechthoeken gedefinieerd in §7.9.5) en FDF draagt dezelfde array. GetAnnotRectEx rapporteert echter Left, Top, Width en Height in de tekencoördinaten van de library, de ruimte die SetOrigin bestuurt. Een exporter die die serialiseert als [L T L+W T+H] geeft de importeerder vier waarden die, woordelijk teruggeschreven als PDF-rechthoek, de bovenrand leggen waar de linkerbenedenhoek thuishoort, zodat elke roundtrip de annotatie om zijn eigen hoogte omhoog schuift. De exporter van losLab PDF Library kopieert de eigen /Rect-getallen van de annotatie, drie decimalen, punt als scheiding, geen exponent, en valt alleen terug op de berekende rechthoek wanneer de opgeslagen array ontbreekt of geen vier getallen is
Een roundtrip-test die het kopiëren waard is doet assertions op het document en op een tweede export, niet op de retourwaarde van de importeerder. Merk de verwachte telling van 2 op: AddNoteAnnotation maakt een Text-annotatie plus zijn Popup en beide reizen mee. De test draait de export en import bovendien onder een komma als decimale scheider, en daar speelt de andere helft van dit verhaal zich af
var
  Source, Target: TPDFlib;
  FDF: AnsiString;
  OldSep: Char;
begin
  Source := TPDFlib.Create;
  Target := TPDFlib.Create;
  try
    Source.NewPages(1);                     // now two pages
    Source.SelectPage(2);
    Source.AddNoteAnnotation(50.5, 60.25, 0, 80, 80, 120, 60,
      'Reviewer', 'Check this', 0.25, 0.5, 0.75, 0);
    Target.NewPages(1);

    OldSep := FormatSettings.DecimalSeparator;
    FormatSettings.DecimalSeparator := ',';   // simulate a German or French desktop
    try
      FDF := Source.ExportAnnotationsToFDFString;   // still writes /Rect [50.5 ...
      Target.ImportAnnotationsFromFDFString(FDF);
    finally
      FormatSettings.DecimalSeparator := OldSep;
    end;

    Target.SelectPage(2);
    Assert(Target.AnnotationCount = 2);           // the note and its popup
    Assert(Target.GetAnnotType(1) = 'Text');
    Assert(Target.ExportAnnotationsToFDFString = Source.ExportAnnotationsToFDFString);
  finally
    Target.Free;
    Source.Free;
  end;
end;
Het FDF-pad is gebouwd rond de kerndictionary van de annotatie. De importeerder bouwt elk item opnieuw op met /Type, /Subtype, /Rect, /Contents, /T en /Subj, en de exporter laat Widget-annotaties over aan de form-data-methoden, waar formuliervelden thuishoren. Voordat je op FDF vertrouwt voor kleur, flags, randstijl, popup-verwijzingen of appearance streams, raadpleeg de bredere kaart van welke data via welke methode reist in het overzicht van FDF-, XFDF- en XFA-form data interchange, en als je wilt inspecteren wat er werkelijk aangekomen is, behandelt outline-, annotatie- en action-introspectie de per-indexlezers zoals GetAnnotType, GetAnnotTitle en GetAnnotContentsEx
Hoe lees je FDF- en XFDF-bestanden met komma-decimalen?
Voor FDF is het antwoord ondubbelzinnig: een komma is geen scheidingsteken in PDF-syntaxis, dus een getaltoken dat precies één komma en geen punt bevat kan alleen een decimaal zijn die op een machine met een komma-landinstelling is geschreven. Zulke bestanden bestaan, bijvoorbeeld /Rect [10,500 20,250 40,750 60,125] van een exporter die getallen met de systeemlandinstelling formatteerde, en ReadNumber verandert die ene komma in een punt voordat hij parseert. Een token met twee komma's, of een komma en een punt, wordt afgewezen in plaats van gegokt. De lezer gebruikt ook geen exponentnotatie, wat aansluit bij ISO 32000-1 §7.3.3: PDF-getallen gebruiken die nooit
XFDF is lastiger, want in XML-attributen is de komma de scheider. Standaard XFDF (ISO 19444-1) schrijft rect="50.5,80.25,70.75,100.125" en dashes="4,2", terwijl een landspecifieke writer op een systeem met komma-landinstelling rect="50,500 80,250 70,750 100,125" en opacity="0,600" produceert. losLab PDF Library leest en schrijft XFDF-getallen in beide richtingen invariant en herkent de legacy-vorm via XFDFNormalizeLegacyDecimals alleen wanneer het attribuut op witruimte splist in precies het verwachte aantal tokens (vier voor rect, één voor opacity en width) en elk token de vorm cijfers-komma-cijfers heeft. Een standaard rect matcht nooit: het is ofwel één token met drie komma's ofwel tokens die op een komma eindigen. dashes wordt bewust met rust gelaten, want 4,2 kan twee streep lengtes zijn of een legacy 4.2, en geen enkele regel kan ze uit elkaar houden
const
  // Sleutels in een andere volgorde dan de exporter, plus komma-decimalen uit een export met komma-landinstelling
  LegacyFDF: AnsiString = '%FDF-1.2'#10'1 0 obj'#10'<< /FDF << /Annots ['#10 +
    '<< /Rect [10,500 20,250 40,750 60,125] /Page 0 /Contents (First) ' +
    '/Subtype /Text /T (Alpha) /Type /Annot >>'#10 +
    '] >> >>'#10'endobj'#10'trailer'#10'<< /Root 1 0 R >>'#10'%%EOF'#10;
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;               // een vers document heeft één pagina
  try
    Lib.ImportAnnotationsFromFDFString(LegacyFDF);
    Assert(Lib.AnnotationCount = 1);
    Assert(Lib.GetAnnotTitle(1) = 'Alpha');
    // Opnieuw geëxporteerd als XFDF met punt-decimalen: rect="10.500 20.250 40.750 60.125"
    Writeln(Lib.ExportAnnotationsToXFDFString);
  finally
    Lib.Free;
  end;
end;
Wat moet een annotatie-importtest eigenlijk controleren?
Een nuttige importtest doet assertions op de state van het doeldocument, nooit alleen op wat de importeerder over zichzelf zegt; bij de stille-nul-mislukking is de retourwaarde het ene getal dat intact blijft. Drie assertions vangen elke hier beschreven valkuil: het aantal annotaties op de verwachte pagina, één field dat via GetAnnotType of GetAnnotContentsEx wordt teruggelezen, en een tweede export die byte voor byte met de eerste wordt vergeleken. Dezelfde discipline geldt voor elke API die de documentstructuur in bulk herschrijft, inclusief de veldconsolidatie uit het samenvoegen van dubbele formuliervelden: controleer de resulterende boom, niet een geretourneerd totaal. De FDF- en XFDF-annotatiemethoden, met hun bestands- en stringvarianten, zitten in de losLab PDF Library for Delphi and C++Builder