Codeer de OID 2.999.3 zoals een snelle DER-helper dat vaak doet, met de eerste twee arcs in één byte gepakt, en de decoder geeft 1.15.3 terug. Twee andere leesfouten rond de CMS gedragen zich hetzelfde: een certificaattelling die de bytes van een buur opeet, en een ondertekenaar die wordt gematcht op een serienummer uit het verkeerde veld. In PDF Library for Delphi (PDFlibPas) loopt de handtekeninglezer door de CMS in /Contents als pure DER, begrenst elke geneste read op zijn parent-element, knipt de opvulling weg op de lengte die de CMS aangeeft en codeert de gecombineerde eerste OID-arc in base-128
Genoeg code heeft de leeszijde van een handtekening nodig. Long-term validation moet eerst het ondertekenaarcertificaat en zijn uitgevers uit een bestaande handtekening halen voordat er revocatiegegevens opgehaald kunnen worden. Een auditrapport moet kunnen zeggen wie er tekende. Een Lazarus-build op Linux heeft geen Windows-messagefuncties om op terug te vallen, want buiten Windows zijn de platform-CMS-aanroepen stubs die mislukken, en daarom doorloopt PDFlibPas de CMS in puur Pascal en gebruikt helemaal geen CryptoAPI
De ondertekenaarcertificaten uit een ondertekende PDF lezen
Vijf TPDFlib-methoden dekken de hele leeszijde, en elk neemt InputFile, Password, FieldName. Elke aanroep opent het bestand alleen-lezen, geeft antwoord en sluit het weer, dus er is geen documentstatus te beheren. GetSignatureEmbeddedCertificateCount en GetSignatureEmbeddedCertificateDER sommeren de certificates-set van de CMS op in coderingsvolgorde. GetSignatureSignerCertificateDER geeft het certificaat terug dat een bepaalde SignerInfo produceerde. GetSignatureCertificateChainLength en GetSignatureCertificateChainDER lopen vanaf die ondertekenaar richting de verste issuer die de handtekening meedraagt. Alle indexen zijn zero-based
De resultaten komen terug als AnsiString, en houd het daarop. Een DER-blob door string of een TStrings halen betekent een tekensetconversie, en de bytes die er aan de andere kant uitkomen parsen niet meer. Dat is ook waarom de bibliotheek certificaatlijsten als arrays van AnsiString bijhoudt en URL-lijsten als tekst van één per regel teruggeeft: adressen zijn platte ASCII en overleven de conversie, certificaatbytes niet
uses
  SysUtils, Classes, PDFlibrary, PDFlibEnterprise;

procedure SaveDer(const FileName: string; const Der: AnsiString);
var
  Fs: TFileStream;
begin
  Fs := TFileStream.Create(FileName, fmCreate);
  try
    if Der <> '' then
      Fs.WriteBuffer(Der[1], Length(Der));
  finally
    Fs.Free;
  end;
end;

const
  Src = 'contract-signed.pdf';
  Field = 'Signature1';
var
  Pdf: TPDFlibEnterprise;
  Count, ChainLen, I: Integer;
  SignerDer, LastDer: AnsiString;
begin
  Pdf := TPDFlibEnterprise.Create;
  try
    Count := Pdf.GetSignatureEmbeddedCertificateCount(Src, '', Field);
    WriteLn(Field, ': ', Count, ' certificate(s) in the CMS');
    for I := 0 to Count - 1 do
      SaveDer(Format('embedded-%d.cer', [I]),
        Pdf.GetSignatureEmbeddedCertificateDER(Src, '', Field, I));

    SignerDer := Pdf.GetSignatureSignerCertificateDER(Src, '', Field, 0);
    if SignerDer = '' then
      raise Exception.CreateFmt('%s: signer certificate missing or not matched', [Field]);
    SaveDer('signer.cer', SignerDer);

    ChainLen := Pdf.GetSignatureCertificateChainLength(Src, '', Field, 0);
    for I := 0 to ChainLen - 1 do
      SaveDer(Format('chain-%d.cer', [I]),
        Pdf.GetSignatureCertificateChainDER(Src, '', Field, 0, I));
    if ChainLen > 0 then
    begin
      // de laatste schakel kan nog een issuer hebben die de handtekening niet insloot
      LastDer := Pdf.GetSignatureCertificateChainDER(Src, '', Field, 0, ChainLen - 1);
      WriteLn('Issuer locations: ', Pdf.GetCertificateIssuerURLs(LastDer));
    end;
  finally
    Pdf.Free;
  end;
end;
Twee resultaten in dat programma zijn makkelijk verkeerd te lezen. Een telling van 0 zegt op zichzelf weinig: een ontbrekend veld, een verkeerd wachtwoord, een blob die geen DER is en een SignedData die de optionele certificates-set gewoon weglaat, komen allemaal terug als 0 of een lege string. Log de veldnaam naast het getal, zoals het voorbeeld doet, anders beland je bij het debuggen in het verkeerde bestand. Het tweede is de ketenlengte. De ketenbouwer gebruikt alleen certificaten die in de handtekening zijn ingebed, dus een keten die stopt vvóór een zelf-uitgegeven root is normaal. Teken een bestand met ons democertificaat, dat door een testroot wordt uitgegeven, en GetSignatureCertificateChainLength geeft 1 terug omdat die root niet in de CMS zit. De volgende schakel komt uit de adressen die GetCertificateIssuerURLs rapporteert, een aanroep die bij de Enterprise-editie hoort, samen met de rest van de long-term-validation-API
De ondertekenaarmatch zelf behandelt beide vormen van SignerIdentifier die RFC 5652 §5.3 toestaat. issuerAndSerialNumber is degene die iedereen test. De vorm [0] subjectKeyIdentifier, een impliciet getagde OCTET STRING met tag $80, is de tak die met de hand geschreven readers het vaakst vergeten, en ondertekenaars die zichzelf bij key identifier noemen, geven hem echt uit. Als de issuer-en-serievorm wordt gebruikt, moeten beide helften kloppen: een serienummer is alleen uniek binnen één issuer, dus matchen op alleen het serienummer kan uitkomen op een certificaat van een andere CA
Hoeveel van /Contents is eigenlijk de CMS?
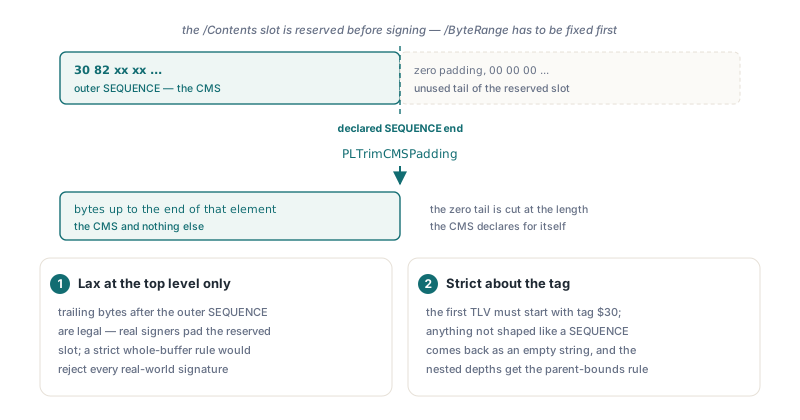
Alleen het prefix dat de buitenste SEQUENCE beslaat, en PLTrimCMSPadding in unit PDFlibCMSRead knipt alles daarna weg. De reden is de volgorde. ISO 32000-1 §12.8.1 vereist dat de /ByteRange vastligt voordat de signature value bestaat, dus een ondertekenaar reserveert vooraf de /Contents-hexstring, maakt hem royaal genoeg en vult de ongebruikte staart met nullen zodra de CMS bekend is. Een typisch ondertekend bestand draagt daardoor een reeks nullen na de CMS, zo lang als wat de ondertekenaar te veel reserveerde
PLTrimCMSPadding leest de eerste TLV, eist tag $30 en geeft de bytes tot het einde van dat element terug. Voer hem 30 03 02 01 00 00 00 00 en je krijgt de eerste vijf bytes terug; voer hem 'not der' en je krijgt een lege string. Dit toppje is de enige plek waar bytes aan het einde legaal zijn. Een strikte regel dat het element de hele buffer moet consumeren, zou gewone ondertekende bestanden weggooien, terwijl een soepele regel van 'wat er overblijft is prima' op elke diepte precies is hoe geneste velden bytes gaan lezen die niet van hen zijn
Waarom heeft een DER-lezer de eind-offset van de parent nodig?
Omdat een genest element alleen geldig is als het binnen zijn parent eindigt, en controleren tegen het einde van de buffer dat niet bewijst. DERReadTLV in PDFlibASN1 begrenst elk element op de hele string, weigert lengtes die voorbij het einde zouden lopen en doet de rekenkunde als aftrek, zodat een verzonnen vier-byte-lengte van $7FFFFFFF de check niet negatief kan laten omslaan. Dat is memory safety. Het zegt niets over of het element thuishoort waar het is gevonden
Denk aan een SignerInfo waarvan issuerAndSerialNumber 40 bytes aangeeft terwijl de issuer Name erin 60 claimt. Elke byte zit nog in de buffer, dus een op de buffer begrensde lezer accepteert de Name, leest daarna het 'serienummer' uit de digest-algoritme die volgt en vergelijkt dat paar met de ingebedde certificaten. Niets faalt. Soms lukt de vergelijking zelfs tegen het verkeerde certificaat
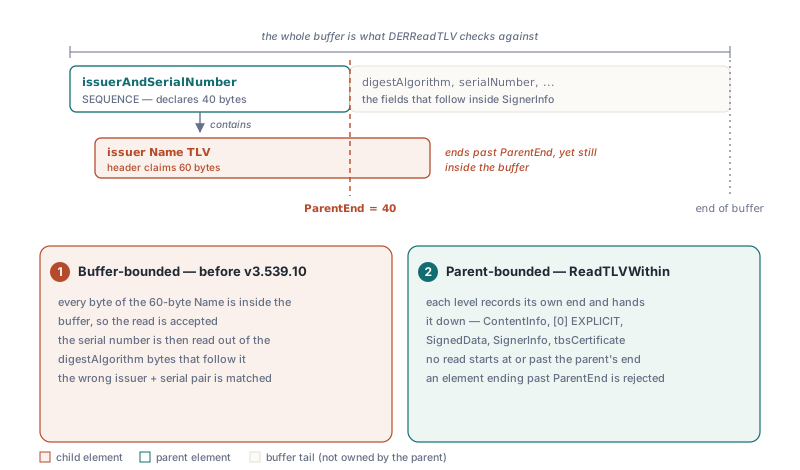
De CMS-walker van PDFlibPas neemt de eindpositie van de parent mee in elke read, van ContentInfo (RFC 5652 §3) via de [0] EXPLICIT-wrapper en de SignedData-velden (§5.1) naar elke SignerInfo en zijn identifier, en verder naar de tbsCertificate-velden die hij leest bij het matchen van een ondertekenaar. Schrijf je je eigen walker bovenop de publieke DERReadTLV, bijvoorbeeld voor een timestamp-token of een OCSP-response, dan is hetzelfde patroon een dozijn regels:
uses
  PDFlibASN1;

// Eéén child-read, geweigerd als het child voorbij zijn parent zou eindigen.
function ReadChild(const Data: AnsiString; ParentEnd: Integer;
  var Offset: Integer; out Tag: Byte; out Start, Len: Integer): Boolean;
begin
  Result := False;
  if (Offset < 1) or (Offset >= ParentEnd) then
    Exit;                          // niets meer over binnen de parent
  if not DERReadTLV(Data, Offset, Tag, Start, Len) then
    Exit;
  Result := Offset <= ParentEnd;  // Offset staat nu één voorbij het child
end;

// Telt de SEQUENCE-leden van een SET OF waarvan de content
// Data[SetStart .. SetEnd - 1] beslaat. Stopt bij het eerste lid dat overloopt.
function CountSequences(const Data: AnsiString; SetStart, SetEnd: Integer): Integer;
var
  Offset, Start, Len: Integer;
  Tag: Byte;
begin
  Result := 0;
  Offset := SetStart;
  while Offset < SetEnd do
  begin
    if not ReadChild(Data, SetEnd, Offset, Tag, Start, Len) then
      Break;                       // geen resync: de uitlijning is weg
    if Tag = $30 then
      Inc(Result);
  end;
end;
Let op de Break. Binnen de certificates-set en de signerInfos-set doet PLExtractCMSCertificates hetzelfde: een element dat voorbij het einde van de set loopt, stopt de lus, en de functie geeft de certificaten terug die hij al had geaccepteerd. Hij plakt nooit de bytes van de daaropvolgende crls of signerInfos op het laatste certificaat. Het slechte element overslaan en doorgaan is verleidelijk, en het is de verkeerde keuze. Zodra één opgegeven lengte fout is, weet de lezer niet meer waar het volgende element begint, en elke 'recovery' is een gok welke byte op een tag lijkt. Met de lus stilgevallen levert een set waarvan het tweede certificaat één byte overloopt, een telling van 1 op plus exact de bytes van het eerste certificaat zoals gecodeerd
Waarom kwam 2.999.3 eruit als 1.15.3?
De eerste twee arcs van een OID combineren tot één subidentifier, en dat subidentifier wordt base-128 gecodeerd zoals elke andere arc — het is geen enkele byte. X.690 §8.19.4 definieert de waarde als 40 * arc1 + arc2. Een encoder die hem met Byte(...) wegschrijft, klopt tot 127, wat 2.47 is. Voor 2.999 is de som 1079, een byte-cast houdt 55 over en 55 decodeert als 1.15. De identifier wijst nu een andere tak van de boom aan en niets protesteert. Waarden van 128 tot 255 breken anders: de cast emiteert één byte met de continuation-bit gezet, en de decoder slikt de volgende arc erin mee
De shortcut overleeft zo lang in echte code omdat de meeste PKI-identifiers de grens nooit bereiken. Alles onder 1.2.840, 2.5.29 en 0.4.0 heeft een gecombineerde eerste waarde ruim onder 128, dus een testsuite die alleen uit gangbare handtekening-OIDs bestaat, oefent de tweede byte nooit. Alleen de joint-iso-itu-t-arcs vanaf 2.48 steken de lijn over. In PDFlibPas dient één functie, DER_OID, als encoder voor signed attributes, als lookup binnen DERFindExtensionByOID en als SignedData-content-type-check, dus schrijven en matchen kunnen niet uit elkaar driften. Testvectoren horen aan beide kanten van de grens:
uses
  SysUtils, PDFlibASN1;

function Hex(const S: AnsiString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + IntToHex(Byte(S[I]), 2) + ' ';
  Result := Trim(Result);
end;

procedure Check(const Oid, Expected: AnsiString);
begin
  if Hex(DER_OID(Oid)) <> Expected then
    WriteLn('MISMATCH ', Oid, ': ', Hex(DER_OID(Oid)), ' expected ', Expected)
  else
    WriteLn('ok       ', Oid);
end;

begin
  Check('2.47.1',               '06 02 7F 01');     // laatste waarde in één byte
  Check('2.48.1',               '06 03 81 00 01');  // eerste waarde in twee bytes
  Check('2.999.3',              '06 03 88 37 03');  // een Byte-cast geeft 1.15.3
  Check('2.5.29.14',            '06 03 55 1D 0E');
  Check('1.2.840.113549.1.7.2', '06 09 2A 86 48 86 F7 0D 01 07 02');
end.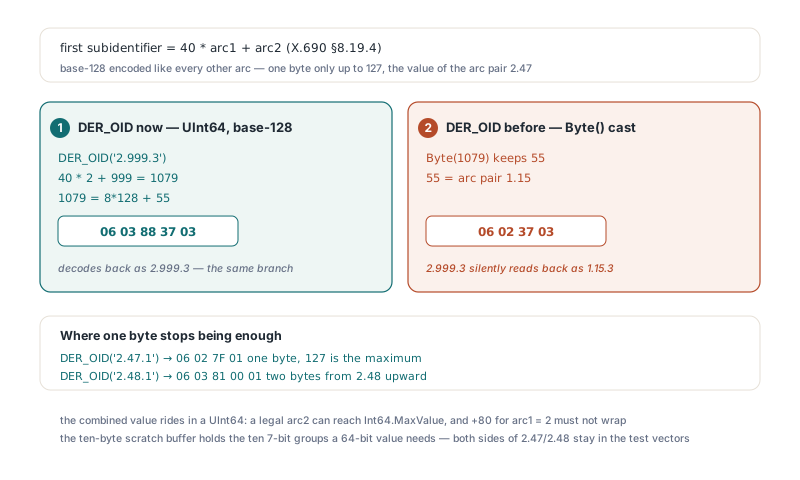
In dezelfde regel rekenkunde schuilt nog een overloop. DER_OID parst arcs in Int64, dus een legale tweede arc kan tot Int64.MaxValue gaan, en daar 80 voor arc1 = 2 bij optellen laat een signed 64-bit integer overlopen. De gecombineerde waarde zit daarom in een UInt64, die Int64.MaxValue + 80 zonder omslaan draagt. Niemand geeft OIDs van die grootte uit, maar een verzonnen string kan er nog steeds om vragen. De tien-byte-scratchbuffer in DER_OID bevat de tien 7-bit-groepen die een 64-bit-waarde nodig kan hebben, dus zelfs 2.9223372036854775807 codeert naar een subidentifier van tien bytes in plaats van om te slaan
Wat de CMS-walker accepteert en waar de verificatie zit
PDFlibCMSRead geeft bytes terug die zitten waar RFC 5652 zegt dat ze horen te zitten, en dat is zijn hele taak. Hij controleert geen signature value, geen digest en geen geldigheidsperiode. De walker accepteert alleen DER: DERReadTLV weigert indefinite lengths en tagnummers van meer bytes, dus een BER-gecodeerde CMS van een niet-conforme ondertekenaar rapporteert nul certificaten. Dat verkiezen we boven een partiële parse van BER. In de praktijk is de herkenningspunt een length-byte van $80 direct na de buitenste $30-tag, waarmee een SEQUENCE met indefinite length begint
Attribuutcertificaten en de andere CertificateChoices-alternatieven worden overgeslagen bij het doorlopen van de certificates-set, want alleen het gewone Certificate-alternatief is een X.509-certificaat waar ketenbouw en revocatielookups iets mee kunnen. Alles wat cryptografie is, blijft bij de code die ervoor verantwoordelijk is, en die begint met de byte-dekkingschecks in PAdES-ondertekening en ByteRange-validatie in Delphi en gaat verder met classificeren wat er veranderde nadat een PDF was ondertekend. Dezelfde gewoonte om opgegeven lengtes te wantrouwen loopt door het verharden van een Pascal-PDF-parser tegen kwaadaardige bestanden
Certificaten extraheren, ketens bouwen en de long-term-validation-aanroepen hierboven maken deel uit van losLab PDF Library for Delphi, dat draait op Delphi, C++Builder en Lazarus, zodat dezelfde handtekeningleescode werkt in een Windows-service en in een Linux-build