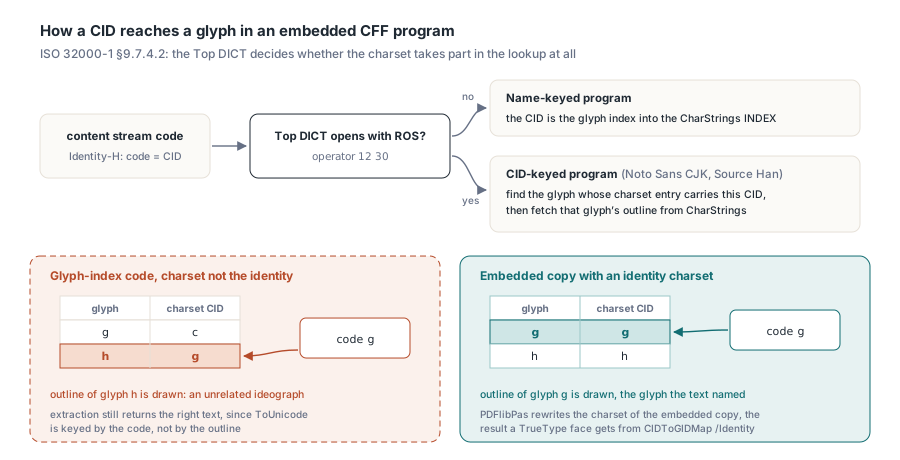
Een Chinese factuur gezet in Noto Sans SC uit het .otf-bestand kan in mutool openen met totaal andere ideogrammen op de plek van de klantnaam, terwijl een TrueType-font dezelfde pagina correct rendert. De oorzaak zit in de CFF-charset van het font; PDFlibPas herschrijft die in de embedded kopie naar de identity, zodat glyph-indexcodes bij de bedoelde glyphs uitkomen
Of een font het probleem laat zien hangt af van hoe het gebouwd is. Een TrueType-programma dat als CIDFontType2-font ge-embed wordt krijgt een CIDToGIDMap op Identity, en de code in de content stream landt op de bedoelde glyph. De meeste Latijnse OpenType-fonts met CFF-contouren zijn name-keyed, en een name-keyed CFF-programma gebruikt de binnenkomende CID direct als glyph-index. ISO 32000-1 merkt in §9.7.4.2 zelfs op dat CID en GID in veel fonts samenvallen. Niet in alle. De grote CJK-families die als CID-keyed fonts zijn gebouwd — Noto Sans CJK en zijn Source Han-broers daarbij — hanteren hun eigen CID-nummering, en een writer die glyph-indices rechtstreeks in die nummering stopt krijgt welke glyph dan ook die toevallig de matchende CID bezit
Wat een CID-keyed CFF-programma met een CID doet
ISO 32000-1 §9.7.4.2 splitst embedded CFF-programma's in twee gevallen door naar de Top DICT te kijken. Gebruikt de Top DICT de CIDFont-operators — in de praktijk opent hij met ROS (operator 12 30: registry, ordering, supplement) — dan pakt de reader de CID uit de content stream, zoekt de glyph wiens charset-entry die CID draagt en haalt pas daarna de outline uit de CharStrings INDEX. Zonder CIDFont-operators is de CID de glyph-index; de charset speelt geen rol. Elke reader die §9.7.4.2 volgt zoals hij geschreven is, tekent dus voor een glyph-indexcode de verkeerde glyph zodra de charset niet de identity is, in welke viewer u ook uitkomt. De charset zelf, gedefinieerd in Adobe Technical Note #5176, kent drie layouts met twee randgevallen:
- Formaat 0 slaat per glyph één 2-byte SID of CID op, in glyph-volgorde
- Formaat 1 slaat ranges op: een eerste CID gevolgd door een 1-byte telling van de glyphs die er met opeenvolgende CIDs op volgen
- Formaat 2 is dezelfde range-layout met een 2-byte telling, wat past bij fonts met lange ononderbroken reeksen
- Glyph 0 is
.notdefen heeft in geen enkel formaat een entry; een charset-offset van 0, 1 of 2 benoemt een van de predefined charsets in plaats van naar data te wijzen
Bepaal dus eerst welk soort font u in handen heeft. Identity-H aan de PDF-kant zegt alleen dat een 2-byte code gelijk is aan de CID. Hoe die CID een glyph bereikt woont helemaal in het fontprogramma. De functie hieronder leest de tabel CFF uit een .otf, wandelt de Top DICT langs op zoek naar ROS en controleert of de charset elke glyph op een CID met hetzelfde nummer afbeeldt. Hij heeft alleen de RTL nodig
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // een afgekapot bestand geeft ERangeError in plaats van verkeerd lezen
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Geeft het einde van de INDEX op Pos terug en kadert het eerste object in
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // offsets zijn vanaf hier 1-based
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // Name INDEX
  SkipIndex(P, Dict, DictEnd);                           // Top DICT INDEX
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // reëel getal
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // gereserveerde byte
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef heeft geen entry
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
Een rapport met CIDKeyed = True en IdentityCharset = False beschrijft precies het font waar dit stuk over gaat: elke writer die glyph-indices in de content stream zet zonder rekening te houden met die charset tekent er de verkeerde glyphs mee. Een name-keyed uitkomst, of een CID-keyed font waarvan de charset toevallig al de identity is, rendert onder dezelfde writer correct. Zo komt het dat het ene CJK-font in een product werkt en het volgende niet. De lus vergelijkt alleen de eerste CID van elke range. Dat is genoeg: een range dekt opeenvolgende glyphs met opeenvolgende CIDs, dus een range die op zijn eigen glyph-index begint blijft daar tot het einde op zitten
Glyph-indices reizen door de hele font-dictionary
Een PDF-writer heeft zelden CIDs in handen. Zowel de cmap-tabel als de shaping-engine geven glyph-indices terug, dus het natuurlijke ontwerp schrijft die indices weg als 2-byte Identity-H-codes en hangt alles daaraan op: de /W-breedte-array, de /CIDSet-bitmap die PDF/A vraagt en de ToUnicode CMap die extractie de brontekst laat terugvinden. TrueType heeft een escape hatch. Tabel 117 biedt CIDToGIDMap, maar alleen voor Type 2 CIDFonts; een CFF-programma huist in een CIDFontType0-font, dat geen manier heeft om een CID vanaf de PDF-kant om te buigen. Daarmee vervalt ook de truc waarmee sommige writers TrueType behandelen — een hergebruikte glyph een tweede "alias"-CID achter het einde van het font geven, zodat ToUnicode per gebruik andere tekst kan hangen. In een CFF-font selecteert zo'n alias geen glyph, en mutool meldt dat hij hem niet kan renderen. Fonts die U+4E00 en U+2F00 (KANGXI RADICAL ONE) op één outline afbeelden zijn het gebruikelijke geval. Moeten die twee in uw document verschillend extracteren, wikkel dan het voorkomen in een marked-content span met /ActualText (ISO 32000-1 §14.9.4), die een reader gebruikt in plaats van de mapping van het font
De charset ter plekke herschrijven
Er zijn twee manieren om glyph-indexcodes en een CID-keyed programma met elkaar te verzoenen. De ene vertaalt elke glyph-index naar de CID van het font voordat hij hem wegschrijft, en raakt daarmee de content stream-codes, de keys van /W, de bitposities in /CIDSet, de broncodes in ToUnicode en elke subset op het moment van opslaan. De andere verandert de ene structuur die niet meedoet, de charset, zodat het font op glyph-indices reageert zoals een name-keyed programma dat zou doen. De tweede route is de veiligste. De shaper, de breedtetabel, de subsetter en de ToUnicode-builder blijven allemaal in glyph-ruimte werken, en de enige code die CIDs hoeft te begrijpen is een korte routine die één keer over de embedded kopie van het font loopt. PDFlibPas kiest die route
De herschrijving houdt het formaat van de charset en zijn bytelengte aan. In formaat 0 wordt elke entry overschreven met zijn eigen glyph-index. In formaat 1 en 2 verandert alleen de eerste CID van elke range, en de tellingen blijven zoals ze zijn. Er groeit of krimpt niets. De Top DICT-offsets naar CharStrings, de Private DICTs, FDArray en FDSelect blijven geldig zonder iets te her-encoderen, en FDSelect — dat per glyph-index hinting-dictionaries toewijst — houdt elke glyph in zijn oorspronkelijke FD. Name-keyed programma's, predefined charsets, CFF2-tabellen (die hebben geen charset) en programma's die niet parsen worden met rust gelaten. Drie codepaden voeren de herschrijving uit:
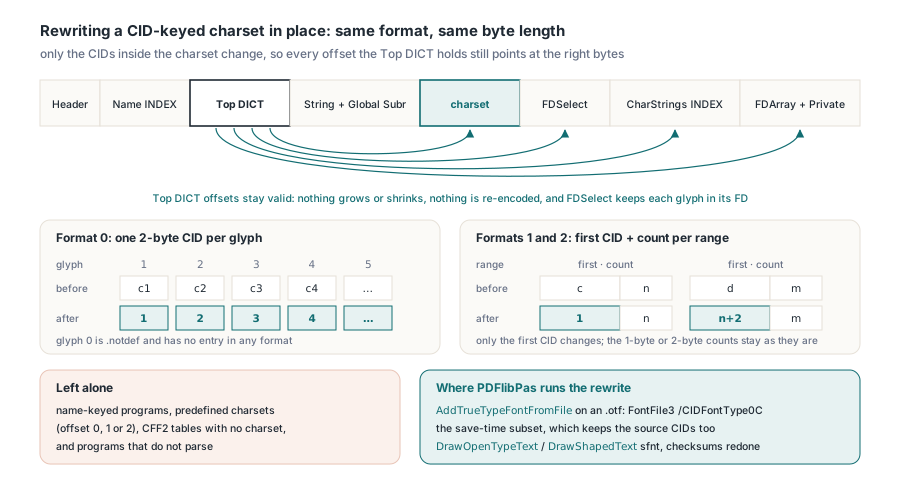
AddTrueTypeFontFromFileembedt bij een.otfde kale tabelCFFalsFontFile3met subtypeCIDFontType0C, met de charset al herschreven- De subset op het moment van opslaan houdt de oorspronkelijke glyph-indices aan maar ook de bron-CIDs, dus zijn charset wordt een tweede keer herschreven
- De shaping-companion achter
DrawOpenTypeTextenDrawShapedTexthoudt de hele sfnt vast; na de herschrijving wordt de checksum van de tabelCFFopnieuw berekend en wordt decheckSumAdjustmentvan de tabelheadgelijk aan0xB1B0AFBAminus de som van het bestand - Die adjustment is alleen gedefinieerd voor een enkel font, dus een font uit een collection krijgt uitsluitend de tabel-checksum
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // Een .otf met CFF-contouren wordt ge-embed als FontFile3 /CIDFontType0C;
    // de embedded kopie krijgt een identity-charset wanneer hij CID-keyed is
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;
Controleer de uitvoer door hem te renderen. Extractie laat het probleem niet zien. pdftotext en elke andere extractor lezen ToUnicode, dat op de code in de content stream is gebaseerd en niets weet van welke outline het font ervoor kiest, dus een pagina met de verkeerde ideogrammen extraheert nog steeds de juiste string. mutool draw -r 150 -o page%d.png noto-sc.pdf laat zien hoe de pagina er echt uitziet, en voor dit DrawText-pad hoort de pdffonts noto-sc.pdf van poppler het font als CID Type 0C te noemen. Verwacht: beide regels renderen in Noto Sans SC met de glyphs die de brontekst noemt, en in Ghostscript verschijnt dezelfde uitvoer
Welke embedding-vorm heeft PDF 1.6 nodig?
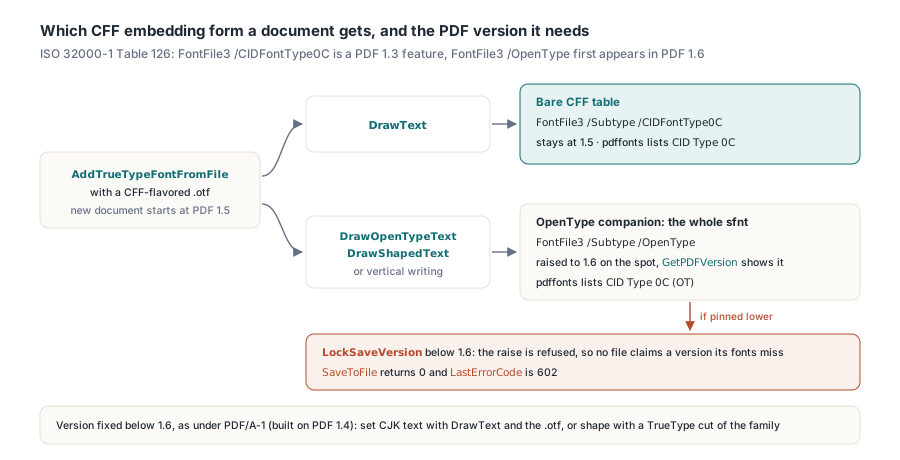
De OpenType-variant. Tabel 126 van ISO 32000-1 noemt een FontFile3-stream met subtype CIDFontType0C een PDF 1.3-feature, terwijl subtype OpenType — de hele sfnt met zijn tabel CFF — voor het eerst in PDF 1.6 opduikt. Nieuwe PDFlibPas-documenten beginnen op versie 1.5, en daar past het kale-CFF-pad van DrawText binnen. De eerste aanroep van DrawOpenTypeText, DrawShapedText of verticaal zetten met een CFF-font maakt een OpenType-companion aan en tilt het document ter plekke naar 1.6, wat GetPDFVersion meteen meldt. Een versielock verandert dat. Heeft LockSaveVersion het document lager vastgezet, dan wordt de verhoging geweigerd en geeft SaveToFile 0 terug met LastErrorCode 602, zodat geen enkel bestand een versie claimt die zijn fonts niet halen. Fixt een afleverprofiel de versie onder 1.6 — PDF/A-1 is het gebruikelijke geval, want gebouwd op PDF 1.4 — zet dan CJK-tekst via DrawText met de .otf, of gebruik een TrueType-snede van de familie voor alles wat shaping nodig heeft
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // Verwacht: 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // Verwacht: 1.6
    Lib.SaveToFile('shaped.pdf');  // Verwacht in pdffonts: CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // Verwacht: 602
  finally
    Lib.Free;
  end;
end;
Breedtes en ToUnicode op dezelfde nummers gebaseerd
Zodra de charset de identity is, zijn CID, glyph-index en content stream-code één en hetzelfde getal. De breedtes volgen. ISO 32000-1 §9.7.4.3 indexeert /W op de CID zelf, in groepen van óf een startende CID gevolgd door een array van breedtes, óf een eerste CID, een laatste CID en één gedeelde breedte, zonder de /FirstChar-offset die simpele fonts gebruiken. Elke CID die de array overslaat valt terug op /DW, en Tabel 117 zet de default voor /DW op 1000. Nul is fout. Een reader die voor niet-genoteerde CIDs op 0 terugvalt laat een regel ideogrammen op zichzelf instorten. Voor een .otf geladen via AddTrueTypeFontFromFile schrijft PDFlibPas een /W-array die bij CID 0 begint en de advance van elke glyph noemt, naast een expliciete /DW 1000. Aan de leeskant gaat CJK-tekst die als rommel extraheert meestal mis in de codespace-helft van dezelfde pipeline, en een PDF/UA-fontaudit van breedtes, CharSet en CIDSet legt deze arrays naast het embedded programma
ToUnicode heeft een eigen nummeringsregel. Een bfrange-entry slaat alleen de eerste doelstring op, en §9.10.3 eist dat zijn laatste byte door de lengte van de range niet voorbij 255 wordt geduwd, want een reader genereert de volgende doelen door alleen die laatste byte op te hogen. Opeenvolgende glyphs die naar U+4EFE, U+4EFF, U+4F00 en U+4F01 afbeelden lijken één range. Zijn ze niet: een reader zou de derde als U+4E00 decoderen. De PDFlibPas-writer voegt naburige glyph-naar-Unicode-paren alleen dan samen in één bfrange wanneer zowel de broncodes als de doelen binnen één blok van 256 blijven, en splitst de reeks anders. Verticaal CJK-zetten loopt door dezelfde companion-fonts, dus verticale Japanse en Chinese tekst erft de identity-charset en deze ToUnicode-ranges zonder extra aanroepen
Elk font dat InspectOtfCharset meldt als CID-keyed met een niet-identity charset is er een waar glyph-indexcodes en het font elkaar missen. Ge-embed via PDFlibPas for Delphi houdt zo'n font zijn contouren, offsets en charsetlengte, en wat verandert zijn de CIDs in die ene tabel, plus de checksums wanneer de hele sfnt wordt vastgehouden